
说明
转到末尾下载完整示例代码。
通过 rpy2 与 R 集成#
本示例展示如何在 Python 中用 scipy.stats.ttest_ind() 对 Epochs 数据做质量单变量双样本 t 检验,再通过 rpy2 在 R 中运行等价检验,并确认两种方法得到完全相同的结果。
rpy2 最主要的用途是利用 R 中 Python 尚未提供(或不易使用)的统计功能,但原则上它可以调用 R 生态中的任何功能。
说明
本示例要求已安装 rpy2(pip install rpy2),并具备可用的 R 环境及 stats 包(R 默认自带)。
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
加载示例数据并创建 Epochs#
我们使用 MNE 示例数据集,为两个条件创建分段:左侧听觉与右侧听觉。
import numpy as np
import rpy2.robjects as ro
from rpy2.robjects import default_converter, numpy2ri
from rpy2.robjects.conversion import localconverter
from scipy import stats

import mne

data_path = mne.datasets.sample.data_path()
raw_fname = data_path / "MEG" / "sample" / "sample_audvis_filt-0-40_raw.fif"
event_fname = data_path / "MEG" / "sample" / "sample_audvis_filt-0-40_raw-eve.fif"

raw = mne.io.read_raw_fif(raw_fname, preload=True)
events = mne.read_events(event_fname)

event_id = {"auditory/left": 1, "auditory/right": 2}
tmin, tmax = -0.2, 0.5

epochs = mne.Epochs(
    raw,
    events,
    event_id=event_id,
    tmin=tmin,
    tmax=tmax,
    baseline=(None, 0),
    preload=True,
)
Opening raw data file /home/circleci/mne_data/MNE-sample-data/MEG/sample/sample_audvis_filt-0-40_raw.fif...
    Read a total of 4 projection items:
        PCA-v1 (1 x 10²)  idle
        PCA-v2 (1 x 10²)  idle
        PCA-v3 (1 x 10²)  idle
        Average EEG reference (1 x 60)  idle
    Range : 6450 ... 48149 =     42.956 ...   320.665 secs
Ready.
Reading 0 ... 41699  =      0.000 ...   277.709 secs...
Not setting metadata
145 matching events found
Setting baseline interval to [-0.19979521315838786, 0.0] s
Applying baseline correction (mode: mean)
Created an SSP operator (subspace dimension = 4)
4 projection items activated
Using data from preloaded Raw for 145 events and 106 original time points ...
0 bad epochs dropped
可视化诱发响应#
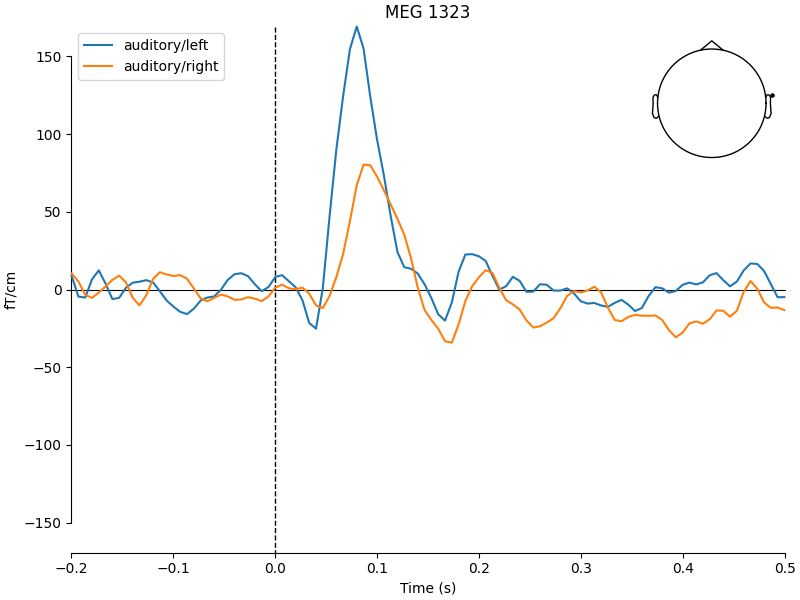
首先绘制诱发响应,为统计检验提供直观依据。左侧与右侧听觉刺激的响应应在颞侧传感器上存在差异。
evoked_left = epochs["auditory/left"].average()
evoked_right = epochs["auditory/right"].average()

mne.viz.plot_compare_evokeds(
    {"auditory/left": evoked_left, "auditory/right": evoked_right},
    picks="MEG 1323",
)
提取 ROI 数据并在 Python 中运行 t 检验#
我们选取若干颞侧传感器作为 ROI,并在这些通道及典型 N1 时间窗(80–120 ms)上取平均。这样每个分段得到一个值,是一种合理的神经科学分析方式。
roi_channels = ["MEG 1323"]
tmin_roi, tmax_roi = 0.08, 0.12

epochs.crop(tmin_roi, tmax_roi).pick(roi_channels)
epochs_left = epochs["auditory/left"].get_data().mean(axis=(1, 2))
epochs_right = epochs["auditory/right"].get_data().mean(axis=(1, 2))

t_python, p_python = stats.ttest_ind(epochs_left, epochs_right)
print(f"Python  →  t = {t_python:.4f},  p = {p_python:.4f}")
Python → t = 2.6196, p = 0.0098
通过 rpy2 在 R 中运行相同的 t 检验#
我们通过 rpy2 把相同的 NumPy 数组传给 R,并调用 R 内置的 t.test()。关于 rpy2 API,有几点需要注意:
访问 R 函数:rpy2.robjects(通常导入为 ro)的属性 r 充当 R 全局命名空间的代理。可以用类似字典的接口按名称访问任意 R 函数,例如 ro.r["t.test"] 会把 R 的 t.test 函数取为可调用的 Python 对象。
将 NumPy 数组转换为 R 向量:R 函数要求输入 R 对象,而非原始 NumPy 数组。rpy2.robjects.FloatVector 可以把一维浮点 NumPy 数组转换为 R 数值向量;在 with 块中,localconverter 上下文管理器配合 numpy2ri.converter 可自动完成转换。
传递名称中带点的参数:与 Python 不同,R 允许函数参数名包含 .,例如 var.equal。由于 var.equal 不是合法的 Python 关键字参数名,必须把它放进字典并用 ** 解包传入。
从 R 对象提取结果:R 的 t.test() 返回类列表对象,rx2 方法可按名称提取其中的元素,相当于 R 中的 $ 运算符(例如 result$statistic)。提取出的值仍是 R 向量,因此用 [0] 取出第一个(也是唯一的)元素作为 Python 标量,再用 float() 包装以确保得到普通 Python 浮点数。
with localconverter(default_converter + numpy2ri.converter):
    r_left = ro.FloatVector(epochs_left)
    r_right = ro.FloatVector(epochs_right)

r_ttest = ro.r["t.test"]
result = r_ttest(r_left, r_right, **{"var.equal": True})

t_r = float(result.rx2("statistic")[0])
p_r = float(result.rx2("p.value")[0])
print(f"R       →  t = {t_r:.4f},  p = {p_r:.4f}")
R → t = 2.6196, p = 0.0098
比较结果#
两种方法给出的 t 值与 p 值相同(在浮点精度范围内),说明 R 与 Python 的结果等价。
t difference: 0.00e+00
p difference: 1.73e-18
脚本总运行时间:(0 分 1.149 秒)