
说明
转到末尾下载完整示例代码。
Evoked 数据结构:诱发/平均数据#
本教程介绍创建和使用诱发数据(evoked data)的基础知识,详细讲解 Evoked 数据结构,包括如何从 Evoked 对象加载、查询、选取子集、导出和绘制数据。有关从 NumPy 数组中的(可能是模拟的)数据创建 Evoked 对象的详细信息,请参阅 从零创建 MNE-Python 数据结构。
和往常一样,我们首先导入所需的模块:
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import mne
从 Epochs 创建 Evoked 对象#
Evoked 对象通常存储对多个 epoch 取平均后的 EEG 或 MEG 信号,这是估计刺激诱发活动的常用技术。Evoked 对象中的数据存储在形状为 (n_channels, n_times) 的数组中(与之不同,Epochs 对象存储的数据形状为 (n_epochs, n_channels, n_times))。因此,要创建 Evoked 对象,我们先对原始数据进行分段(epoching),然后将同一条件的所有 epoch 平均在一起:
root = mne.datasets.sample.data_path() / "MEG" / "sample"
raw_file = root / "sample_audvis_raw.fif"
raw = mne.io.read_raw_fif(raw_file, verbose=False)

events = mne.find_events(raw, stim_channel="STI 014")
# we'll skip the "face" and "buttonpress" conditions to save memory
event_dict = {
    "auditory/left": 1,
    "auditory/right": 2,
    "visual/left": 3,
    "visual/right": 4,
}
epochs = mne.Epochs(raw, events, tmin=-0.3, tmax=0.7, event_id=event_dict, preload=True)
evoked = epochs["auditory/left"].average()

del raw  # reduce memory usage
Finding events on: STI 014
320 events found on stim channel STI 014
Event IDs: [ 1  2  3  4  5 32]
Not setting metadata
289 matching events found
Setting baseline interval to [-0.2996928197375818, 0.0] s
Applying baseline correction (mode: mean)
Created an SSP operator (subspace dimension = 3)
3 projection items activated
Loading data for 289 events and 601 original time points ...
0 bad epochs dropped
你可能已经注意到,MNE 提示我们已应用“基线校正”(baseline correction)。这在创建 Epochs 对象时会自动发生,但也可以手动启用(或禁用)。我们稍后会详细讨论这一点。
Epochs 的基线区间信息会传递给由它派生出的 Evoked 对象,以便在处理数据时保留溯源信息:
print(f"Epochs baseline: {epochs.baseline}")
print(f"Evoked baseline: {evoked.baseline}")
Epochs baseline: (-0.2996928197375818, 0.0)
Evoked baseline: (-0.2996928197375818, 0.0)
Evoked 对象的基本可视化#
我们可以使用 plot() 方法可视化左侧听觉刺激的平均诱发响应,该方法会为每种通道类型生成蝴蝶图(可交互的蝴蝶图):
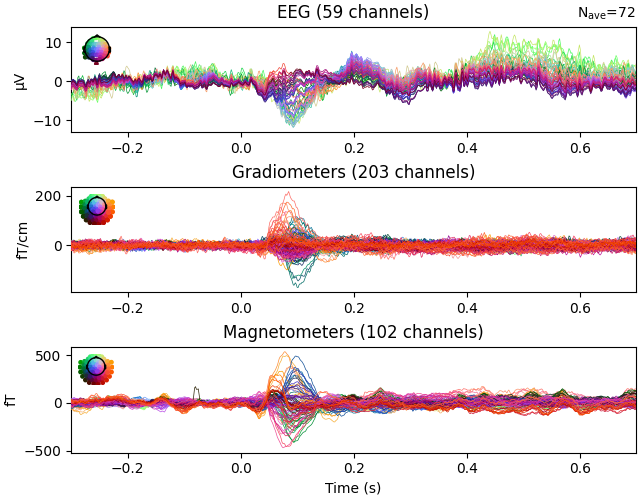
与 Raw 和 Epochs 对象的 plot() 方法一样,evoked.plot() 有许多用于自定义绘图输出的参数,例如按头皮位置为通道轨迹着色,或在通道轨迹旁绘制全局场强(global field power)。有关可视化 Evoked 对象的更多信息,请参阅 可视化 Evoked 数据。
选取 Evoked 数据子集#
与 Raw 和 Epochs 对象不同,Evoked 对象不支持通过方括号索引进行选择。不过,可以通过索引 data 属性来选取数据子集:
print(evoked.data[:2, :3]) # first 2 channels, first 3 timepoints
[[ 5.72160572e-13  3.57859354e-13  3.98040833e-13]
 [-2.75128428e-13 -3.15309907e-13 -5.83186429e-13]]
若要按以秒为单位的时间进行选择,time_as_index() 方法会很有用;但要注意,根据采样频率的不同,给定时长内包含的样本数并不总是相同(详见 Raw 数据教程中的 Time, sample number, and sample index 一节)。
选择、删除和重排通道#
默认情况下,从 Epochs 对象创建 Evoked 数据时,只会保留主要数据通道:eog、ecg、stim 和 misc 通道类型将被丢弃。可以通过 epochs.average() 的 picks 参数控制保留哪些通道类型:传入 'all' 可保留所有通道,也可以传入整数列表、通道名称列表或通道类型列表。详见 average() 的文档。
如果已经创建了 Evoked 对象,可以使用 pick()、pick_channels()、pick_types() 和 drop_channels() 方法来修改 Evoked 对象中包含的通道。也可以为此使用 reorder_channels();未提供给 reorder_channels() 的任何通道名称都将被丢弃。请注意,通道选择方法会就地修改对象,因此在交互式/探索性会话中,你可能希望先调用 copy() 创建副本。
evoked_eeg = evoked.copy().pick(picks="eeg")
print(evoked_eeg.ch_names)

new_order = ["EEG 002", "MEG 2521", "EEG 003"]
evoked_subset = evoked.copy().reorder_channels(new_order)
print(evoked_subset.ch_names)
['EEG 001', 'EEG 002', 'EEG 003', 'EEG 004', 'EEG 005', 'EEG 006', 'EEG 007', 'EEG 008', 'EEG 009', 'EEG 010', 'EEG 011', 'EEG 012', 'EEG 013', 'EEG 014', 'EEG 015', 'EEG 016', 'EEG 017', 'EEG 018', 'EEG 019', 'EEG 020', 'EEG 021', 'EEG 022', 'EEG 023', 'EEG 024', 'EEG 025', 'EEG 026', 'EEG 027', 'EEG 028', 'EEG 029', 'EEG 030', 'EEG 031', 'EEG 032', 'EEG 033', 'EEG 034', 'EEG 035', 'EEG 036', 'EEG 037', 'EEG 038', 'EEG 039', 'EEG 040', 'EEG 041', 'EEG 042', 'EEG 043', 'EEG 044', 'EEG 045', 'EEG 046', 'EEG 047', 'EEG 048', 'EEG 049', 'EEG 050', 'EEG 051', 'EEG 052', 'EEG 053', 'EEG 054', 'EEG 055', 'EEG 056', 'EEG 057', 'EEG 058', 'EEG 059', 'EEG 060']
['EEG 002', 'MEG 2521', 'EEG 003']
核心数据结构之间的相似之处#
Evoked 对象与 Raw、Epochs 对象有许多相似之处,包括:
它们可以以
.fif格式从磁盘加载或保存到磁盘,其数据可以导出为NumPy数组(但需通过data属性,而不是get_data()方法)。还可以通过to_data_frame()方法导出为 Pandas DataFrame。可以使用
evoked.rename_channels()或evoked.set_channel_types()更改通道的名称或类型。这两个方法都接受字典,其中键是现有通道名称,值是该通道的新名称(或类型)。未包含在字典中的现有通道将保持不变。可以通过
add_proj()、del_proj()和plot_projs_topomap()方法以及proj属性来操作 SSP 投影器(projector)。有关 SSP 的更多信息,请参阅 使用 SSP 修复伪迹。与
Raw和Epochs对象一样,Evoked对象具有copy()、crop()、time_as_index()、filter()和resample()方法。与
Raw和Epochs对象一样,Evoked对象具有evoked.times、evoked.ch_names和info属性。
加载和保存 Evoked 数据#
单个 Evoked 对象可以使用 evoked.save() 方法保存到磁盘。Evoked 对象与其他数据结构的一个区别是,可以使用 mne.write_evokeds() 将多个 Evoked 对象保存到同一个 .fif 文件中。示例数据中就包含这样一个 .fif 文件:数据已经过分段和平均,文件中为每个实验条件分别保存了 Evoked 对象:
evk_file = root / "sample_audvis-ave.fif"
evokeds_list = mne.read_evokeds(evk_file, verbose=False)
print(evokeds_list)
print(type(evokeds_list))
[<Evoked | 'Left Auditory' (average, N=55), -0.1998 – 0.49949 s, baseline off, 376 ch, ~4.4 MiB>, <Evoked | 'Right Auditory' (average, N=61), -0.1998 – 0.49949 s, baseline off, 376 ch, ~4.4 MiB>, <Evoked | 'Left visual' (average, N=67), -0.1998 – 0.49949 s, baseline off, 376 ch, ~4.4 MiB>, <Evoked | 'Right visual' (average, N=58), -0.1998 – 0.49949 s, baseline off, 376 ch, ~4.4 MiB>]
<class 'list'>
注意,mne.read_evokeds() 返回了一个 Evoked 对象列表,每个对象都有一个 evoked.comment 属性,用于描述生成该估计值时所平均的实验条件:
for evok in evokeds_list:
    print(evok.comment)
Left Auditory
Right Auditory
Left visual
Right visual
如果只想加载 .fif 文件中的部分条件,read_evokeds() 提供了 condition 参数,该参数可以是字符串(与磁盘上 Evoked 对象的 comment 属性匹配),也可以是整数(根据 Evoked 对象在文件中的存储顺序进行选择)。也可以传入整数或字符串列表。如果只选择了一个对象,将直接返回该 Evoked 对象(而不是放在长度为 1 的列表中):
right_vis = mne.read_evokeds(evk_file, condition="Right visual")
print(right_vis)
print(type(right_vis))
Reading /home/circleci/mne_data/MNE-sample-data/MEG/sample/sample_audvis-ave.fif ...
    Read a total of 4 projection items:
        PCA-v1 (1 x 10²) active
        PCA-v2 (1 x 10²) active
        PCA-v3 (1 x 10²) active
        Average EEG reference (1 x 60) active
    Found the data of interest:
        t =    -199.80 ...     499.49 ms (Right visual)
        0 CTF compensation matrices available
        nave = 58 - aspect type = 100
Projections have already been applied. Setting proj attribute to True.
No baseline correction applied
<Evoked | 'Right visual' (average, N=58), -0.1998 – 0.49949 s, baseline off, 376 ch, ~4.4 MiB>
<class 'mne.evoked.Evoked'>
此前,当我们通过平均 epoch 创建 Evoked 对象时,从 Raw 对象中提取 epoch 会默认应用基线校正(默认基线区间为 (None, 0),这可确保刺激事件之前的时间点均值为零)。相比之下,如果绘制从磁盘加载的列表中的第一个 Evoked 对象,我们会发现数据尚未进行基线校正:
evokeds_list[0].plot(picks="eeg")
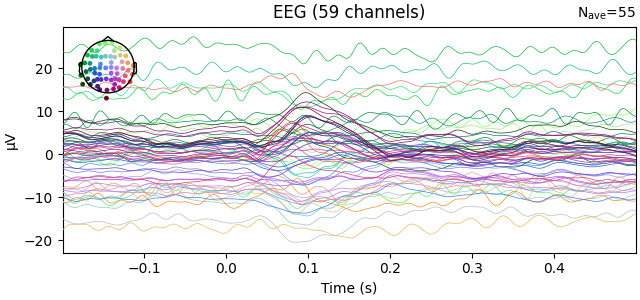
可以通过向 mne.read_evokeds() 传递 baseline 参数,或者在加载后应用基线校正来解决这个问题,如下所示:
# Original baseline (none set)
print(f"Baseline after loading: {evokeds_list[0].baseline}")

# Apply a custom baseline correction
evokeds_list[0].apply_baseline((None, 0))
print(f"Baseline after calling apply_baseline(): {evokeds_list[0].baseline}")

# Visualize the evoked response
evokeds_list[0].plot(picks="eeg")
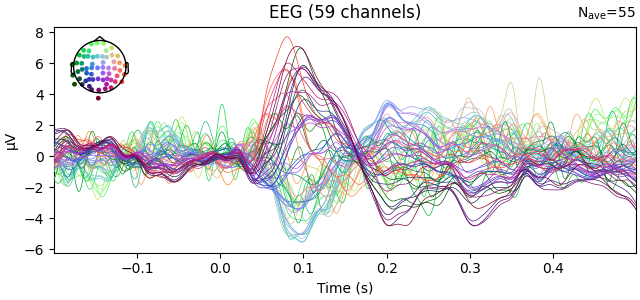
Baseline after loading: None
Applying baseline correction (mode: mean)
Baseline after calling apply_baseline(): (-0.19979521315838786, 0.0)
注意,apply_baseline() 是就地操作的。类似地,Evoked 对象在保存到磁盘时可能已应用或未应用投影器;可以向 read_evokeds() 函数传入 proj=True,或在加载后使用 apply_proj() 方法。
合并 Evoked 对象#
在估计诱发响应时,跨多个条件汇总数据的一种方法是在平均之前进行汇总(回想一下,MNE-Python 可以根据以 / 分隔的 epoch 标签的部分匹配进行选择;更多信息请参阅 Subselecting epochs):
left_right_aud = epochs["auditory"].average()
left_right_aud
这种方法会让每个 epoch 具有相同权重,并创建一个 Evoked 对象。注意,打印出的表示中包含 (average, N=145),表明该 Evoked 对象是对 145 个 epoch 取平均得到的。在本例中,各事件类型的数量相当接近:
[72, 73]
然而,情况并非总是如此。如果出于统计原因需要从不同条件中平均相同数量的 epoch,可以在平均之前使用 equalize_event_counts()。
跨条件汇总的另一种方法是为每个条件分别创建 Evoked 对象,然后再将它们合并。这可以通过 mne.combine_evoked() 函数完成,它会对传入的 Evoked 对象计算加权和。权重可以手动指定为浮点数列表或数组,也可以使用关键字 'equal'(将每个 Evoked 对象的权重设为 \(\frac{1}{N}\),其中 \(N\) 是传入的 Evoked 对象数量)或关键字 'nave'(根据创建每个 Evoked 对象时所平均的 epoch 数量按比例加权):
left_right_aud = mne.combine_evoked([left_aud, right_aud], weights="nave")
assert left_right_aud.nave == left_aud.nave + right_aud.nave
请注意,所得 Evoked 对象的 nave 属性将反映有效平均次数,它同时取决于各参与 Evoked 对象的 nave 属性以及合并时使用的权重。跟踪有效 nave 对逆成像(inverse imaging)很重要,因为 nave 用于缩放噪声协方差估计,进而影响估计的源活动幅度(更多信息请参阅 The minimum-norm current estimates,尤其是 Whitening and scaling 一节)。请注意,mne.grand_average() 不会调整 nave 来反映有效平均 epoch 数;它只是将 nave 设置为参与平均的 evoked 数量。因此,如果打算对所得的 Evoked 对象进行逆成像,最好使用 mne.combine_evoked(),而不是 mne.grand_average()。
Evoked 对象的其他用途#
尽管 Evoked 对象最常见的用途是存储分段数据的平均值,但这里还有几种其他用途值得注意。首先,epochs.standard_error() 方法会创建一个 Evoked 对象(就像 epochs.average() 那样),但该 Evoked 对象中的数据是跨 epoch 的标准误,而不是平均值。为表明这一差异,Evoked 对象具有 kind 属性,其取值会相应为 'average' 或 'standard error'。
Evoked 对象的另一种用途是表示单个试次或单个 epoch 的数据,通常是在遍历 epoch 时使用。这可以通过 epochs.iter_evoked() 方法轻松实现,对于只想执行 Evoked 对象才支持的操作的应用很有用。例如,这里我们使用 get_peak() 方法(Epochs 对象没有此方法)来获取每个试次的峰值响应:
for ix, trial in enumerate(epochs[:3].iter_evoked()):
    channel, latency, value = trial.get_peak(ch_type="eeg", return_amplitude=True)
    latency = int(round(latency * 1e3))  # convert to milliseconds
    value = int(round(value * 1e6))  # convert to µV
    print(f"Trial {ix}: peak of {value} µV at {latency} ms in channel {channel}")
Trial 0: peak of 159 µV at 35 ms in channel EEG 003
Trial 1: peak of -45 µV at 569 ms in channel EEG 005
Trial 2: peak of -46 µV at 648 ms in channel EEG 015
脚本总运行时间:(0 分钟 2.743 秒)