
注意
转到末尾下载完整示例代码。
自动生成 Epochs 元数据#
本教程展示如何基于事件,通过 mne.epochs.make_metadata 为 Epochs 自动生成元数据。
我们将使用 ERP CORE 数据集(源自 [1])中的数据。这是一名被试在执行主动视觉任务(Eriksen 侧抑制任务)时记录的 EEG 数据。
注意
如果你想跳过本教程的入门部分,可以在完成“准备工作”部分的数据导入与事件创建后,直接跳到“应用所学:可视化 ERN 成分”。
本教程大致分为两部分:
我们首先关注产生以视觉刺激为时间锁定的 ERP,并以反应正确性和反应时间为条件,以便熟悉
make_metadata函数。随后,我们将计算以反应为时间锁定的 ERP——同样以反应正确性为条件——以可视化错误相关负波(error-related negativity,ERN),即与错误行为反应相关的 ERP 成分。
准备工作#
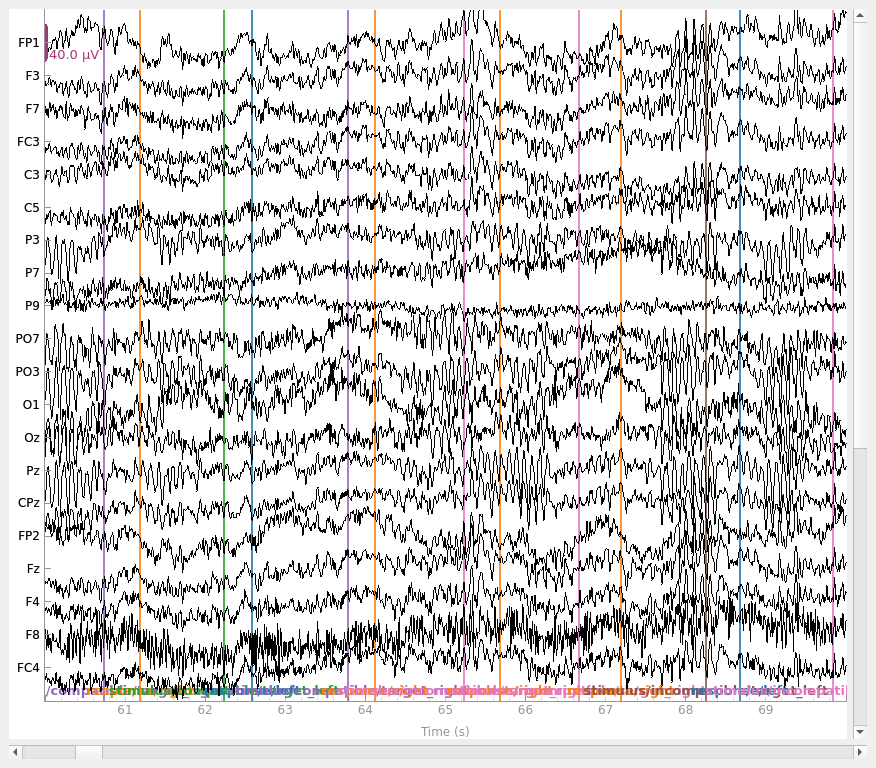
我们先读取、滤波并对原始数据做简单可视化。该数据相当干净,眨眼很少,因此无需进行复杂的预处理与数据清洗。我们还会通过调用 mne.events_from_annotations,把该数据集中包含的 Annotations 转换为事件。
# Authors: Richard Höchenberger <richard.hoechenberger@gmail.com>
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import matplotlib.pyplot as plt

import mne

data_dir = mne.datasets.erp_core.data_path()
infile = data_dir / "ERP-CORE_Subject-001_Task-Flankers_eeg.fif"

raw = mne.io.read_raw(infile, preload=True)
raw.filter(l_freq=0.1, h_freq=40)
raw.plot(start=60)

# extract events
all_events, all_event_id = mne.events_from_annotations(raw)
Opening raw data file /home/circleci/mne_data/MNE-ERP-CORE-data/ERP-CORE_Subject-001_Task-Flankers_eeg.fif...
    Range : 0 ... 935935 =      0.000 ...   913.999 secs
Ready.
Reading 0 ... 935935  =      0.000 ...   913.999 secs...
Filtering raw data in 1 contiguous segment
Setting up band-pass filter from 0.1 - 40 Hz

FIR filter parameters
---------------------
Designing a one-pass, zero-phase, non-causal bandpass filter:
- Windowed time-domain design (firwin) method
- Hamming window with 0.0194 passband ripple and 53 dB stopband attenuation
- Lower passband edge: 0.10
- Lower transition bandwidth: 0.10 Hz (-6 dB cutoff frequency: 0.05 Hz)
- Upper passband edge: 40.00 Hz
- Upper transition bandwidth: 10.00 Hz (-6 dB cutoff frequency: 45.00 Hz)
- Filter length: 33793 samples (33.001 s)

Used Annotations descriptions: ['response/left', 'response/right', 'stimulus/compatible/target_left', 'stimulus/compatible/target_right', 'stimulus/incompatible/target_left', 'stimulus/incompatible/target_right']
从事件创建元数据#
make_metadata 基础#
现在该考虑用于分段和生成元数据的时间窗口了。需要理解的是,这些时间窗口不必相同!也就是说,自动生成的元数据可能只包含 epoch 持续时间中一小部分时间内的事件信息,也可能包含完全发生在某个 epoch 之外的事件。
让我们看一个具体例子。在 ERP CORE 数据集的 Flankers 任务中,被试需要通过按键对视觉刺激作出反应。我们感兴趣的是反应正确试次中的视觉诱发响应(ERP)。假设依据文献研究,我们认定刺激呈现后 1500 ms 之后的反应应视为无效,因为它们并未反映此处关注的神经过程。借助 mne.epochs.make_metadata,我们可以按如下方式实现:
# metadata for each epoch shall include events from the range: [0.0, 1.5] s,
# i.e. starting with stimulus onset and expanding beyond the end of the epoch
metadata_tmin, metadata_tmax = 0.0, 1.5

# auto-create metadata:
# this also returns a new events array and an event_id dictionary. we'll see
# later why this is important
metadata, events, event_id = mne.epochs.make_metadata(
    events=all_events,
    event_id=all_event_id,
    tmin=metadata_tmin,
    tmax=metadata_tmax,
    sfreq=raw.info["sfreq"],
)

# let's look at what we got!
metadata
指定时间锁定事件#
可以看到,生成的表格有 802 行,每一行对应 all_events 中的一个事件。第一列 event_name 包含该行元数据所围绕的事件名称——我们称之为“时间锁定事件”,因为我们会把它的时间点设为零。
其余列的名称对应于 all_event_id 字典中指定的事件名称。这些列包含浮点数;其数值表示该事件相对于时间锁定事件(即 event_name 列中提到的那个事件)的潜伏期,单位为秒。对于未在给定时间窗口内发生的事件,你会看到 NaN 值,这仅表示无法提取该事件的潜伏期。
但这里有个问题。我们希望以反应为条件来研究视觉 ERP。然而刚刚创建的元数据为每个事件都包含一行,包括反应事件。虽然我们可以为所有事件创建 epoch、传入这些元数据,之后再对创建的事件取子集,但有更优雅的处理方式:make_metadata 有一个 row_events 参数,可以指定为哪些事件创建元数据行,同时仍为 event_id 字典中的所有事件创建列。
由于此时元数据只涉及原始事件的一个子集,在真正创建 epoch 时务必保留返回的 events 和 event_id 以供后续使用,以确保元数据、事件与事件描述保持同步。
row_events = [
    "stimulus/compatible/target_left",
    "stimulus/compatible/target_right",
    "stimulus/incompatible/target_left",
    "stimulus/incompatible/target_right",
]

metadata, events, event_id = mne.epochs.make_metadata(
    events=all_events,
    event_id=all_event_id,
    tmin=metadata_tmin,
    tmax=metadata_tmax,
    sfreq=raw.info["sfreq"],
    row_events=row_events,
)

metadata
仅保留一组事件中的首个事件#
现在元数据包含 400 行——每个刺激一行——列数与之前相同。很好!
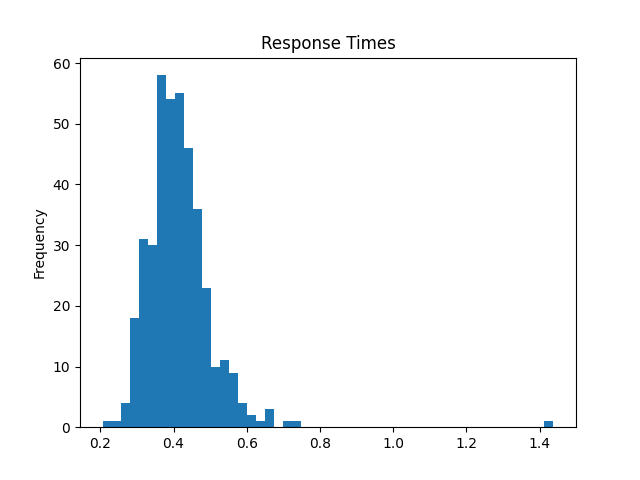
我们的数据中有两类反应:response/left 和 response/right。我们希望把它们映射为“正确”和“错误”。为简化操作,我们可以要求 make_metadata 生成一个全新的列,指向给定时间区间内观察到的第一个反应。做法是通过 keep_first 参数传入用于命名事件的分层事件描述符(hierarchical event descriptors,HED,受 [2] 启发)的一个子集。例如,对于 HED response/left 和 response/right,我们可以传入 keep_first='response' 来生成一个新列 response,其中包含相应事件的潜伏期。该值表示第一个(在这个具体例子中也是唯一的)反应,而不论是哪一侧(左或右)。为指明匹配到的是哪种事件类型(这里是反应侧),还会添加一个名为 first_response 的第二列。该列的值是去掉用于匹配的字符串后的事件类型——因为该字符串已作为列名编码,即在我们的例子中,预期它只包含 'left' 和 'right'。
keep_first = "response"
metadata, events, event_id = mne.epochs.make_metadata(
    events=all_events,
    event_id=all_event_id,
    tmin=metadata_tmin,
    tmax=metadata_tmax,
    sfreq=raw.info["sfreq"],
    row_events=row_events,
    keep_first=keep_first,
)

# visualize response times regardless of side
metadata["response"].plot.hist(bins=50, title="Response Times (first response)")
first_response 列只包含 "left" 和 "right" 条目,它们分别来自最初的 "response/left" 和 "response/right" 事件:
print(metadata["first_response"])
2       left
4       left
6      right
8       left
10      left
       ...
792     left
794    right
796     left
798    right
800     left
Name: first_response, Length: 400, dtype: object
对于刺激事件,不止两种,而是有四种不同类型:stimulus/compatible/target_left、stimulus/compatible/target_right、stimulus/incompatible/target_left 和 stimulus/incompatible/target_right。更有甚者,由于本范式中刺激是快速连续呈现的,有时在用于生成元数据的 1.5 秒时间窗口内会出现多个刺激事件。例如:
metadata.loc[
    metadata["stimulus/compatible/target_left"].notna()
    & metadata["stimulus/compatible/target_right"].notna(),
    :,
]
查看 stimulus/compatible/target_left 和 stimulus/compatible/target_right 列,你会发现两者总是包含数值(一个总为零,另一个不为零)。这是因为这两个事件都发生在 1.5 秒的时间窗口内。
这在后续处理阶段很容易引起混淆,因此我们为第一个刺激创建一列——由于我们的时间区间从 0 秒开始,它始终就是时间锁定的那个刺激。我们可以向 keep_first 传入一个字符串列表。
keep_first = ["stimulus", "response"]
metadata, events, event_id = mne.epochs.make_metadata(
    events=all_events,
    event_id=all_event_id,
    tmin=metadata_tmin,
    tmax=metadata_tmax,
    sfreq=raw.info["sfreq"],
    row_events=row_events,
    keep_first=keep_first,
)

# all times of the time-locked events should be zero
assert all(metadata["stimulus"] == 0)

# the values in the new "first_stimulus" and "first_response" columns indicate
# which events were selected via "keep_first"
metadata[["first_stimulus", "first_response"]]
添加新列以描述刺激侧与反应正确性#
很好!现在该确定哪些反应是正确的、哪些是错误的。我们首先添加一列来编码刺激呈现的一侧,然后只需检查反应是否与刺激侧匹配,并将结果添加到另一列。
metadata.loc[:, "stimulus_side"] = ""  # initialize column

# left-side stimulation
metadata.loc[
    metadata["first_stimulus"].isin(
        ["compatible/target_left", "incompatible/target_left"]
    ),
    "stimulus_side",
] = "left"

# right-side stimulation
metadata.loc[
    metadata["first_stimulus"].isin(
        ["compatible/target_right", "incompatible/target_right"]
    ),
    "stimulus_side",
] = "right"

# first assume all responses were incorrect, then mark those as correct where
# the stimulation side matches the response side
metadata["response_correct"] = False
metadata.loc[
    metadata["stimulus_side"] == metadata["first_response"], "response_correct"
] = True

metadata
统计正确与错误反应的次数:
correct_response_count = metadata["response_correct"].sum()
print(
    f"Correct responses: {correct_response_count}\n"
    f"Incorrect responses: {len(metadata) - correct_response_count}"
)
Correct responses: 346
Incorrect responses: 54
创建带元数据的 Epochs 并可视化 ERP#
元数据已就绪。现在终于可以创建 epoch 了!我们将通过 metadata 参数在创建 epoch 时直接指定元数据。此外,切记要传入 make_metadata 返回的 events 和 event_id,因为我们通过 row_events 只为原始事件的一个子集创建了元数据。如果改为传入“原始”的值,元数据的长度与 epoch 数量将不匹配,从而引发错误。
epochs_tmin, epochs_tmax = -0.1, 0.4  # epochs range: [-0.1, 0.4] s
reject = {"eeg": 250e-6}  # exclude epochs with strong artifacts
epochs = mne.Epochs(
    raw=raw,
    tmin=epochs_tmin,
    tmax=epochs_tmax,
    events=events,
    event_id=event_id,
    metadata=metadata,
    reject=reject,
    preload=True,
)
Adding metadata with 13 columns
400 matching events found
Setting baseline interval to [-0.099609375, 0.0] s
Applying baseline correction (mode: mean)
0 projection items activated
Using data from preloaded Raw for 400 events and 513 original time points ...
    Rejecting  epoch based on EEG : ['F8']
    Rejecting  epoch based on EEG : ['F8']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['F8']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['F8']
9 bad epochs dropped
你可能还注意到有 9 个 epoch 因超出剔除阈值而被丢弃。这也是为什么应在创建 epoch 时指定元数据的另一个原因:元数据会自动更新,以反映实际保留的 epoch。
最后,我们可视化与视觉刺激相关的 ERP。我们只考虑反应正确的试次,并生成三幅图:一幅对应所有正确反应,一幅对应正确但较慢的反应(反应时间慢于 0.5 s),还有一幅对应正确且较快的反应(反应时间不超过 0.5 s)。
vis_erp = epochs["response_correct"].average()
vis_erp_slow = epochs["(response_correct) & (response > 0.5)"].average()
vis_erp_fast = epochs["(response_correct) & (response <= 0.5)"].average()

fig, ax = plt.subplots(3, figsize=(6, 8), layout="constrained")
vis_erp.plot(gfp=True, spatial_colors=True, axes=ax[0], show=False)
vis_erp_slow.plot(gfp=True, spatial_colors=True, axes=ax[1], show=False)
vis_erp_fast.plot(gfp=True, spatial_colors=True, axes=ax[2], show=False)

# Set titles
ax[0].set_title("All Correct Responses")
ax[1].set_title("Slow Correct Responses")
ax[2].set_title("Fast Correct Responses")
fig.suptitle("Visual ERPs", fontweight="bold")

# Turn of x axes for the first two plots
ax[0].xaxis.set_visible(False)
ax[1].xaxis.set_visible(False)
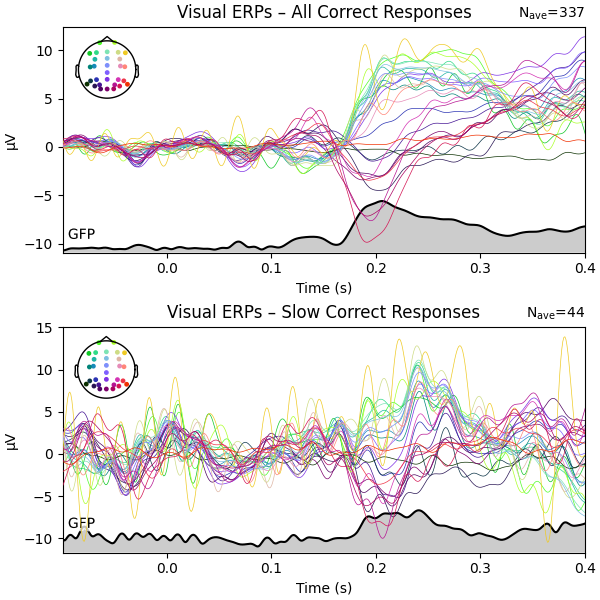
除了(数量少得多的)慢反应数据看起来更嘈杂——这完全在预料之中——之外,看不出太大的 ERP 差异。
应用所学:可视化 ERN 成分#
在接下来的分析中,我们将使用与上面相同的数据集,但把 epoch 的时间锁定到反应事件,而不是刺激起始。比较正确与错误行为反应相关的 ERP,我们应该能在差异波中看到错误相关负波(ERN)。
由于我们希望把分析时间锁定到反应,因此在自动生成元数据时,我们考虑在反应触发前最多 1500 ms 内发生的事件,以确保也能捕捉到刺激事件。
我们只想考虑每个时间窗口中的最后一个刺激和最后一个反应:请记住,在本范式中刺激呈现非常快;取最后一个反应(时间点 0)和最后一个刺激(最接近反应的那个)可以确保我们建立正确的刺激—反应配对。为此可以传入 keep_last 参数,它的作用与之前使用的 keep_first 完全相同,只是保留指定事件的最后几次出现,并存储在名称以 last_ 开头的列中。
metadata_tmin, metadata_tmax = -1.5, 0
row_events = ["response/left", "response/right"]
keep_last = ["stimulus", "response"]

metadata, events, event_id = mne.epochs.make_metadata(
    events=all_events,
    event_id=all_event_id,
    tmin=metadata_tmin,
    tmax=metadata_tmax,
    sfreq=raw.info["sfreq"],
    row_events=row_events,
    keep_last=keep_last,
)

metadata
与上一个例子完全相同,我们创建新列 stimulus_side 和 response_correct。
metadata.loc[:, "stimulus_side"] = ""  # initialize column

# left-side stimulation
metadata.loc[
    metadata["last_stimulus"].isin(
        ["compatible/target_left", "incompatible/target_left"]
    ),
    "stimulus_side",
] = "left"

# right-side stimulation
metadata.loc[
    metadata["last_stimulus"].isin(
        ["compatible/target_right", "incompatible/target_right"]
    ),
    "stimulus_side",
] = "right"

# first assume all responses were incorrect, then mark those as correct where
# the stimulation side matches the response side
metadata["response_correct"] = False
metadata.loc[
    metadata["stimulus_side"] == metadata["last_response"], "response_correct"
] = True

metadata
现在该对数据分段了!在决定这一具体分析的 epoch 时长时,需要确保包含运动反应前后相当长的信号。同时必须意识到,与运动/肌肉相关的信号很可能在反应按键触发脉冲出现在数据中之前就已存在,因此靠近反应事件的时间段不应用于基线校正。但与此同时,我们也不希望基线期离按键事件太远。下面的取值似乎效果不错。请记住:时间点 0 是反应事件。
epochs_tmin, epochs_tmax = -0.6, 0.4
baseline = (-0.4, -0.2)
reject = {"eeg": 250e-6}
epochs = mne.Epochs(
    raw=raw,
    tmin=epochs_tmin,
    tmax=epochs_tmax,
    baseline=baseline,
    reject=reject,
    events=events,
    event_id=event_id,
    metadata=metadata,
    preload=True,
)
Adding metadata with 13 columns
402 matching events found
Applying baseline correction (mode: mean)
0 projection items activated
Using data from preloaded Raw for 402 events and 1025 original time points ...
    Rejecting  epoch based on EEG : ['F8']
    Rejecting  epoch based on EEG : ['FP1', 'F7', 'FP2']
    Rejecting  epoch based on EEG : ['F7', 'F8', 'FC4']
    Rejecting  epoch based on EEG : ['FC3', 'F4', 'FC4']
    Rejecting  epoch based on EEG : ['FP1']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['F8']
    Rejecting  epoch based on EEG : ['F8']
    Rejecting  epoch based on EEG : ['FP2', 'F8']
    Rejecting  epoch based on EEG : ['FP1', 'F3', 'F7', 'FC3', 'C3', 'C5', 'P3', 'CPz', 'Fz', 'F4', 'F8', 'FC4', 'FCz', 'Cz', 'C4', 'P4']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2', 'F8']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP1', 'FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP2']
    Rejecting  epoch based on EEG : ['FP2', 'F8']
    Rejecting  epoch based on EEG : ['F8']
36 bad epochs dropped
让我们做最后一次检查:确保每一行中确实都有刺激。我们使用 epochs.metadata(而不是 metadata),因为创建 epoch 时传入了 reject 参数,而 MNE-Python 始终确保 epochs.metadata 与可用的 epoch 保持同步。创建 epoch 期间,有几个 epoch 因超出剔除阈值而被丢弃。
epochs.metadata.loc[epochs.metadata["last_stimulus"].isna(), :]
糟糕!看起来最开始的两个反应是在第一个刺激出现之前记录的:stimulus 列中的值为 None。有一种非常简单的方法可以只选择确实有刺激(即不为 None)的 epoch:
现在该计算正确与错误反应的 ERP 了。
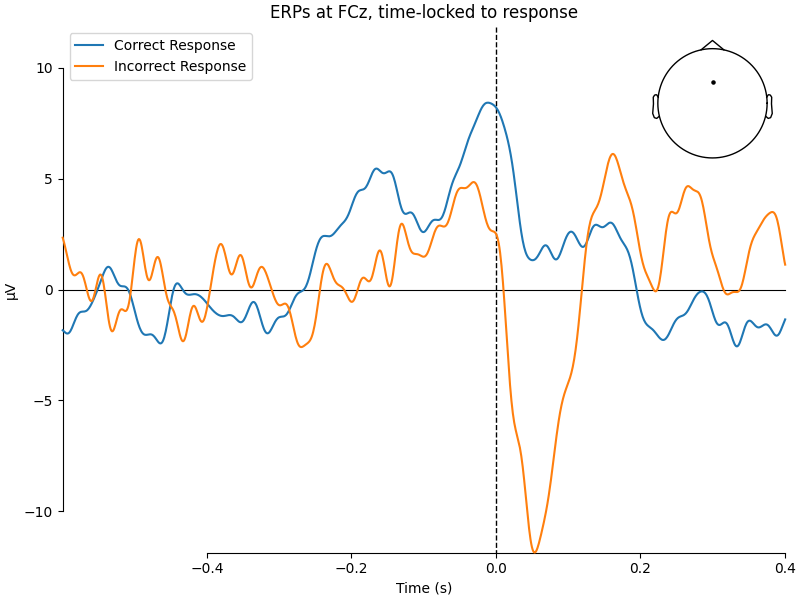
在可视化时,我们只看传感器 FCz,已知它在给定范式中能很好地体现 ERN。
resp_erp_correct = epochs["response_correct"].average()
resp_erp_incorrect = epochs["not response_correct"].average()

mne.viz.plot_compare_evokeds(
    {"Correct Response": resp_erp_correct, "Incorrect Response": resp_erp_incorrect},
    picks="FCz",
    show_sensors=True,
    title="ERPs at FCz, time-locked to response",
)
我们还会绘制地形图,以了解错误反应后最初 100 ms 内测得的平均头皮电位。
# topoplot of average field from time 0.0-0.1 s
fig = resp_erp_incorrect.plot_topomap(times=0.05, average=0.1, size=3)
fig.suptitle("Mean topography after incorrect responses", fontsize=14)
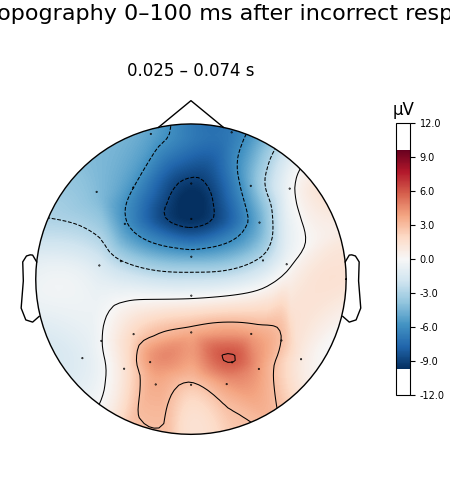
我们可以看到,与正确反应相比,错误反应之后立即出现强烈的负向偏转。地形图也毫无疑问地表明:我们所看到的正是 ERN。
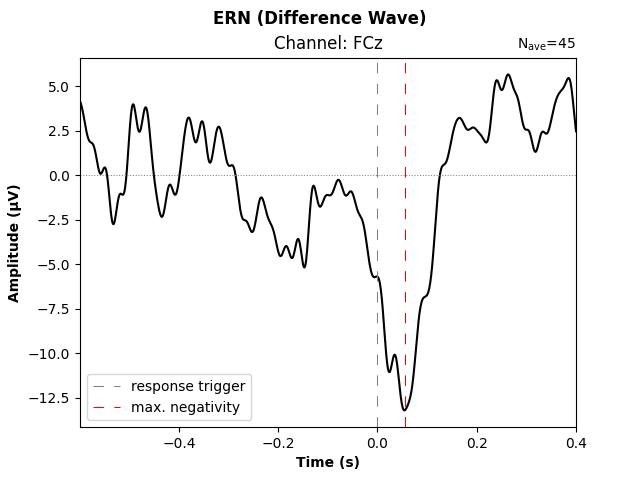
一些研究者建议构建正确与错误反应 ERP 之间的差异波,因为它能更清晰地揭示信号差异,同时(在“正确”与“错误”试次的噪声水平相似的假设下)理想情况下还能提高信噪比。我们就这么做,并生成一幅可直接用于发表的图。
# difference wave: incorrect minus correct responses
resp_erp_diff = mne.combine_evoked(
    [resp_erp_incorrect, resp_erp_correct], weights=[1, -1]
)

fig, ax = plt.subplots()
resp_erp_diff.plot(picks="FCz", axes=ax, selectable=False, show=False)

# make ERP trace bolder
ax.lines[0].set_linewidth(1.5)

# add lines through origin
ax.axhline(0, ls="dotted", lw=0.75, color="gray")
ax.axvline(0, ls=(0, (10, 10)), lw=0.75, color="gray", label="response trigger")

# mark trough
trough_time_idx = resp_erp_diff.copy().pick("FCz").data.argmin()
trough_time = resp_erp_diff.times[trough_time_idx]
ax.axvline(trough_time, ls=(0, (10, 10)), lw=0.75, color="red", label="max. negativity")

# legend, axis labels, title
ax.legend(loc="lower left")
ax.set_xlabel("Time (s)", fontweight="bold")
ax.set_ylabel("Amplitude (µV)", fontweight="bold")
ax.set_title("Channel: FCz")
fig.suptitle("ERN (Difference Wave)", fontweight="bold")
参考文献#
脚本总运行时间:(0 分钟 8.773 秒)