
注意
转到末尾下载完整示例代码。
去除 fMRI 梯度伪迹#
与功能磁共振成像同步记录的 EEG(EEG-fMRI)会被扫描仪切换磁场梯度所产生的大幅“梯度”(成像)伪迹所主导。该伪迹通常比底层神经信号大一到两个数量级,但由于它在每个采集体积重复一次(每个 TR,即重复时间一次),因此可以用平均伪迹减法(AAS)来估计并减去 [ 1 ]。
本教程构建一个小的合成 EEG-fMRI 记录(这样运行快速且可复现,既不需要真实的扫描仪记录,也不会引起任何数据隐私问题),然后展示完整流程:
使用
mne.io.read_raw_egi()读取记录,查找 TR(volume)触发事件,
使用
mne.preprocessing.remove_fmri_gradient_artifact()去除梯度伪迹,对清洗后的数据进行带通滤波。
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import datetime
import tempfile
from pathlib import Path

import numpy as np
from mffpy.epoch import Epoch
from mffpy.writer import BinWriter, Writer

import mne
from mne.preprocessing import remove_fmri_gradient_artifact

# Use the matplotlib browser backend so the plots below render as static
# images reliably (the default Qt backend uses OpenGL-accelerated rendering,
# which can produce blank screenshots when captured for the documentation).
mne.viz.set_browser_backend("matplotlib")
Using matplotlib as 2D backend.
模拟合成 EEG-fMRI 记录#
真实的 EEG-fMRI 记录并未随 MNE-Python 一起提供(它们体积大、依赖厂商格式,并且通常因参与者隐私原因而受限),因此这里我们改为构建一个小的、完全合成的记录。结果是一个真正的 .mff(EGI)文件,mne.io.read_raw_egi() 读取它的方式与读取真实记录完全一样。
我们使用 12 个通道,采用真实的 10-20 电极名称和位置,每秒一个 TR(“TREV”)触发、持续 32 秒(32 个 TR),并在合成的(非真实的)背景 EEG 噪声之上叠加一个重复的合成梯度伪迹波形——比背景 EEG 噪声大 20 到 45 倍,与真实记录中的情况一致。
sfreq = 1000.0  # Hz
n_trs = 32
tr_samples = int(sfreq)  # 1 TR = 1 second
n_samples = n_trs * tr_samples
ch_names = ["Fp1", "Fp2", "F7", "F3", "Fz", "F4", "F8", "C3", "C4", "P3", "P4", "O1"]
n_channels = len(ch_names)
start_time = datetime.datetime(2026, 1, 1, 12, 0, 0, tzinfo=datetime.UTC)
rng = np.random.default_rng(0)


def _make_colored_noise(n_samples, sfreq, std):
    """1/f-ish noise with a mild alpha (~10 Hz) bump, scaled to `std`."""
    white = rng.standard_normal(n_samples)
    freqs = np.fft.rfftfreq(n_samples, d=1 / sfreq)
    spectrum = np.fft.rfft(white)
    scale = 1.0 / np.sqrt(np.maximum(freqs, freqs[1]))  # 1/f falloff
    alpha = 1.0 + 2.0 * np.exp(-0.5 * ((freqs - 10.0) / 1.5) ** 2)
    colored = np.fft.irfft(spectrum * scale * alpha, n=n_samples)
    colored -= colored.mean()
    colored *= std / colored.std()
    return colored


def _make_gradient_template(tr_samples, sfreq, peak_amplitude):
    """Create a fixed, repeating gradient-artifact waveform for one TR."""
    t = np.arange(tr_samples) / sfreq
    ramp = 2 * (t / t[-1]) - 1  # slice-select-like ramp across the TR
    slice_freqs = rng.uniform(20, 60, size=4)
    slice_phases = rng.uniform(0, 2 * np.pi, size=4)
    slice_weights = rng.uniform(0.3, 1.0, size=4)
    slices = sum(
        w * np.sin(2 * np.pi * f * t + p)
        for w, f, p in zip(slice_weights, slice_freqs, slice_phases)
    )
    template = 0.6 * ramp + 0.4 * (slices / np.max(np.abs(slices)))
    template *= peak_amplitude / np.max(np.abs(template))
    return template


data = np.zeros((n_channels, n_samples), dtype=np.float32)
for ch in range(n_channels):
    noise_std = rng.uniform(100.0, 380.0)  # microvolts, realistic EEG range
    noise = _make_colored_noise(n_samples, sfreq, noise_std)
    peak_amp = noise_std * rng.uniform(20.0, 45.0)
    template = _make_gradient_template(tr_samples, sfreq, peak_amp)
    artifact = np.tile(template, n_trs)
    data[ch] = noise + artifact

events_meta = [
    {
        "beginTime": start_time + datetime.timedelta(seconds=i),
        "duration": 1_000_000,
        "code": "TREV",
        "label": f"TR {i + 1}",
        "description": "",
    }
    for i in range(n_trs)
]
我们 12 个通道的真实电极位置,借自 mffpy 内置的 10-20 蒙太奇(只有位置是真实的,数据不是)。
probe = Writer(str(Path(tempfile.mkdtemp()) / "_probe.mff"))
probe.add_coordinates_and_sensor_layout("Standard 10-20 (19 ch)")
coord_ns = "{http://www.egi.com/coordinates_mff}"
sl_ns = "{http://www.egi.com/sensorLayout_mff}"
coord_root = probe.files["coordinates.xml"][0].getroot()
wanted = {name.upper(): name for name in ch_names}
positions = {}
for sensor in coord_root.findall(
    f"{coord_ns}sensorLayout/{coord_ns}sensors/{coord_ns}sensor"
):
    name = sensor.find(f"{coord_ns}name").text
    if name in wanted:
        positions[wanted[name]] = tuple(
            float(sensor.find(f"{coord_ns}{c}").text) for c in "xyz"
        )

# mffpy requires the sensor count in sensorLayout.xml to match the number of
# data channels, and the "number" fields in sensorLayout.xml and
# coordinates.xml to agree with each other -- so we renumber both files
# consistently (1..12) using only our chosen channels.
import lxml.etree as ET  # noqa: E402

sensor_layout_root = probe.files["sensorLayout.xml"][0].getroot()
coord_sensors_path = f"{coord_ns}sensorLayout/{coord_ns}sensors"
sensor_parents = [
    (sl_ns, sensor_layout_root.find(f"{sl_ns}sensors")),
    (coord_ns, coord_root.find(coord_sensors_path)),
]
for ns, sensors_el in sensor_parents:
    for child in list(sensors_el):
        sensors_el.remove(child)
    for i, name in enumerate(ch_names, start=1):
        sensor_el = ET.SubElement(sensors_el, f"{ns}sensor")
        ET.SubElement(sensor_el, f"{ns}name").text = name
        ET.SubElement(sensor_el, f"{ns}number").text = str(i)
        ET.SubElement(sensor_el, f"{ns}type").text = "0"
        for tag, val in zip("xyz", positions[name]):
            ET.SubElement(sensor_el, f"{ns}{tag}").text = str(val)
现在写出合成的 .mff 文件。
mff_path = Path(tempfile.mkdtemp()) / "synthetic_fmri_eeg_demo.mff"
writer = Writer(str(mff_path))
writer.addxml("fileInfo", recordTime=start_time)
writer.addxml("dataInfo", fileDataType="EEG")
writer.addxml(
    "eventTrack",
    name="TR_events",
    trackType="STIM",
    events=events_meta,
    filename="Events_TREV.xml",
)
writer.addxml(
    "epochs",
    epochs=[
        Epoch(
            beginTime=0,
            endTime=int(n_samples / sfreq * 1e6),
            firstBlock=1,
            lastBlock=1,
        )
    ],
)
writer.files["sensorLayout.xml"] = probe.files["sensorLayout.xml"]
writer.files["coordinates.xml"] = probe.files["coordinates.xml"]

bin_writer = BinWriter(sampling_rate=int(sfreq), data_type="EEG")
bin_writer.add_block(data)
writer.addbin(bin_writer)
writer.write()
读取记录#
从这里开始,这就是你在真实 EEG-fMRI 记录上会使用的完全相同的流程。
raw = mne.io.read_raw_egi(mff_path, preload=True)
Reading EGI MFF Header from /tmp/tmpwjxwwrx1/synthetic_fmri_eeg_demo.mff...
    Reading events ...
    Assembling measurement info ...
    Excluding events {TREV} ...
/home/circleci/project/tutorials/preprocessing/58_fmri_gradient_artifact.py:203: RuntimeWarning: Fiducial point nasion not found, assuming identity unknown to head transformation
  raw = mne.io.read_raw_egi(mff_path, preload=True)
Reading 0 ... 31999  =      0.000 ...    31.999 secs...
categories.xml not found or of wrong type. `Epoch.name` will default to "epoch" for all epochs.
查找 TR(volume)事件#
每个 TR 触发都是 TREV 通道上的单采样脉冲。
events = mne.find_events(raw, initial_event=True)
Finding events on: TREV
32 events found on stim channel TREV
Event IDs: [1]
注意
如果一个触发在第一个采样点就已经是高电平,find_events() 通常不会将其计入,因为没有在其之前可供上升的“低电平”采样。这里我们的第一个 TR 触发恰好与第一个采样点重合,因此我们传入 initial_event=True 以保留它并恢复全部 32 个 TR。
可视化原始信号#
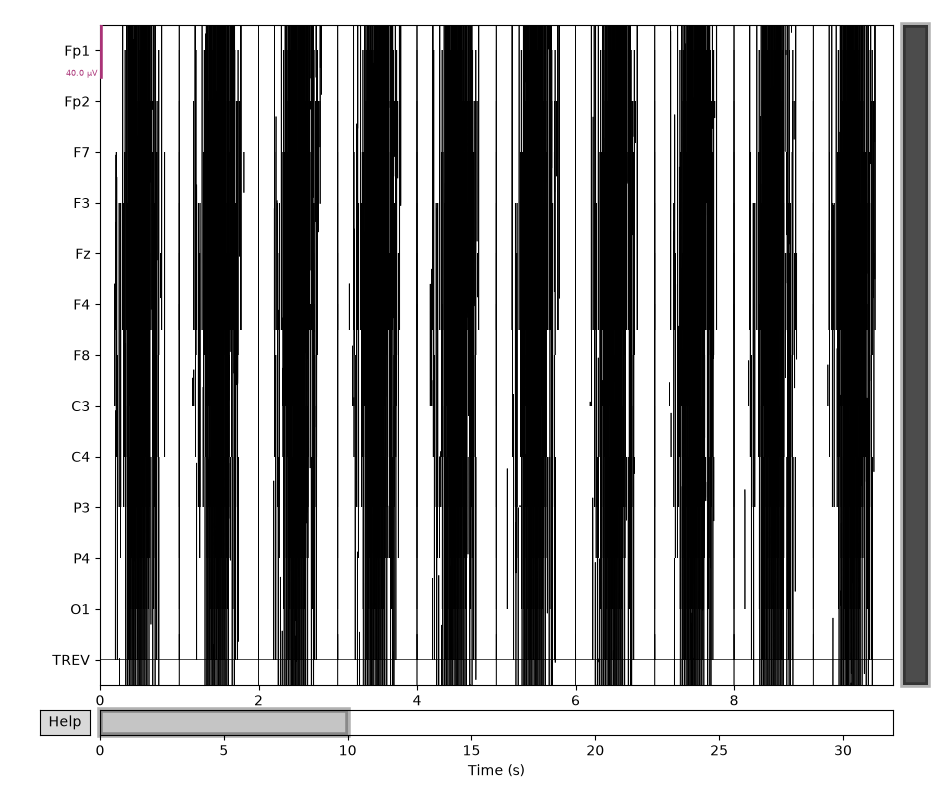
梯度伪迹主导了该记录——在此尺度下看不到其下的 EEG 信号。
raw.plot()
去除梯度伪迹#
remove_fmri_gradient_artifact() 实现平均伪迹减法(AAS):对于每个 TR,它通过对相邻 TR 取平均来构建模板(此处的 window=(4, 4) 是对前后各 4 个 TR 取平均),然后将其减去。
raw_clean = remove_fmri_gradient_artifact(raw, events, window=(4, 4))
对清洗后的数据滤波#
在(大得多的)梯度伪迹被去除后,就可以像往常一样应用标准的带通滤波。
filt = raw_clean.filter(l_freq=1.0, h_freq=30, n_jobs=2)
Filtering raw data in 1 contiguous segment
Setting up band-pass filter from 1 - 30 Hz

FIR filter parameters
---------------------
Designing a one-pass, zero-phase, non-causal bandpass filter:
- Windowed time-domain design (firwin) method
- Hamming window with 0.0194 passband ripple and 53 dB stopband attenuation
- Lower passband edge: 1.00
- Lower transition bandwidth: 1.00 Hz (-6 dB cutoff frequency: 0.50 Hz)
- Upper passband edge: 30.00 Hz
- Upper transition bandwidth: 7.50 Hz (-6 dB cutoff frequency: 33.75 Hz)
- Filter length: 3301 samples (3.301 s)

[Parallel(n_jobs=2)]: Using backend ThreadingBackend with 2 concurrent workers.
[Parallel(n_jobs=2)]: Done  12 out of  12 | elapsed:    0.0s finished
可视化结果#
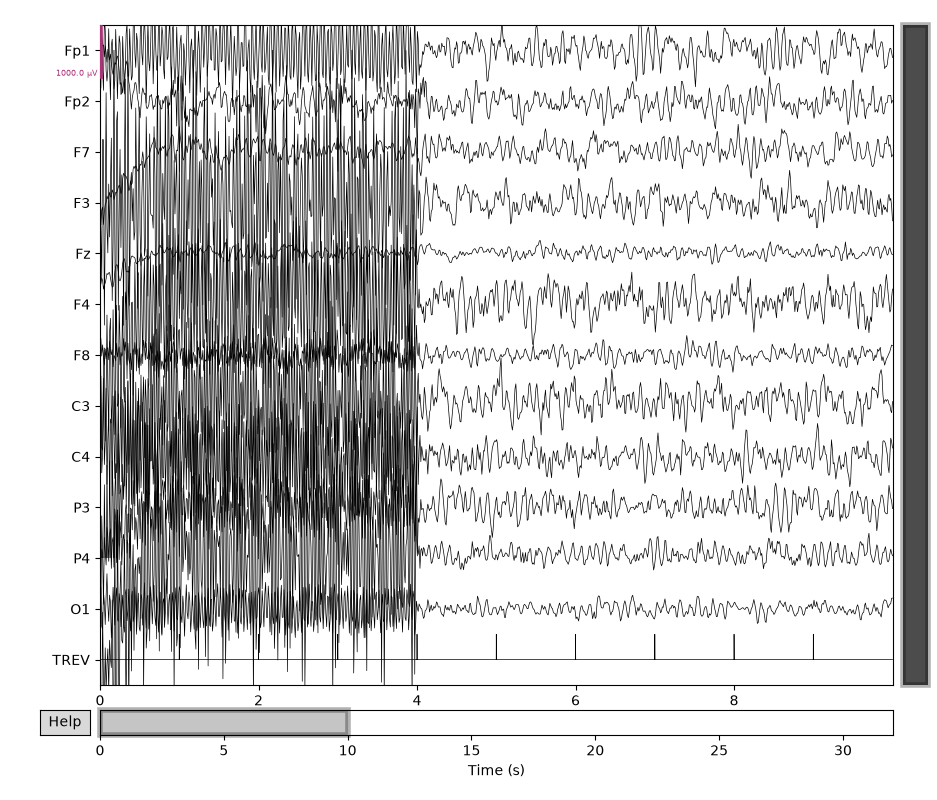
恢复出的 EEG 信号现在可以在真实的振幅尺度下看到。默认的逐通道缩放是为真实的(小得多的)EEG 伪迹调整的,因此我们传入与合成噪声振幅相匹配的显式 scalings 值,以获得可读的图。
注意
前 4 个 TR 未被清洗,因为需要它们来构建伪迹去除所用的平均模板(window=(4, 4) 会向前和向后各看 4 个 TR)。你可以在下图的开头看到梯度伪迹仍然存在。
filt.plot(scalings=dict(eeg=500e-6))
另请参阅#
对于同步 EEG-fMRI 记录,通常先去除梯度伪迹(如上所述),然后使用 mne.preprocessing.apply_pca_obs() 去除心电(心冲击图)伪迹。
参考文献#
脚本总运行时间:(0 分钟 1.796 秒)