
说明
转到末尾下载完整示例代码。
从零创建 MNE-Python 数据结构#
本教程展示如何使用现有的(真实或合成)数据 NumPy 数组创建 MNE-Python 的核心数据结构。
首先导入所需的 Python 模块:
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import numpy as np

import mne
创建 Info 对象#
用于连续数据(Raw)、不连续数据(Epochs)和平均数据(Evoked)的核心数据结构都具有一个 info 属性,其中包含一个 mne.Info 对象。使用 mne.io 子模块中的函数读取记录数据时,Info 对象会被自动创建并填充。但如果我们想从零创建 Raw、Epochs 或 Evoked 对象,也需要创建相应的 Info 对象。最简单的方法是使用 mne.create_info 函数初始化必需的 info 字段。其他字段可以随后像操作普通字典那样进行赋值。
初始化一个最小的 Info 对象需要通道名称列表和采样频率。为方便处理仿真数据,通道名称也可以只提供一个整数,此时名称会自动生成为连续整数(从 0 开始):
# Create some dummy metadata
n_channels = 32
sampling_freq = 200  # in Hertz
info = mne.create_info(n_channels, sfreq=sampling_freq)
print(info)
<Info | 7 non-empty values
 bads: []
 ch_names: 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, ...
 chs: 32 misc
 custom_ref_applied: False
 highpass: 0.0 Hz
 lowpass: 100.0 Hz
 meas_date: unspecified
 nchan: 32
 projs: []
 sfreq: 200.0 Hz
>
从上面的输出可以看到,默认情况下通道被指定为“misc”类型(即输出中的 chs: 32 MISC)。如有需要,可以在初始化 Info 对象时指定通道类型:
ch_names = [f"MEG{n:03}" for n in range(1, 10)] + ["EOG001"]
ch_types = ["mag", "grad", "grad"] * 3 + ["eog"]
info = mne.create_info(ch_names, ch_types=ch_types, sfreq=sampling_freq)
print(info)
<Info | 7 non-empty values
 bads: []
 ch_names: MEG001, MEG002, MEG003, MEG004, MEG005, MEG006, MEG007, MEG008, ...
 chs: 3 Magnetometers, 6 Gradiometers, 1 EOG
 custom_ref_applied: False
 highpass: 0.0 Hz
 lowpass: 100.0 Hz
 meas_date: unspecified
 nchan: 10
 projs: []
 sfreq: 200.0 Hz
>
如果通道名称遵循某种标准的 montage 命名方案,可以使用 set_montage 方法自动添加其空间位置:
ch_names = ["Fp1", "Fp2", "Fz", "Cz", "Pz", "O1", "O2"]
ch_types = ["eeg"] * 7
info = mne.create_info(ch_names, ch_types=ch_types, sfreq=sampling_freq)
info.set_montage("spherical_1020")
注意新增的 dig 字段,其中包含 7 个通道位置,以及三个头皮基准标志点的理论值。
可以像修改 Python 字典一样,通过方括号键赋值来添加其他字段:
<Info | 10 non-empty values
 bads: 1 items (O1)
 ch_names: Fp1, Fp2, Fz, Cz, Pz, O1, O2
 chs: 7 EEG
 custom_ref_applied: False
 description: My custom dataset
 dig: 10 items (3 Cardinal, 7 EEG)
 highpass: 0.0 Hz
 lowpass: 100.0 Hz
 meas_date: unspecified
 nchan: 7
 projs: []
 sfreq: 200.0 Hz
>
创建 Raw 对象#
要从零创建 Raw 对象,可以使用 mne.io.RawArray 类的构造函数,它接收一个 Info 对象和一个形状为 (n_channels, n_samples) 的 NumPy 数组。这里我们创建一些正弦数据并绘图:
times = np.linspace(0, 1, sampling_freq, endpoint=False)
sine = np.sin(20 * np.pi * times)
cosine = np.cos(10 * np.pi * times)
data = np.array([sine, cosine])

info = mne.create_info(
    ch_names=["10 Hz sine", "5 Hz cosine"], ch_types=["misc"] * 2, sfreq=sampling_freq
)

simulated_raw = mne.io.RawArray(data, info)
simulated_raw.plot(show_scrollbars=False, show_scalebars=False)
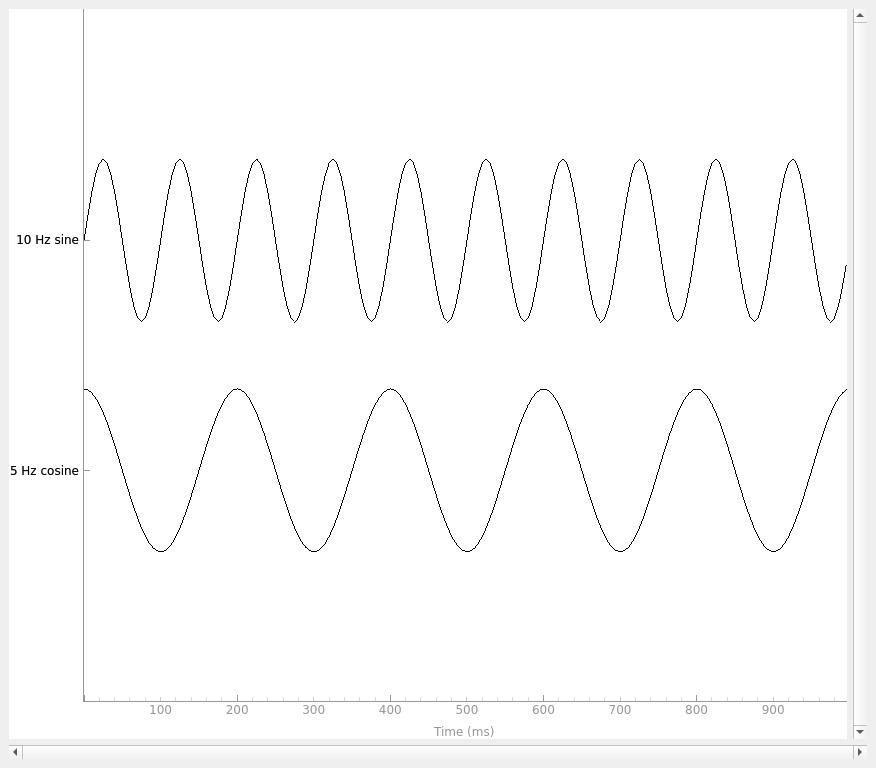
Creating RawArray with float64 data, n_channels=2, n_times=200
    Range : 0 ... 199 =      0.000 ...     0.995 secs
Ready.
Using qt as 2D backend.
创建 Epochs 对象#
要从零创建 Epochs 对象,可以使用 mne.EpochsArray 类的构造函数,它接收一个 Info 对象和一个形状为 (n_epochs, n_channels, n_samples) 的 NumPy 数组。这里我们将基于 2 通道数据创建 5 个分段并绘图。请注意,必须向 plot 方法传入 picks='misc',因为默认情况下它只绘制数据通道。
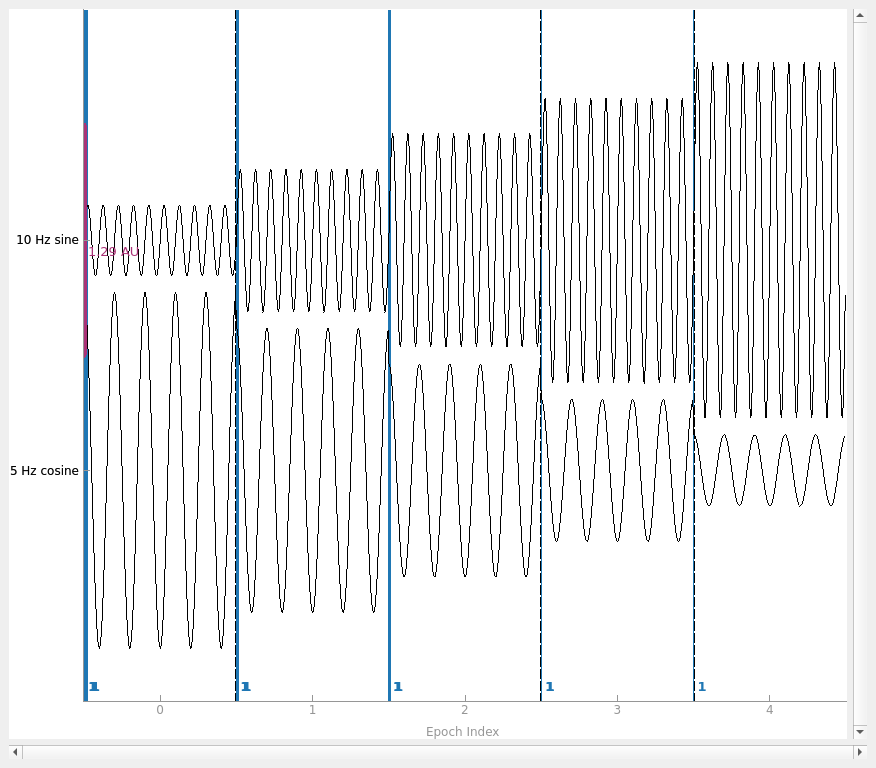
Not setting metadata
5 matching events found
No baseline correction applied
0 projection items activated
You seem to have overlapping epochs. Some event lines may be duplicated in the plot.
由于我们没有提供 events 数组,EpochsArray 构造函数自动为我们创建了一个,其中所有分段的事件编号都相同:
print(simulated_epochs.events[:, -1])
[1 1 1 1 1]
如果我们想模拟不同的实验条件,可以向构造函数传入事件数组(以及事件 ID 字典)。由于每个分段长 1 秒、采样率为 200 采样点/秒,我们将事件间隔设为 200 个采样点,并传入 tmin=-0.5,使事件落在每个分段的中间(事件在每个分段中总是位于 time=0)。
events = np.column_stack(
    (
        np.arange(0, 1000, sampling_freq),
        np.zeros(5, dtype=int),
        np.array([1, 2, 1, 2, 1]),
    )
)
event_dict = dict(condition_A=1, condition_B=2)
simulated_epochs = mne.EpochsArray(
    data, info, tmin=-0.5, events=events, event_id=event_dict
)
simulated_epochs.plot(
    picks="misc", show_scrollbars=False, events=events, event_id=event_dict
)
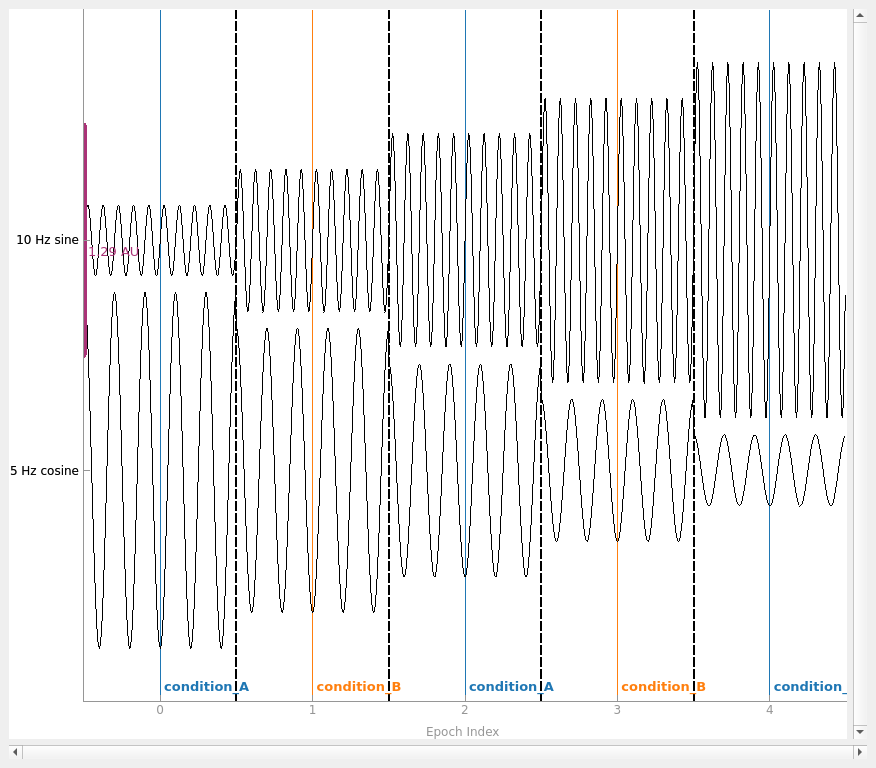
Not setting metadata
5 matching events found
No baseline correction applied
0 projection items activated
也可以在仿真的 RawArray 对象上使用普通的 Epochs(而非 EpochsArray)构造函数来创建仿真分段:先创建事件数组(例如使用 mne.make_fixed_length_events),再围绕这些事件提取分段。
创建 Evoked 对象#
如果已有跨试次平均后的数据,可以使用 EvokedArray 类构造函数将其创建为 Evoked 对象。它需要一个 Info 对象和一个形状为 (n_channels, n_times) 的数据数组,并像 EpochsArray 一样具有可选的 tmin 参数。它还有一个 nave 参数,表示参与平均的试次数;以及一个 comment 参数,便于记录实验条件等信息。这里我们将对 NumPy 数组进行平均,并用得到的平均数据创建 Evoked。
# Create the Evoked object
evoked_array = mne.EvokedArray(
    data.mean(axis=0), info, tmin=-0.5, nave=data.shape[0], comment="simulated"
)
print(evoked_array)
evoked_array.plot()
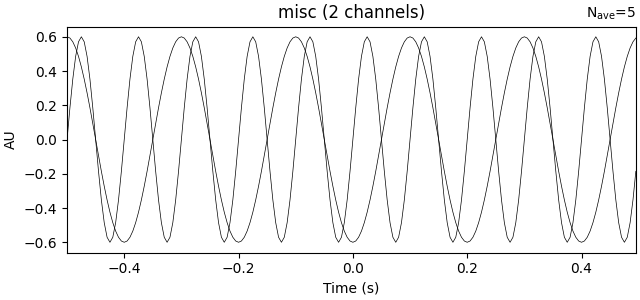
<Evoked | 'simulated' (average, N=5), -0.5 – 0.495 s, baseline off, 2 ch, ~9 KiB>
在某些情况下,你可能希望使用自定义的时频分解来估计功率谱,或者希望在 MNE 中处理预先计算好的功率谱。按照同样的思路,可以使用 SpectrumArray 或 EpochsSpectrumArray 类来实例化平均功率谱。
# compute power spectrum

psd, freqs = mne.time_frequency.psd_array_welch(
    data, info["sfreq"], n_fft=128, n_per_seg=32
)

psd_ave = psd.mean(0)

info = mne.create_info(["Ch 1", "Ch2"], sfreq=sampling_freq, ch_types="eeg")
spectrum = mne.time_frequency.SpectrumArray(
    data=psd_ave,
    freqs=freqs,
    info=info,
)

spectrum.plot(spatial_colors=False, amplitude=False)
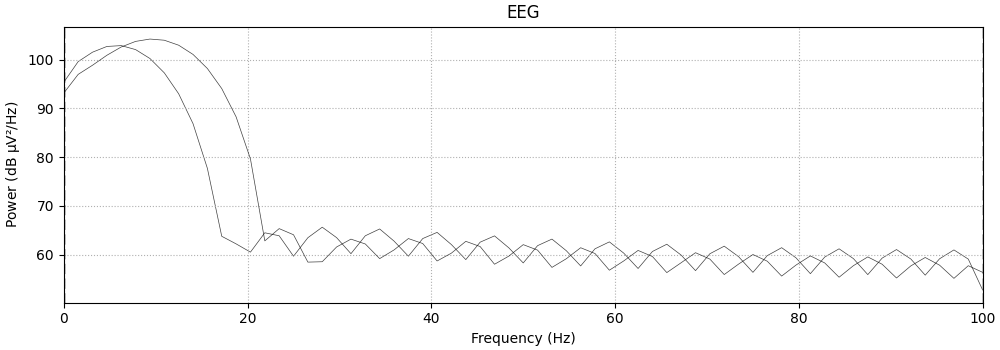
Effective window size : 0.640 (s)
Plotting power spectral density (dB=True).
脚本总运行时间:(0 分钟 1.140 秒)