
说明
转到末尾下载完整示例代码。
处理 Epoch 元数据#
本教程展示如何为 Epochs 对象添加元数据,以及如何使用 Pandas 查询字符串根据元数据属性选择和绘制 epoch。
本教程将使用一个与往常不同的数据集:Kiloword 数据集,它包含 75 名执行词汇判断(词/非词)任务的被试的平均 EEG 数据。数据以 Epochs 格式提供,每个 epoch 代表对某个不同刺激(单词)的响应。和往常一样,我们先导入所需的模块并加载数据:
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import numpy as np
import pandas as pd

import mne

kiloword_data_folder = mne.datasets.kiloword.data_path()
kiloword_data_file = kiloword_data_folder / "kword_metadata-epo.fif"
epochs = mne.read_epochs(kiloword_data_file)
Reading /home/circleci/mne_data/MNE-kiloword-data/kword_metadata-epo.fif ...
Isotrak not found
    Found the data of interest:
        t =    -100.00 ...     920.00 ms
        0 CTF compensation matrices available
Adding metadata with 8 columns
960 matching events found
No baseline correction applied
0 projection items activated
查看 Epochs 元数据#
附加到 Epochs 对象的元数据以 pandas.DataFrame 的形式存储:
assert isinstance(epochs.metadata, pd.DataFrame)
每一行对应一个 epoch。列中可以包含你希望存储的关于每个 epoch 的几乎任何信息;在本例中,元数据编码了每个试次所见刺激的信息,既包括视觉词形本身的属性(例如 NumberOfLetters、VisualComplexity),也包括单词含义的属性(例如其 Concreteness)以及它在英语词汇中的常见程度(例如 WordFrequency)。以下是所有变量;请注意,在 Jupyter notebook 中查看 pandas.DataFrame 时会渲染为 HTML 表格,而不是通常的 Python 输出块:
epochs.metadata
查看给定 epoch 和元数据变量的元数据值,可使用任意 Pandas 索引方法,例如 loc、iloc、at 和 iat。由于 DataFrame 的索引是整数 epoch 编号,基于名称和基于索引的选择方法在选择行时表现相似,只是基于名称的选择(使用 loc)会包含端点:
print("Name-based selection with .loc")
print(epochs.metadata.loc[2:4])

print("\nIndex-based selection with .iloc")
print(epochs.metadata.iloc[2:4])
Name-based selection with .loc
   WORD  Concreteness  ...  ConsonantVowelProportion  VisualComplexity
2  shot           4.6  ...                      0.75         64.600033
3  cold           3.7  ...                      0.75         63.657457
4  main           3.0  ...                      0.50         68.945661

[3 rows x 8 columns]

Index-based selection with .iloc
   WORD  Concreteness  ...  ConsonantVowelProportion  VisualComplexity
2  shot           4.6  ...                      0.75         64.600033
3  cold           3.7  ...                      0.75         63.657457

[2 rows x 8 columns]
修改元数据#
与任何 pandas.DataFrame 一样,你可以按需修改数据或添加列。这里我们将 NumberOfLetters 列从浮点型转换为整型,并添加一个布尔列,将变量 VisualComplexity 任意划分为高、低两组。
epochs.metadata["NumberOfLetters"] = epochs.metadata["NumberOfLetters"].map(int)
epochs.metadata["HighComplexity"] = epochs.metadata["VisualComplexity"] > 65
epochs.metadata.head()
使用元数据查询选择 Epochs#
所有 Epochs 对象都可以按事件名称、索引或切片进行子选择(参见 Subselecting epochs)。不过,带有元数据的 Epochs 对象还可以使用 Pandas 查询字符串进行查询,只需像平常传入事件名称那样传入查询字符串即可。例如:
print(epochs['WORD.str.startswith("dis")'])
<EpochsFIF | 8 events (all good), -0.1 – 0.92 s (baseline off), ~493 KiB, data loaded, with metadata,
 'district': 1
 'display': 1
 'disarray': 1
 'disaster': 1
 'disease': 1
 'discord': 1
 'disposal': 1
 'distance': 1>
该功能底层调用 pandas.DataFrame.query() 方法,因此可以查阅该方法的文档,了解如何编写查询字符串。下面是另一个示例:
print(epochs["Concreteness > 6 and WordFrequency < 1"])
<EpochsFIF | 4 events (all good), -0.1 – 0.92 s (baseline off), ~261 KiB, data loaded, with metadata,
 'lasso': 1
 'tentacle': 1
 'banjo': 1
 'corsage': 1>
另请注意,按条件名称进行的传统 epoch 子选择仍然有效;MNE-Python 会先尝试传统方法,失败后再回退到丰富的元数据查询。
epochs["solenoid"].compute_psd().plot(picks="data", exclude="bads", amplitude=False)
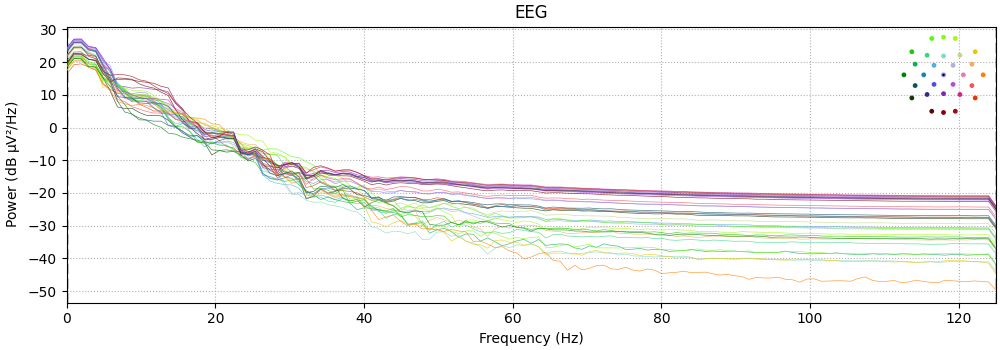
    Using multitaper spectrum estimation with 7 DPSS windows
Plotting power spectral density (dB=True).
Pandas 查询字符串方法的一种用途是选择特定的单词进行绘图:
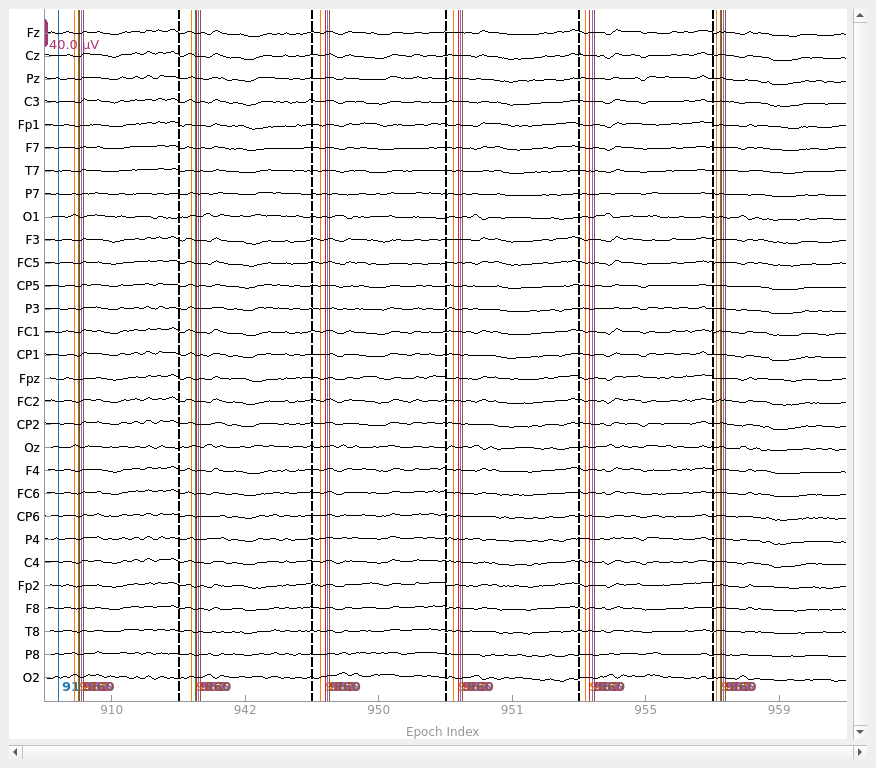
You seem to have overlapping epochs. Some event lines may be duplicated in the plot.
Using qt as 2D backend.
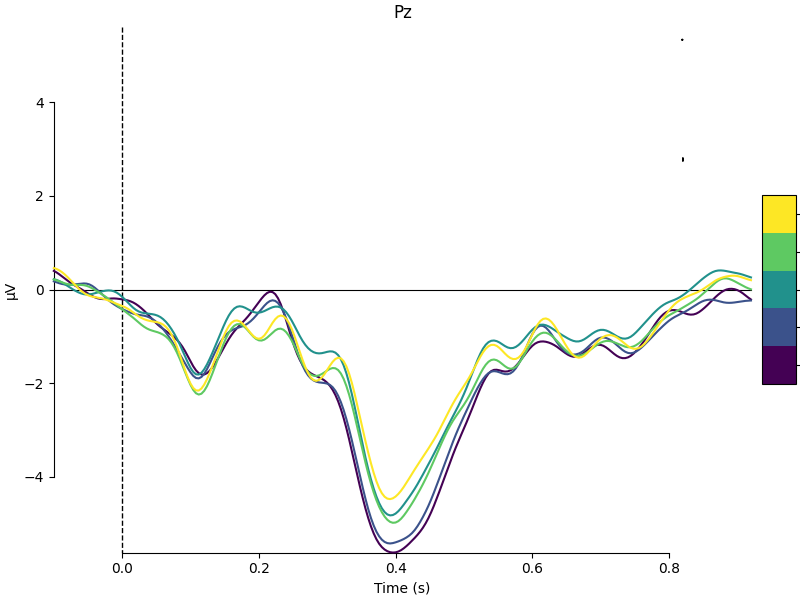
请注意,在这个数据集中,每个“条件”(也就是每个单词)只出现一次;而在 Sample 数据集中,每个条件(例如“auditory/left”、“visual/right”等)会出现数十次。因此,当你想要聚合条件名称不同但刺激属性相似的 epoch 时,Pandas 查询方法尤其有用。例如,下面我们按刺激单词的字母数对 epoch 分组,并比较每组在电极 Pz 处的平均信号:
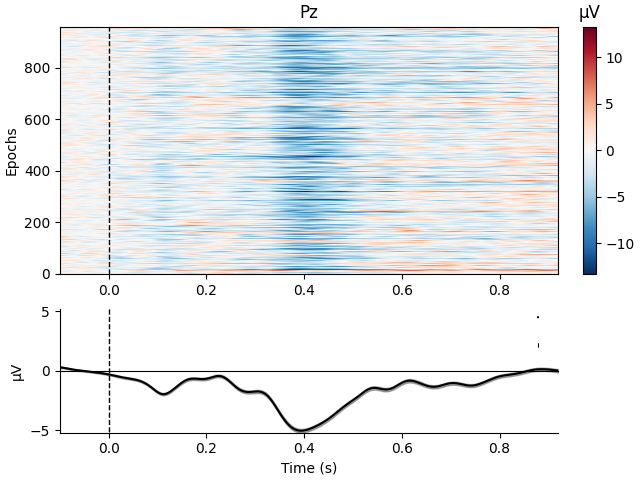
元数据还可用于对图像图中的 epoch 排序。例如,下面我们按单词频率对 epoch 排序,看看响应的潜伏期或强度是否存在某种模式:
sort_order = np.argsort(epochs.metadata["WordFrequency"])
epochs.plot_image(order=sort_order, picks="Pz")
Not setting metadata
960 matching events found
No baseline correction applied
0 projection items activated
尽管在这个例子中没有明显的关系,但对于更直接反映刺激加工时间进程的元数据变量(例如反应时),这类分析可能很有用。
为 Epochs 对象添加元数据#
只要给 metadata 属性赋值,就可以向任何 Epochs 对象添加元数据 DataFrame(或替换现有元数据):
new_metadata = pd.DataFrame(
    data=["foo"] * len(epochs), columns=["bar"], index=range(len(epochs))
)
epochs.metadata = new_metadata
epochs.metadata.head()
Replacing existing metadata with 1 columns
将 Epochs 对象的 metadata 设置为 None,即可移除其元数据:
epochs.metadata = None
Removing existing metadata
脚本总运行时间:(0 分钟 2.275 秒)