
说明
转到末尾下载完整示例代码。
从原始数据中解析事件#
本教程介绍如何从原始记录中读取实验事件,以及如何在 MNE-Python 内部的两种不同事件表示形式(Events 数组和 Annotations 对象)之间进行转换。
在入门教程中,我们看到了从“STIM”通道读取实验事件的示例;这里我们将更广泛地讨论事件与标注,更详细地介绍如何从 STIM 通道读取事件,并给出一个示例,说明如何读取位于标记文件中或以嵌入数组形式包含在数据文件中的事件。教程“处理事件”和“标注连续数据”分别讨论了如何绘制、合并、加载、保存和导出事件与 Annotations,后一篇教程还介绍了对 Raw 对象进行交互式标注。
我们首先加载所需的 Python 模块,并加载入门教程中使用的相同示例数据;但为了节省内存,我们会在将 Raw 对象载入 RAM 之前先将其裁剪到仅 60 秒:
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import numpy as np

import mne

sample_data_folder = mne.datasets.sample.data_path()
sample_data_raw_file = sample_data_folder / "MEG" / "sample" / "sample_audvis_raw.fif"
raw = mne.io.read_raw_fif(sample_data_raw_file)
raw.crop(tmax=60).load_data()
Opening raw data file /home/circleci/mne_data/MNE-sample-data/MEG/sample/sample_audvis_raw.fif...
    Read a total of 3 projection items:
        PCA-v1 (1 x 10²)  idle
        PCA-v2 (1 x 10²)  idle
        PCA-v3 (1 x 10²)  idle
    Range : 25800 ... 192599 =     42.956 ...   320.670 secs
Ready.
Reading 0 ... 36037  =      0.000 ...    60.000 secs...
Events 与 Annotations 数据结构#
一般来说,Events 和 Annotations 两种数据结构的作用相同:它们都建立 EEG/MEG 记录中的时间与这些时间点所发生情况的描述之间的映射。换句话说,它们将“何时”与“何事”关联起来。主要区别如下:
单位:Events 数据结构以采样点表示“何时”,而
Annotations数据结构以秒表示“何时”。描述的限制:Events 数据结构用整数“事件 ID”编码表示“何事”,而
Annotations数据结构用字符串表示“何事”。时长的编码方式:Event 数组中的事件没有时长(不过可以用起始/结束事件对在 Events 数组内表示时长),而
Annotations对象的每个元素都必然包含时长(如果希望表示瞬时事件,时长可以为零)。内部表示:Events 以普通的
NumPy array存储,而Annotations是 MNE-Python 中定义的一种list式类。
什么是 STIM 通道?#
STIM 通道(“stimulus channel”的简称)是不从 EEG、MEG 或其他传感器接收信号的通道。相反,STIM 通道记录与实验事件时间锁定的电压(通常是由实验控制计算机发出的、幅度固定的短矩形直流脉冲),这些实验事件例如刺激起始或被试的按键反应(这些脉冲有时被称为 TTL 脉冲、事件脉冲、触发信号,或直接称为“触发”)。在其他情况下,这些脉冲可能并不严格与某个实验事件时间锁定,而是出现在试次之间,用以指示即将到来的试次中刺激(或实验条件)的类型。
直流脉冲可以全部出现在一个 STIM 通道上(此时不同实验事件或试次类型被编码为不同的电压幅度),也可以分布在多个通道上(此时脉冲出现所在的通道可用于编码不同事件或条件)。即使在具有多个 STIM 通道的系统上,通常也有一个通道记录其他 STIM 通道的加权和,使得该通道上的电压水平能够被明确解码为特定事件类型。在较旧的 Neuromag 系统上(例如用于记录示例数据的系统),这个“求和通道”通常是 STI 014;在较新的系统上则更常见的是 STI101。你可以在原始数据文件中看到这些 STIM 通道:
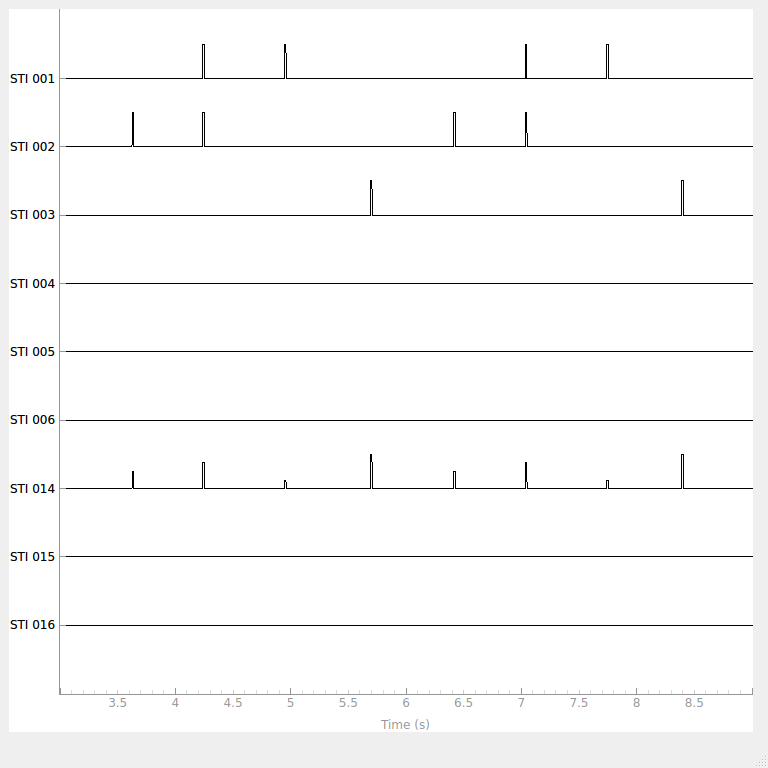
raw.copy().pick(picks="stim").plot(start=3, duration=6)
Using qt as 2D backend.
可以看到,STI 014(求和通道)包含不同幅度的脉冲,而其他通道上的脉冲幅度则保持一致。还可以看到,每当其他某个 STIM 通道上出现脉冲时,STI 014 上都会有相应的脉冲。
将 STIM 通道信号转换为 Events 数组#
如果你的数据在 STIM 通道上记录了事件,可以使用 find_events 将它们转换为事件数组。每个脉冲起始(或结束)处的采样点编号被记录为事件时间,脉冲幅度被转换为整数,这些采样点编号与整数编码组成的对存储在 NumPy arrays 中(通常称为“事件数组”或简称“事件”)。在最简单的形式下,该函数只需要 Raw 对象以及要从中读取事件的通道名称:
events = mne.find_events(raw, stim_channel="STI 014")
print(events[:5])  # show the first 5
Finding events on: STI 014
86 events found on stim channel STI 014
Event IDs: [ 1  2  3  4  5 32]
[[27977     0     2]
 [28345     0     3]
 [28771     0     1]
 [29219     0     4]
 [29652     0     2]]
如果不提供 STIM 通道名称,find_events 会首先查找 MNE-Python 配置变量 MNE_STIM_CHANNEL、MNE_STIM_CHANNEL_1 等。如果找不到这些变量,则尝试 STI 014 和 STI101 通道,随后尝试 raw.ch_names 中第一个类型为“STIM”的通道。如果你经常处理来自多个不同 MEG 系统、且 STIM 通道名称各不相同的数据,设置 MNE_STIM_CHANNEL 配置变量可能用处不大;但对于数据全部来自单一系统的研究者来说,配置一次该变量之后便无需再理会,可以节省时间。
find_events 有多个选项,包括将事件对齐到 STIM 通道脉冲的起始或结束、设置最小脉冲持续时间,以及处理连续脉冲(脉冲之间没有回到零)等。例如,通过向 find_events 传递 output='step',可以有效地编码事件时长;详见 find_events 的文档。有关处理事件数组的更多信息(包括如何绘制、合并、加载和保存事件数组),请参阅教程“处理事件”。
将内嵌事件读取为 Annotations#
一些 EEG/MEG 系统生成的文件将事件存储在单独的数据数组中,而不是一个或多个 STIM 通道上的脉冲。例如,EEGLAB 格式将事件存储为 .set 文件中的一组数组。读取这些文件时,MNE-Python 会自动将存储的事件转换为 Annotations 对象,并将其存储为 Raw 对象的 annotations 属性:
testing_data_folder = mne.datasets.testing.data_path()
eeglab_raw_file = testing_data_folder / "EEGLAB" / "test_raw.set"
eeglab_raw = mne.io.read_raw_eeglab(eeglab_raw_file)
print(eeglab_raw.annotations)
Reading /home/circleci/mne_data/MNE-testing-data/EEGLAB/test_raw.fdt
<Annotations | 154 segments: rt (74), square (80)>
Annotations 对象中的核心数据可通过其三个属性访问:onset、duration 和 description。这里可以看到,EEGLAB 文件中存储了 154 个事件,它们的时长均为零秒,共有两种不同类型的事件,且第一个事件发生在记录开始约 1 秒之后:
print(len(eeglab_raw.annotations))
print(set(eeglab_raw.annotations.duration))
print(set(eeglab_raw.annotations.description))
print(eeglab_raw.annotations.onset[0])
154
{np.float64(0.0)}
{'square', 'rt'}
1.000068
有关处理 Annotations 对象的更多信息,包括如何以交互方式向 Raw 对象添加标注,以及如何绘制、拼接、加载、保存和导出 Annotations 对象,请参阅教程“标注连续数据”。
在 Events 数组与 Annotations 对象之间转换#
将实验事件读入 MNE-Python 后(无论是以 Events 数组还是 Annotations 对象的形式),你可以根据需要轻松地在两种格式之间转换。你可能会这样做,例如,因为对连续数据进行分段需要 Events 数组,或者因为你想利用某些函数的“标注感知”能力,这些函数会在数据段与特定标注重叠时自动将其省略。
要将 Annotations 对象转换为 Events 数组,请在包含标注的 Raw 文件上使用函数 mne.events_from_annotations。该函数会为 raw.annotations.description 中的每个唯一元素分配一个整数事件 ID,并返回描述到整数事件 ID 的映射以及导出的事件数组。默认情况下,每个标注的起始处会创建一个事件;这可以通过 events_from_annotations 的 chunk_duration 参数修改,以在每个标注区间内创建等间隔事件(参见下文的“为每个标注生成多个事件”,或参阅“生成等间隔 Events 数组”以直接创建等间隔事件组成的 Events 数组)。
events_from_annot, event_dict = mne.events_from_annotations(eeglab_raw)
print(event_dict)
print(events_from_annot[:5])
Used Annotations descriptions: ['rt', 'square']
{'rt': 1, 'square': 2}
[[128   0   2]
 [217   0   2]
 [267   0   1]
 [602   0   2]
 [659   0   1]]
如果要控制哪些整数映射到每个唯一的描述值,可以将指定映射的 dict 作为 events_from_annotations 的 event_id 参数传入;该 dict 会原样作为 event_dict 返回。
请注意,在从 Raw 对象创建 Epochs 时可以使用这个 event_dict,如教程“Epochs 数据结构:不连续数据”所示。
custom_mapping = {"rt": 77, "square": 42}
(events_from_annot, event_dict) = mne.events_from_annotations(
    eeglab_raw, event_id=custom_mapping
)
print(event_dict)
print(events_from_annot[:5])
Used Annotations descriptions: ['rt', 'square']
{'rt': 77, 'square': 42}
[[128   0  42]
 [217   0  42]
 [267   0  77]
 [602   0  42]
 [659   0  77]]
要进行相反的转换(从 Events 数组转换为 Annotations 对象),你可以创建从整数事件 ID 到字符串描述的映射,使用 annotations_from_events 构造 Annotations 对象,并调用 set_annotations 方法将标注添加到 Raw 对象。
由于示例数据是在 Neuromag 系统上记录的(该系统的采样点编号从采集系统启动时开始,而不是从记录开始时开始),我们还需要传入 orig_time 参数,以便事件起始时间相对于记录起始位置正确对齐:
mapping = {
    1: "auditory/left",
    2: "auditory/right",
    3: "visual/left",
    4: "visual/right",
    5: "smiley",
    32: "buttonpress",
}
annot_from_events = mne.annotations_from_events(
    events=events,
    event_desc=mapping,
    sfreq=raw.info["sfreq"],
    orig_time=raw.info["meas_date"],
)
raw.set_annotations(annot_from_events)
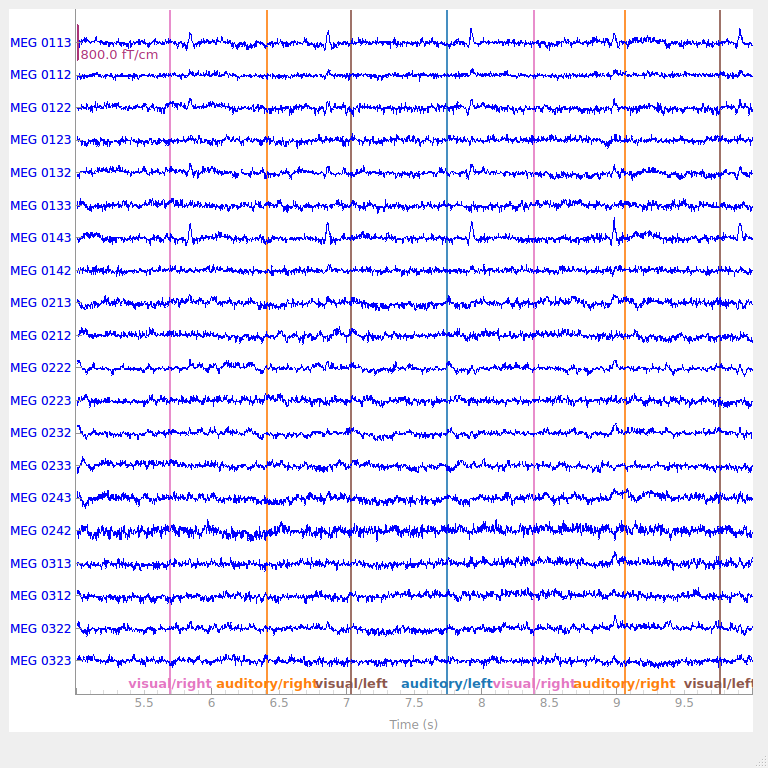
现在,绘制原始数据时标注会自动出现,并按标签值以不同颜色显示:
raw.plot(start=5, duration=5)
为每个标注生成多个事件#
如上所述,你可以使用 events_from_annotations 的 chunk_duration 参数从 Annotations 对象生成等间隔事件。例如,假设我们的 Raw 对象中有一个标注指示被试处于 REM 睡眠的时间段,而我们希望对这些数据段进行静息态分析。我们可以在每个“REM”区间内创建一系列等间隔事件组成的 Events 数组,然后使用这些事件生成(可能相互重叠的)Epochs,以便进一步分析。
# create the REM annotations
rem_annot = mne.Annotations(onset=[5, 41], duration=[16, 11], description=["REM"] * 2)
raw.set_annotations(rem_annot)
(rem_events, rem_event_dict) = mne.events_from_annotations(raw, chunk_duration=1.5)
Used Annotations descriptions: ['REM']
现在可以检查我们的事件确实落在 5-21 秒和 41-52 秒范围内,并且彼此相隔约 1.5 秒(由于采样频率会存在一些抖动)。以下是四舍五入到最近毫秒的事件时间:
print(np.round((rem_events[:, 0] - raw.first_samp) / raw.info["sfreq"], 3))
[ 5.     6.5    8.     9.5   11.    12.501 14.001 15.501 16.999 18.499
 41.    42.5   44.    45.5   47.    48.5   50.   ]
关于静息态分析的其他示例,可以在 make_fixed_length_events 的在线文档中找到。
脚本总运行时间:(0 分钟 2.403 秒)