
注意
转到末尾下载完整示例代码。
Raw 数据结构:连续数据#
本教程介绍在 Python 中处理原始 EEG/MEG 数据的基础知识,详细讲解 Raw 数据结构,包括如何加载、查询、子选择、导出和绘制 Raw 对象中的数据。有关 Raw 对象可视化的更多信息,请参阅《Raw 对象的内置绘图方法》;有关从 NumPy 数组中的模拟数据创建 Raw 对象的信息,请参阅《从零创建 MNE-Python 数据结构》。
照例,我们首先导入所需的模块:
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import os

import matplotlib.pyplot as plt
import numpy as np

import mne
加载连续数据#
正如入门教程中所述,MNE-Python 的数据结构基于 Neuromag 的 .fif 文件格式。本教程使用 .fif 格式的示例数据集,因此这里使用 mne.io.read_raw_fif() 函数加载原始数据;此外还有适用于多种其他数据格式的读取函数。
还有其他几个示例数据集只需几行代码即可下载。用于下载示例数据集的函数位于 mne.datasets 子模块中;这里我们使用 mne.datasets.sample.data_path() 下载“Sample”数据集,其中包含一名受试者执行视听实验时的 EEG、MEG 和结构 MRI 数据。下载完成后,data_path() 会返回文件所存放的文件夹路径;如果你想亲自查看这些文件,可以用文件浏览器导航到该路径。得到文件路径后,就可以用 read_raw_fif() 加载数据。该函数会返回一个 Raw 对象,我们将其存储在名为 raw 的变量中。
sample_data_folder = mne.datasets.sample.data_path()
sample_data_raw_file = os.path.join(
    sample_data_folder, "MEG", "sample", "sample_audvis_raw.fif"
)
raw = mne.io.read_raw_fif(sample_data_raw_file)
Opening raw data file /home/circleci/mne_data/MNE-sample-data/MEG/sample/sample_audvis_raw.fif...
    Read a total of 3 projection items:
        PCA-v1 (1 x 10²)  idle
        PCA-v2 (1 x 10²)  idle
        PCA-v3 (1 x 10²)  idle
    Range : 25800 ... 192599 =     42.956 ...   320.670 secs
Ready.
如上所示,read_raw_fif() 会自动显示所加载文件的一些信息。例如,这里它告诉我们文件中除记录数据外还有三个“投影项”(projection items);这些是为去除 MEG 信号中的环境噪声而计算的 SSP 投影器,详见教程《关于投影器与投影的背景知识》。除加载时显示的信息外,你还可以通过打印 Raw 对象来了解其基本信息:
print(raw)
<Raw | sample_audvis_raw.fif, 376 x 166800 (277.7 s), ~3.2 MiB, data not loaded>
默认情况下,mne.io.read_raw_* 系列函数不会将数据加载到内存中(磁盘上的数据采用内存映射方式,即仅在需要时才从磁盘读取)。某些操作(如滤波)要求数据被复制到 RAM 中;为此可以在调用 read_raw_fif() 时传入 preload=True 参数,也可以随时使用 load_data() 方法将数据复制到 RAM。不过,由于本教程不对数据进行深入分析,我们先用 crop() 将 Raw 对象裁剪到 60 秒,以减少内存占用并让文档服务器运行得更流畅。
raw.crop(tmax=60)
查询 Raw 对象#
上文我们看到,打印 Raw 对象会显示一些基本信息,如通道总数、数据采样的时间点数、总时长以及内存中的大致大小。Raw 类还通过其各种属性和方法提供更多信息。Raw 对象的一些有用属性包括通道名称列表(ch_names)、以秒为单位的采样时间数组(times)以及采样点总数(n_times);所有属性和方法的列表见 Raw 类的文档。
Raw.info 属性#
此外,raw.info 属性中还存储了大量信息,它保存一个 Info 对象,类似于 Python 字典(可通过命名键访问字段)。与 Python 字典一样,raw.info 有 .keys() 方法,可显示所有可用字段名;与 Python 字典不同的是,打印 raw.info 会以美观的格式显示每个字段数据的概览。有关 Info 对象中存储的内容以及如何与之交互的更多信息,请参阅《Info 数据结构》。
n_time_samps = raw.n_times
time_secs = raw.times
ch_names = raw.ch_names
n_chan = len(ch_names)  # note: there is no raw.n_channels attribute
print(
    f"the (cropped) sample data object has {n_time_samps} time samples and "
    f"{n_chan} channels."
)
print(f"The last time sample is at {time_secs[-1]} seconds.")
print("The first few channel names are {}.".format(", ".join(ch_names[:3])))
print()  # insert a blank line in the output

# some examples of raw.info:
print("bad channels:", raw.info["bads"])  # chs marked "bad" during acquisition
print(raw.info["sfreq"], "Hz")  # sampling frequency
print(raw.info["description"], "\n")  # miscellaneous acquisition info

print(raw.info)
the (cropped) sample data object has 36038 time samples and 376 channels.
The last time sample is at 60.000167471573526 seconds.
The first few channel names are MEG 0113, MEG 0112, MEG 0111.

bad channels: ['MEG 2443', 'EEG 053']
600.614990234375 Hz
acquisition (megacq) VectorView system at NMR-MGH

<Info | 21 non-empty values
 acq_pars: ACQch001 110113 ACQch002 110112 ACQch003 110111 ACQch004 110122 ...
 bads: 2 items (MEG 2443, EEG 053)
 ch_names: MEG 0113, MEG 0112, MEG 0111, MEG 0122, MEG 0123, MEG 0121, MEG ...
 chs: 204 Gradiometers, 102 Magnetometers, 9 Stimulus, 60 EEG, 1 EOG
 custom_ref_applied: False
 description: acquisition (megacq) VectorView system at NMR-MGH
 dev_head_t: MEG device -> head transform
 dig: 146 items (3 Cardinal, 4 HPI, 61 EEG, 78 Extra)
 events: 1 item (list)
 experimenter: MEG
 file_id: 4 items (dict)
 highpass: 0.1 Hz
 hpi_meas: 1 item (list)
 hpi_results: 1 item (list)
 lowpass: 172.2 Hz
 meas_date: 2002-12-03 19:01:10 UTC
 meas_id: 4 items (dict)
 nchan: 376
 proj_id: 1
 proj_name: test
 projs: PCA-v1: off, PCA-v2: off, PCA-v3: off
 sfreq: 600.6 Hz
>
注意
raw.info 的大多数字段反映采集时记录的元数据,用户不应更改。有少数例外(如 raw.info['bads'] 和 raw.info['projs']),但大多数情况下都有专门的 MNE-Python 函数或方法来安全地更新 Info 对象(例如用 add_proj() 更新 raw.info['projs'])。
时间、采样编号与采样索引#
Raw 对象有一个经常使用的方法 time_as_index(),它将以秒为单位的时间转换为最接近该时间的采样点的整数索引。该方法还可以接受时间列表或数组,并返回索引数组。
需要记住,所请求的时间点上可能并不存在数据采样点,因此 time = 1 秒与 time = 2 秒之间的采样点数可能与 time = 2 秒与 time = 3 秒之间的采样点数不同:
print(raw.time_as_index(20))
print(raw.time_as_index([20, 30, 40]), "\n")

print(np.diff(raw.time_as_index([1, 2, 3])))
[12012]
[12012 18018 24024]

[601 600]
修改 Raw 对象#
Raw 对象有许多方法会就地修改 Raw 实例并返回修改后实例的引用。这便于方法链式调用(例如 raw.crop(...).pick(...).filter(...).plot()),但在交互式分析中也会带来问题:如果你为了探索性绘图或分析而修改了 Raw 对象(比如删除了一些通道),之后就需要重新加载数据(并重复之前的处理步骤)才能撤销通道删除并尝试其他方案。因此,本节的示例常在演示其他方法之前先使用 copy() 方法,以便原始 Raw 对象仍保留在变量 raw 中供后续示例使用。
选择、删除与重排通道#
修改 Raw 对象的通道有几种方式。作为第一个例子,我们使用 pick() 方法将 Raw 对象限制为仅包含 EEG 和 EOG 通道:
eeg_and_eog = raw.copy().pick(picks=["eeg", "eog"])
print(len(raw.ch_names), "→", len(eeg_and_eog.ch_names))
376 → 61
此外,pick() 也可以按名称选择通道,并有相应的 drop_channels() 方法按名称删除通道:
raw_temp = raw.copy()
print("Number of channels in raw_temp:")
print(len(raw_temp.ch_names), end=" → drop two → ")
raw_temp.drop_channels(["EEG 037", "EEG 059"])
print(len(raw_temp.ch_names), end=" → pick three → ")
raw_temp.pick(["MEG 1811", "EEG 017", "EOG 061"])
print(len(raw_temp.ch_names))
Number of channels in raw_temp:
376 → drop two → 374 → pick three → 3
如果你希望通道按特定顺序排列(例如用于绘图),reorder_channels() 的用法与 pick() 类似,但还会重排通道;例如这里我们选择 EOG 和额区 EEG 通道,将 EOG 放在最前,EEG 则按相反顺序排列:
channel_names = ["EOG 061", "EEG 003", "EEG 002", "EEG 001"]
eog_and_frontal_eeg = raw.copy().reorder_channels(channel_names)
print(eog_and_frontal_eeg.ch_names)
['EOG 061', 'EEG 003', 'EEG 002', 'EEG 001']
更改通道名称与类型#
你可能已注意到,示例数据中的 EEG 通道名称是编号形式,而非按 10-20 或 10-05 等标准命名法标注;或者通道名称中包含空格让你感到不便。可以使用 rename_channels() 方法重命名通道,它接受一个 Python 字典,将旧名称映射为新名称。不必一次重命名所有通道;只需为要重命名的通道提供字典条目。下面是一个略显随意的例子:
raw.rename_channels({"EOG 061": "blink detector"})
下一个例子使用 Python 字典推导式将通道名称中的空格替换为下划线:
print(raw.ch_names[-3:])
channel_renaming_dict = {name: name.replace(" ", "_") for name in raw.ch_names}
raw.rename_channels(channel_renaming_dict)
print(raw.ch_names[-3:])
['EEG 059', 'EEG 060', 'blink detector']
['EEG_059', 'EEG_060', 'blink_detector']
如果由于某种原因 Raw 对象中的通道类型不准确,可以使用 set_channel_types() 方法更改任意通道的类型。该方法接受一个将通道名称映射到类型的字典;允许的类型有 bio、chpi、csd、dbs、dipole、ecg、ecog、eeg、emg、eog、exci、eyegaze、fnirs_cw_amplitude、fnirs_fd_ac_amplitude、fnirs_fd_phase、fnirs_od、gof、gsr、hbo、hbr、ias、misc、pupil、ref_meg、resp、seeg、stim、syst、temperature(关于这些类型的更多信息,请参阅传感器类型)。更改通道类型的一个常见用例,是将额区 EEG 电极用作临时的 EOG 通道:
raw.set_channel_types({"EEG_001": "eog"})
print(raw.copy().pick(picks="eog").ch_names)
['EEG_001', 'blink_detector']
时域选择#
如果要限制 Raw 对象的时间范围,可以使用 crop() 方法,它会就地修改 Raw 对象(我们在本教程开头已经见过,当时将 Raw 对象裁剪到 60 秒以减少内存需求)。crop() 接受 tmin 和 tmax 参数,均以秒为单位(这里我们同样先使用 copy(),以免更改原始 Raw 对象):
raw_selection = raw.copy().crop(tmin=10, tmax=12.5)
print(raw_selection)
<Raw | sample_audvis_raw.fif, 376 x 1503 (2.5 s), ~3.2 MiB, data not loaded>
crop() 还会修改 first_samp 和 times 属性,使裁剪后对象的第一个采样点现在对应于 time = 0。因此,如果你想把 raw_selection 重新裁剪为 11 到 12.5 秒(而不是上面的 10 到 12.5 秒),后续调用 crop() 时应使用 tmin=1(而不是 tmin=11),并且不指定 tmax,以保留从 tmin 到对象末尾的全部内容:
print(raw_selection.times.min(), raw_selection.times.max())
raw_selection.crop(tmin=1)
print(raw_selection.times.min(), raw_selection.times.max())
0.0 2.500770084699155
0.0 1.5001290587975622
请记住,由于采样的原因,采样时间并不总是与请求的 tmin 或 tmax 值精确对齐,这就是裁剪后文件的最大值与请求的 tmax 不完全一致的原因(详见“时间、采样编号与采样索引”一节)。
如果你需要选择 Raw 对象中不连续的片段——或合并两个或多个独立的 Raw 对象——可以使用 append() 方法:
raw_selection1 = raw.copy().crop(tmin=30, tmax=30.1)  # 0.1 seconds
raw_selection2 = raw.copy().crop(tmin=40, tmax=41.1)  # 1.1 seconds
raw_selection3 = raw.copy().crop(tmin=50, tmax=51.3)  # 1.3 seconds
raw_selection1.append([raw_selection2, raw_selection3])  # 2.5 seconds total
print(raw_selection1.times.min(), raw_selection1.times.max())
0.0 2.5041000049184614
从 Raw 对象中提取数据#
到目前为止,我们一直在讨论修改 Raw 对象的方法。本节介绍如何将数据从 Raw 对象提取为 NumPy 数组,以便使用 MNE-Python 之外的函数进行分析或绘图。要选择数据的一部分,可以用方括号对 Raw 对象进行索引。不过,Raw 的索引在两个方面与 NumPy 数组不同:
除了请求的采样值外,MNE-Python 还会返回与所请求采样点对应的时间数组(以秒为单位)。数据数组和时间数组作为一个元组的元素一起返回。
即使只请求单个时间采样点或单个通道,数据数组也始终是二维的。
按索引提取数据#
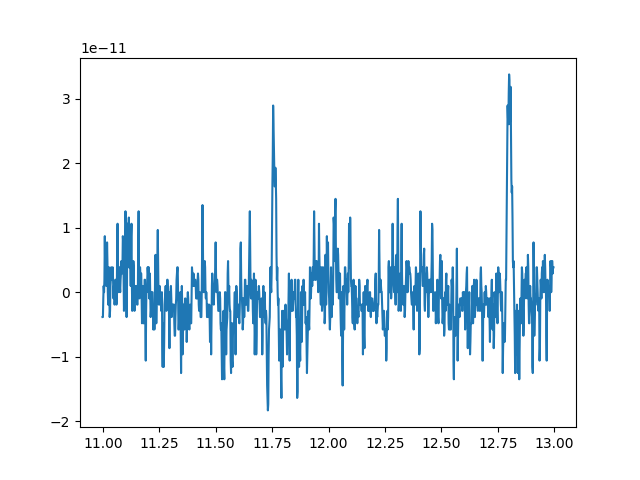
为说明上述两点,我们从第一个通道中选取几秒钟的数据:
sampling_freq = raw.info["sfreq"]
start_stop_seconds = np.array([11, 13])
start_sample, stop_sample = (start_stop_seconds * sampling_freq).astype(int)
channel_index = 0
raw_selection = raw[channel_index, start_sample:stop_sample]
print(raw_selection)
(array([[-3.85742192e-12, -3.85742192e-12, -9.64355481e-13, ...,
         2.89306644e-12,  3.85742192e-12,  3.85742192e-12]],
      shape=(1, 1201)), array([10.99872648, 11.00039144, 11.0020564 , ..., 12.9933487 ,
       12.99501366, 12.99667862], shape=(1201,)))
可以看到它包含 2 个数组。数据与时间的这种组合便于绘制原始数据的选定片段(不过请注意,我们对数据数组进行了转置,使每个通道成为一列而不是一行,以符合 matplotlib 在绘制二维 y 对一维 x 时的预期):
x = raw_selection[1]
y = raw_selection[0].T
plt.plot(x, y)
按名称提取通道#
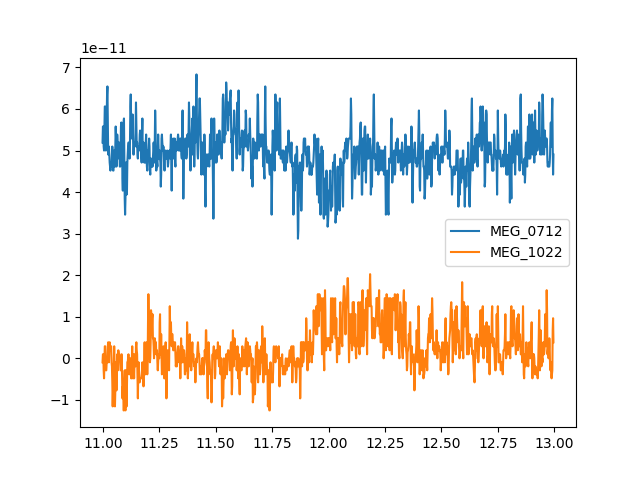
也可以使用通道名称而非索引编号对 Raw 对象进行索引。可以传入单个字符串以获取一个通道,或传入字符串列表以选择多个通道。与整数索引一样,这会返回易于绘制的 (data_array, times_array) 元组。由于这次要绘制 2 个通道,我们给其中一个通道加上垂直偏移,以免它与其他通道完全重叠:
channel_names = ["MEG_0712", "MEG_1022"]
two_meg_chans = raw[channel_names, start_sample:stop_sample]
y_offset = np.array([5e-11, 0])  # just enough to separate the channel traces
x = two_meg_chans[1]
y = two_meg_chans[0].T + y_offset
lines = plt.plot(x, y)
plt.legend(lines, channel_names)
按类型提取通道#
有多种方法可以从 Raw 对象中选择某一类型的所有通道。最安全的方法是使用 mne.pick_types() 获取所需通道的整数索引,然后将这些索引用于上面介绍的方括号索引方法。pick_types() 函数使用 Raw 对象的 Info 属性确定通道类型,并接受布尔或字符串参数以指明保留哪种类型。meg 参数默认为 True,其余参数默认为 False,因此要仅获取 EEG 通道,我们传入 eeg=True 和 meg=False:
eeg_channel_indices = mne.pick_types(raw.info, meg=False, eeg=True)
eeg_data, times = raw[eeg_channel_indices]
print(eeg_data.shape)
(58, 36038)
mne.pick_types() 的部分参数除布尔值外还接受字符串参数。例如 meg 参数可取 'mag'、'grad'、'planar1' 或 'planar2',以仅选择磁强计、所有梯度计或某一特定类型的梯度计。完整细节见 mne.pick_types() 的文档字符串。
Raw.get_data() 方法#
如果你只需要数据(而不需要对应的时间数组),Raw 对象有 get_data() 方法。在不指定任何参数时,它会以 (n_channels, n_timepoints) 的 NumPy 数组提取所有通道的所有数据:
data = raw.get_data()
print(data.shape)
(376, 36038)
如果需要时间数组,get_data() 有一个可选的 return_times 参数:
data, times = raw.get_data(return_times=True)
print(data.shape)
print(times.shape)
(376, 36038)
(36038,)
get_data() 方法还可以通过其 picks、start 和 stop 参数提取特定通道和采样范围。picks 参数接受整数通道索引、通道名称或通道类型,并保持 picks 参数中给出的通道顺序。
first_channel_data = raw.get_data(picks=0)
eeg_and_eog_data = raw.get_data(picks=["eeg", "eog"])
two_meg_chans_data = raw.get_data(picks=["MEG_0712", "MEG_1022"], start=1000, stop=2000)

print(first_channel_data.shape)
print(eeg_and_eog_data.shape)
print(two_meg_chans_data.shape)
(1, 36038)
(61, 36038)
(2, 1000)
从 Raw 对象提取数据的方法总结#
下表总结了从 Raw 对象提取数据的各种方式。
| Python 代码 | 结果 |
|---|---|
|
NumPy 数组(n_chans × n_samps) |
|
元组 (data (n_chans × n_samps), times (1 × n_samps)) |
|
|
|
元组 (data (1 × 1000), times (1 × 1000)) |
|
|
|
|
|
|
|
元组 (data (2 × 1000), times (1 × 1000)) |
|
|
|
导出与保存 Raw 对象#
Raw 对象有内置的 save() 方法,可用于将部分处理过的 Raw 对象以 .fif 文件写入磁盘,以便日后重新加载时其各种属性保持完好(但关于保存时数值精度的重要说明,请参阅“浮点精度”)。
还有其他几种方法可以仅导出 Raw 对象中的传感器数据。一种是使用索引或 get_data() 方法提取数据,并用 numpy.save() 保存数据数组:
data = raw.get_data()
np.save(file="my_data.npy", arr=data)
也可以将数据导出为 Pandas DataFrame 对象,并使用 Pandas 提供的保存方法。Raw 对象的 to_data_frame() 方法与 get_data() 类似,它有 picks 参数用于限制导出哪些通道,以及 start 和 stop 参数用于限制时间范围。注意,默认情况下时间会转换为毫秒、四舍五入到最近的毫秒,并用作 DataFrame 的索引;更多细节请参阅 to_data_frame() 文档中的 scaling_time 参数。
sampling_freq = raw.info["sfreq"]
start_end_secs = np.array([10, 13])
start_sample, stop_sample = (start_end_secs * sampling_freq).astype(int)
df = raw.to_data_frame(picks=["eeg"], start=start_sample, stop=stop_sample)
# then save using df.to_csv(...), df.to_hdf(...), etc
print(df.head())
        time       EEG_002  ...       EEG_059       EEG_060
0   9.999750  3.847885e+08  ...  5.243790e+08  6.952283e+08
1  10.001415  3.612900e+08  ...  5.200958e+08  7.069226e+08
2  10.003080  3.589401e+08  ...  5.176483e+08  7.080921e+08
3  10.004745  3.724518e+08  ...  5.182602e+08  7.010755e+08
4  10.006410  3.847885e+08  ...  5.286621e+08  7.069226e+08

[5 rows x 60 columns]
注意
将数据导出为 NumPy 数组或 Pandas DataFrame 时,务必在后续分析中正确处理表示单位。