
注意
转到末尾下载完整示例代码。
Epochs 数据结构:不连续数据#
本教程介绍创建和处理分段数据(epoched data)的基础知识,详细讲解 Epochs 数据结构,包括如何从 Epochs 对象加载、查询、选取、导出和绘制数据。有关 Epochs 对象可视化的更多内容,请参阅 可视化分段数据(Epochs)。有关从 NumPy 数组(可能是模拟数据)创建 Epochs 对象的信息,请参阅 从零创建 MNE-Python 数据结构。
和往常一样,我们首先导入所需的模块:
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import mne
Epochs 对象是一种用于表示和分析 EEG/MEG 信号中等时长数据段的数据结构。Epochs 最常用于表示与重复实验事件(如刺激起始或被试按键)时间锁定的数据,但也可用于存储连续信号的顺序帧或重叠帧(例如分析静息态活动;参见 Making equally-spaced Events arrays)。在 Epochs 对象内部,数据存储在一个形状为 (n_epochs, n_channels, n_times) 的数组中。
它们可以以
.fif格式从磁盘加载或保存到磁盘,其数据可以通过get_data()方法导出为NumPy数组,或通过to_data_frame()方法导出为Pandas DataFrame。Epochs和Raw对象都支持按索引或名称选择通道,包括pick()、pick_channels()和pick_types()方法。可以通过
add_proj()、del_proj()和plot_projs_topomap()方法操作 SSP 投影器。Epochs和Raw对象都有copy()、crop()、time_as_index()、filter()、resample()和compute_psd()方法。Epochs和Raw对象都有内置绘图方法plot(),以及旧版绘图方法plot_psd()和plot_psd_topomap()(在新代码中,PSD 绘图通过Spectrum类完成)。
从 Raw 对象创建 Epochs 数据#
到目前为止我们使用的示例数据集不包含预先分段的(pre-epoched)数据,因此本节将加载连续数据,并根据 Raw 对象 STIM 通道中记录的事件创建 epochs。正如这些教程中常做的那样,我们会用 crop() 裁剪 Raw 数据以节省内存:
sample_data_folder = mne.datasets.sample.data_path()
sample_data_raw_file = sample_data_folder / "MEG" / "sample" / "sample_audvis_raw.fif"
raw = mne.io.read_raw_fif(sample_data_raw_file, verbose=False).crop(tmax=60)
正如在 从原始数据中解析事件 教程中所见,我们可以使用 mne.find_events() 从 Raw 对象中提取事件数组:
events = mne.find_events(raw, stim_channel="STI 014")
Finding events on: STI 014
86 events found on stim channel STI 014
Event IDs: [ 1  2  3  4  5 32]
注意
我们也可以使用 mne.read_events() 从文件中加载事件:
sample_data_events_file = os.path.join(sample_data_folder,
                                       'MEG', 'sample',
                                       'sample_audvis_raw-eve.fif')
events_from_file = mne.read_events(sample_data_events_file)
Raw 对象和事件数组是创建 Epochs 对象所需的最基本要素,我们通过 mne.Epochs 类构造函数来创建它。不过,你几乎肯定想修改其他一些默认参数。这里我们将修改 tmin 和 tmax(相对于每个事件的开始和结束时间)。另请注意,Epochs 构造函数接受 reject 和 flat 参数,用于根据信号幅度剔除单个 epoch。示例见 Rejecting Epochs based on peak-to-peak channel amplitude 一节。
epochs = mne.Epochs(raw, events, tmin=-0.3, tmax=0.7)
Not setting metadata
86 matching events found
Setting baseline interval to [-0.2996928197375818, 0.0] s
Applying baseline correction (mode: mean)
Created an SSP operator (subspace dimension = 3)
3 projection items activated
从输出中可以看到:
全部 320 个事件都用于创建 epochs
自动应用了基线校正(默认情况下,基线定义为从
tmin到0的时间段,但可以通过baseline参数自定义)未提供额外的元数据(详见 处理 Epoch 元数据)
如果打印 Epochs 对象,还会看到一条说明:默认情况下 epochs 不会复制到内存中;此外还会看到每个整数 Event ID 所创建的 epoch 数量。
print(epochs)
<Epochs | 86 events (good & bad), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~3.2 MiB, data not loaded,
 '1': 20
 '2': 20
 '3': 20
 '4': 18
 '5': 4
 '32': 4>
注意 Event ID 带有引号;由于我们没有提供事件字典,mne.Epochs 构造函数自动创建了一个,并将整数 Event ID 的字符串表示用作字典键。查看 event_id 属性时会更清楚:
print(epochs.event_id)
{'1': 1, '2': 2, '3': 3, '4': 4, '5': 5, '32': 32}
这次我们传入 preload=True 并提供事件字典;我们提供的字典将存储为 event_id 属性,使引用事件和跨事件类型合并更加容易:
event_dict = {
    "auditory/left": 1,
    "auditory/right": 2,
    "visual/left": 3,
    "visual/right": 4,
    "face": 5,
    "buttonpress": 32,
}
epochs = mne.Epochs(raw, events, tmin=-0.3, tmax=0.7, event_id=event_dict, preload=True)
print(epochs.event_id)
del raw  # we're done with raw, free up some memory
Not setting metadata
86 matching events found
Setting baseline interval to [-0.2996928197375818, 0.0] s
Applying baseline correction (mode: mean)
Created an SSP operator (subspace dimension = 3)
3 projection items activated
Loading data for 86 events and 601 original time points ...
1 bad epochs dropped
{'auditory/left': 1, 'auditory/right': 2, 'visual/left': 3, 'visual/right': 4, 'face': 5, 'buttonpress': 32}
注意输出中现在提到“1 bad epoch dropped”。在教程 Rejecting Epochs based on peak-to-peak channel amplitude 一节中,我们了解了如何指定通道幅度标准来剔除 epochs,但这里我们没有指定任何此类标准。在本例中,最后一个事件距离(裁剪后的)原始文件末尾太近,无法容纳我们要求的 tmax 为 0.7 秒,因此最后一个 epoch 因过短而被丢弃。以下是最后 4 个 epoch 的 drop_log 条目(空列表表示未被丢弃的 epoch):
print(epochs.drop_log[-4:])
((), (), (), ('TOO_SHORT',))
Epochs 对象的基本可视化#
可以使用 Epochs 对象的 plot() 方法对其进行可视化(并交互式浏览):
epochs.plot(n_epochs=10, events=True)
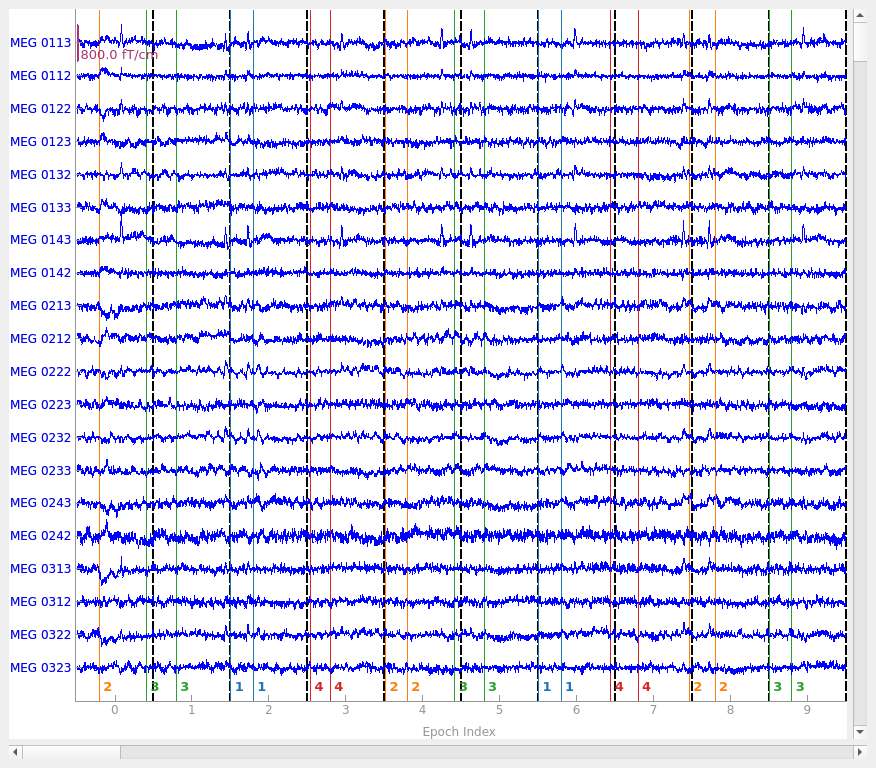
You seem to have overlapping epochs. Some event lines may be duplicated in the plot.
注意各个 epoch 沿底部轴按顺序编号,并由垂直虚线分隔。Epoch 图是交互式的(类似于 raw.plot()),并与 Raw 图有许多相同的交互控件。水平和垂直滚动条分别用于浏览 epochs 或通道;当绘图窗口获得焦点时按 ? 会显示包含所有可用控件的帮助界面。更多细节(以及其他可视化分段数据的方式)请参阅 可视化分段数据(Epochs)。
选取 epoch 子集#
现在我们已经有了带有描述性事件标签的 Epochs 对象,可以使用方括号轻松选取 epoch 子集。例如,我们可以加载所有刺激为面孔的“catch trials”:
print(epochs["face"])
<Epochs | 4 events (all good), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~10.1 MiB, data loaded,
 'face': 4>
得益于 MNE-Python 对 epoch 标签中 / 字符的处理方式(有时称为“基于标签的索引”),我们也可以轻松地跨条件合并:
<Epochs | 40 events (all good), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~72.2 MiB, data loaded,
 'auditory/left': 20
 'auditory/right': 20>
<Epochs | 39 events (all good), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~70.4 MiB, data loaded,
 'auditory/left': 20
 'visual/left': 19>
你也可以通过以列表形式传入多个标签来合并条件。请注意,只要能够找到某种匹配,即使请求对象中不存在的标签,MNE-Python 也不会报错:下面的示例被解析为(包含式的)'right' 或 'bottom',从输出中可以看到它只选择了 auditory/right 和 visual/right。
print(epochs[["right", "bottom"]])
<Epochs | 38 events (all good), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~68.7 MiB, data loaded,
 'auditory/right': 20
 'visual/right': 18>
但是,如果找不到任何匹配,就会返回错误:
try:
    print(epochs[["top", "bottom"]])
except KeyError:
    print("Tag-based selection with no matches raises a KeyError!")
Tag-based selection with no matches raises a KeyError!
按索引选择 epoch#
Epochs 对象也可以用整数、slice 或整数列表进行索引。这种选择方式忽略事件标签,因此如果你想获取某一类型的前 10 个 epochs,可以先选择该类型,再使用整数或切片:
<Epochs | 10 events (all good), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~20.5 MiB, data loaded,
 'auditory/left': 2
 'auditory/right': 3
 'visual/left': 3
 'visual/right': 2>
<Epochs | 4 events (all good), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~10.1 MiB, data loaded,
 'visual/left': 2
 'visual/right': 2>
<Epochs | 4 events (all good), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~10.1 MiB, data loaded,
 'buttonpress': 4>
<Epochs | 4 events (all good), -0.3 – 0.699 s (baseline -0.3 – 0 s), ~10.1 MiB, data loaded,
 'buttonpress': 4>
选择、删除和重排通道#
你可以使用 pick()、pick_channels()、pick_types() 和 drop_channels() 方法来修改 Epochs 对象中包含哪些通道。也可以为此使用 reorder_channels();未提供给 reorder_channels() 的任何通道名称都将被删除。请注意,这些通道选择方法会就地修改对象(与上面看到的用方括号索引选择 epochs 不同),因此在交互式/探索性会话中,你可能希望先创建一个 copy()。
epochs_eeg = epochs.copy().pick(picks="eeg")
print(epochs_eeg.ch_names)

new_order = ["EEG 002", "STI 014", "EOG 061", "MEG 2521"]
epochs_subset = epochs.copy().reorder_channels(new_order)
print(epochs_subset.ch_names)
['EEG 001', 'EEG 002', 'EEG 003', 'EEG 004', 'EEG 005', 'EEG 006', 'EEG 007', 'EEG 008', 'EEG 009', 'EEG 010', 'EEG 011', 'EEG 012', 'EEG 013', 'EEG 014', 'EEG 015', 'EEG 016', 'EEG 017', 'EEG 018', 'EEG 019', 'EEG 020', 'EEG 021', 'EEG 022', 'EEG 023', 'EEG 024', 'EEG 025', 'EEG 026', 'EEG 027', 'EEG 028', 'EEG 029', 'EEG 030', 'EEG 031', 'EEG 032', 'EEG 033', 'EEG 034', 'EEG 035', 'EEG 036', 'EEG 037', 'EEG 038', 'EEG 039', 'EEG 040', 'EEG 041', 'EEG 042', 'EEG 043', 'EEG 044', 'EEG 045', 'EEG 046', 'EEG 047', 'EEG 048', 'EEG 049', 'EEG 050', 'EEG 051', 'EEG 052', 'EEG 053', 'EEG 054', 'EEG 055', 'EEG 056', 'EEG 057', 'EEG 058', 'EEG 059', 'EEG 060']
['EEG 002', 'STI 014', 'EOG 061', 'MEG 2521']
del epochs_eeg, epochs_subset
修改通道名称和类型#
你可以使用 rename_channels() 或 set_channel_types() 修改通道的名称或类型。这两个方法都接受字典,其中键是现有通道名称,值是该通道的新名称(或类型)。字典中未包含的现有通道将保持不变。
epochs.rename_channels({"EOG 061": "BlinkChannel"})

epochs.set_channel_types({"EEG 060": "ecg"})
print(list(zip(epochs.ch_names, epochs.get_channel_types()))[-4:])
[('EEG 058', 'eeg'), ('EEG 059', 'eeg'), ('EEG 060', 'ecg'), ('BlinkChannel', 'eog')]
# let's set them back to the correct values before moving on
epochs.rename_channels({"BlinkChannel": "EOG 061"})
epochs.set_channel_types({"EEG 060": "eeg"})
时间域上的选取#
要更改 Epochs 的时间范围,可以使用 crop() 方法:
shorter_epochs = epochs.copy().crop(tmin=-0.1, tmax=0.1, include_tmax=True)

for name, obj in dict(Original=epochs, Cropped=shorter_epochs).items():
    print(f"{name} epochs has {obj.get_data(copy=False).shape[-1]} time samples")
Original epochs has 601 time samples
Cropped epochs has 121 time samples
裁剪操作移除了部分基线。打印裁剪后的 Epochs 时,MNE-Python 会通过显示字符串“baseline period cropped after baseline correction”来告知你原本用于执行基线校正的时间段:
print(shorter_epochs)
<Epochs | 85 events (all good), -0.1 – 0.1 s (baseline -0.3 – 0 s (baseline period was cropped after baseline correction)), ~32.7 MiB, data loaded,
 'auditory/left': 20
 'auditory/right': 20
 'visual/left': 19
 'visual/right': 18
 'face': 4
 'buttonpress': 4>
不过,如果你想扩展 Epochs 对象的时间范围,则需回到 Raw 数据,并使用不同的 tmin 和/或 tmax 值重新创建 Epochs。
还可以使用 shift_time() 方法更改定义 Epochs 对象中时间值的“零点”。shift_time() 允许相对于当前值平移时间,或指定一个固定时间作为第一个样本的新时间值(并根据 Epochs 对象的采样频率推导后续样本的新时间值)。
# shift times so that first sample of each epoch is at time zero
later_epochs = epochs.copy().shift_time(tshift=0.0, relative=False)
print(later_epochs.times[:3])

# shift times by a relative amount
later_epochs.shift_time(tshift=-7, relative=True)
print(later_epochs.times[:3])
[0.         0.00166496 0.00332992]
[-7.         -6.99833504 -6.99667008]
del shorter_epochs, later_epochs
请注意,尽管时间平移会遵循采样频率(样本之间的间隔),但它并不强制假设在 time=0 处恰好存在一个样本。
以其他形式提取数据#
get_data() 方法以 NumPy 数组形式返回分段数据,形状为 (n_epochs, n_channels, n_times);可选的 picks 参数可按索引、名称或类型选择通道子集:
eog_data = epochs.get_data(picks="EOG 061")
meg_data = epochs.get_data(picks=["mag", "grad"])
channel_4_6_8 = epochs.get_data(picks=slice(4, 9, 2))

for name, arr in dict(EOG=eog_data, MEG=meg_data, Slice=channel_4_6_8).items():
    print(f"{name} contains {arr.shape[1]} channels")
EOG contains 1 channels
MEG contains 305 channels
Slice contains 3 channels
请注意,如果你的分析需要反复从 Epochs 对象中提取单个 epoch,那么 epochs.get_data(item=2) 会比 epochs[2].get_data() 快得多,因为它避免了先对 Epochs 对象进行子集化的步骤。
你也可以将 Epochs 数据导出为 Pandas DataFrame。此时,DataFrame 的索引会将每个样本的时间转换为毫秒并四舍五入到最接近的整数,然后与事件类型和 epoch 编号组合,形成分层的 MultiIndex。每个通道会出现在单独的列中。随后你可以使用 Pandas 的任意工具对数据进行分组和聚合;例如,这里我们选择 auditory/left 条件中编号小于等于 10 的 epochs,并提取通道 EEG 056 至 EEG 058 在 100 至 107 ms 之间的时间(注意,Pandas loc 中的切片索引包含端点):
df = epochs.to_data_frame(index=["condition", "epoch", "time"])
df.sort_index(inplace=True)
print(df.loc[("auditory/left", slice(0, 10), slice(100, 107)), "EEG 056":"EEG 058"])

del df
Empty DataFrame
Columns: [EEG 056, EEG 057, EEG 058]
Index: []
有关 to_data_frame() 方法的更多示例,请参阅 将 Epochs 导出为 Pandas DataFrame 教程。
从磁盘加载和保存 Epochs 对象#
与 Raw 对象一样,Epochs 对象可以使用 mne.read_epochs() 函数和 save() 方法以 .fif 格式加载和保存。也有用于加载在 MNE-Python 之外进行分段的数据的函数,例如 mne.read_epochs_eeglab() 和 mne.read_epochs_kit()。
epochs.save("saved-audiovisual-epo.fif", overwrite=True)
epochs_from_file = mne.read_epochs("saved-audiovisual-epo.fif", preload=False)
Reading /home/circleci/project/tutorials/epochs/saved-audiovisual-epo.fif ...
    Read a total of 3 projection items:
        PCA-v1 (1 x 10²) active
        PCA-v2 (1 x 10²) active
        PCA-v3 (1 x 10²) active
    Found the data of interest:
        t =    -299.69 ...     699.28 ms
        0 CTF compensation matrices available
Not setting metadata
85 matching events found
No baseline correction applied
Created an SSP operator (subspace dimension = 3)
3 projection items activated
MNE-Python 对 epochs 文件的命名约定是:文件基本名(.fif 或 .fif.gz 扩展名之前的部分)应以 -epo 或 _epo 结尾;如果你提供的文件名不符合该约定,将会发出警告。
最后需要注意,当 epochs 从磁盘加载而不是由 Raw 对象生成时,epochs 对象的类是不同的:
print(type(epochs))
print(type(epochs_from_file))
<class 'mne.epochs.Epochs'>
<class 'mne.epochs.EpochsFIF'>
在几乎所有情况下,这都不需要修改你的代码。但是,如果需要对 epochs 对象进行类型检查,可以针对这些类所派生的基类进行测试:
print(
    all(
        [
            isinstance(epochs, mne.BaseEpochs),
            isinstance(epochs_from_file, mne.BaseEpochs),
        ]
    )
)
True
遍历 Epochs#
遍历 Epochs 对象会得到数组,而不是单试次的 Epochs 对象:
<class 'numpy.ndarray'>
<class 'numpy.ndarray'>
<class 'numpy.ndarray'>
如果你想遍历 Epochs 对象,可以使用整数索引作为迭代器:
<class 'mne.epochs.Epochs'>
<class 'mne.epochs.Epochs'>
<class 'mne.epochs.Epochs'>
脚本总运行时间:(0 分钟 1.387 秒)