
注意
转到末尾下载完整示例代码。
EEG 分析:事件相关电位(ERP)#
本教程展示如何在 MNE-Python 中执行标准的 ERP 分析。这里的大部分内容在其他教程中也有涉及,但为了方便,我们将 ERP 分析中最有用的函数和方法汇集于此,并在需要更详细说明的地方链接到其他教程。
和往常一样,我们先导入所需的模块并加载一些示例数据。我们不会像本教程那样从原始数据的刺激通道中解析事件,而是从外部事件文件加载事件。最后,为了加快计算速度,我们将把原始数据从约 4.5 分钟裁剪到 90 秒。
# Authors: The MNE-Python contributors.
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

import mne

root = mne.datasets.sample.data_path() / "MEG" / "sample"
raw_file = root / "sample_audvis_filt-0-40_raw.fif"
raw = mne.io.read_raw_fif(raw_file, preload=False)

events_file = root / "sample_audvis_filt-0-40_raw-eve.fif"
events = mne.read_events(events_file)

raw.crop(tmax=90)  # in seconds (happens in-place)
# discard events >90 seconds (not strictly necessary, but avoids some warnings)
events = events[events[:, 0] <= raw.last_samp]
Opening raw data file /home/circleci/mne_data/MNE-sample-data/MEG/sample/sample_audvis_filt-0-40_raw.fif...
    Read a total of 4 projection items:
        PCA-v1 (1 x 10²)  idle
        PCA-v2 (1 x 10²)  idle
        PCA-v3 (1 x 10²)  idle
        Average EEG reference (1 x 60)  idle
    Range : 6450 ... 48149 =     42.956 ...   320.665 secs
Ready.
我们加载的文件已经过部分处理:三维传感器位置已作为 .fif 文件的一部分保存,数据已在 40 Hz 处进行低通滤波,并且为 EEG 通道设置了共同平均参考,以投影器的形式存储(关于何时可能需要这样做,请参阅 设置 EEG 参考 教程中的 Creating the average reference as a projector)。我们将在下文讨论如何完成上述每一步。
由于这是 EEG/MEG 联合数据集,我们先只保留 EEG 和 EOG 通道。这会移除文件中保存的其他投影器(它们仅适用于磁力计通道)。查看测量信息可以看到,我们现在有 59 个 EEG 通道和 1 个 EOG 通道。
Reading 0 ... 13514 = 0.000 ... 90.001 secs...
通道名称与类型#
在实践中,常有被标记为 EEG 但实际上是 EOG 的通道。Raw 对象提供了 set_channel_types() 方法,可用于将误标为 eeg 的通道改为 eog。
你也可以使用 rename_channels() 重命名通道。这两个方法的详细示例见教程 Raw 数据结构:连续数据。
在我们的数据集中,所有通道类型都已正确。因此,我们只需去掉通道名称中的空格和前导零,并转换为小写:
channel_renaming_dict = {name: name.replace(" 0", "").lower() for name in raw.ch_names}
_ = raw.rename_channels(channel_renaming_dict)  # happens in-place
注意
这里将结果赋给临时名称 _(即 _ = 部分),是为了抑制 Raw 对象的自动打印。在交互式分析中你不必这样做。
通道位置#
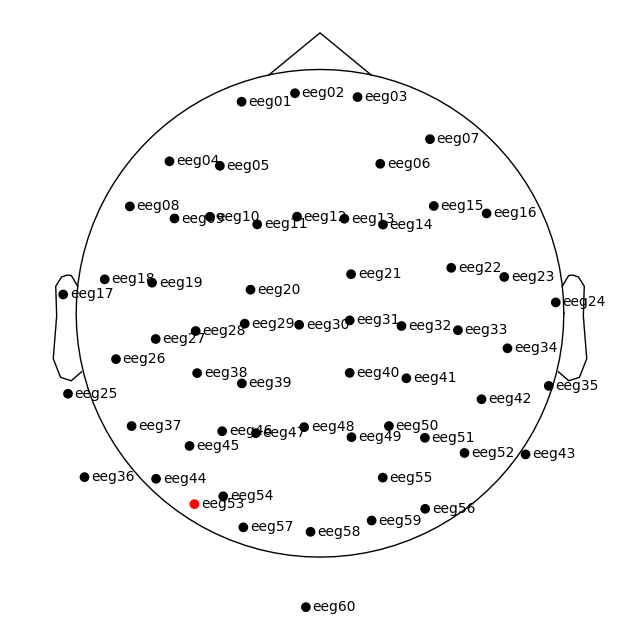
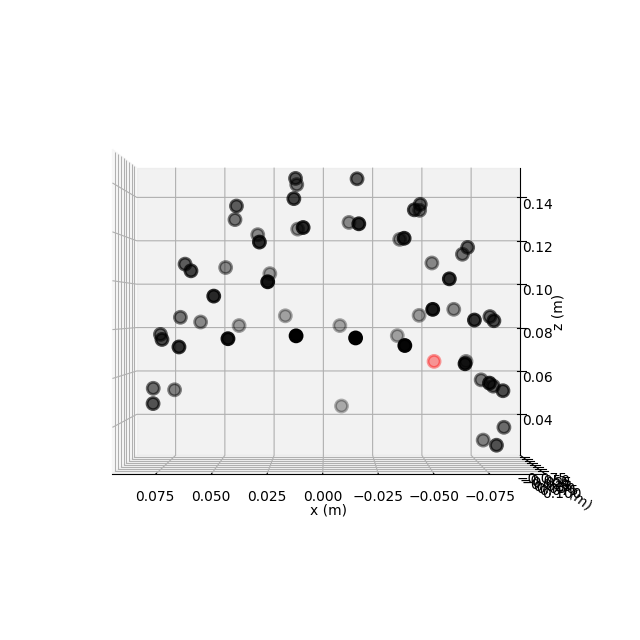
教程 处理传感器位置 详细介绍了传感器位置的处理方式。简要来说:MNE-Python 区分蒙太奇(montage,包含以米为单位的三维传感器位置 x、y 和 z)与布局(layout,定义用于绘制示意性传感器位置图的二维传感器排布)。此外,蒙太奇可以指定理想化传感器位置(例如基于理想球头模型),也可以包含在实际受试者头部放置传感器时数字化得到的三维真实位置。
该数据集将真实数字化三维传感器位置作为 .fif 文件的一部分保存,因此我们可以使用 plot_sensors() 方法以二维或三维方式查看传感器位置:
raw.plot_sensors(show_names=True)
fig = raw.plot_sensors("3d")
如果你使用的是 10–20 系统等标准蒙太奇,可以通过 raw.set_montage('spherical_1020') 将传感器位置添加到数据中(有关 MNE-Python 内置的其他标准蒙太奇,请参阅 处理传感器位置)。
如果你有数字化得到的真实传感器位置,可以使用专门的函数将这些数字化文件加载到 MNE-Python 中(讨论见 Reading sensor digitization files,支持的格式列表见 Supported formats for digitized 3D locations)。加载后,可将得到的蒙太奇对象传给 set_montage(),把数字化传感器位置添加到数据中。
设置 EEG 参考#
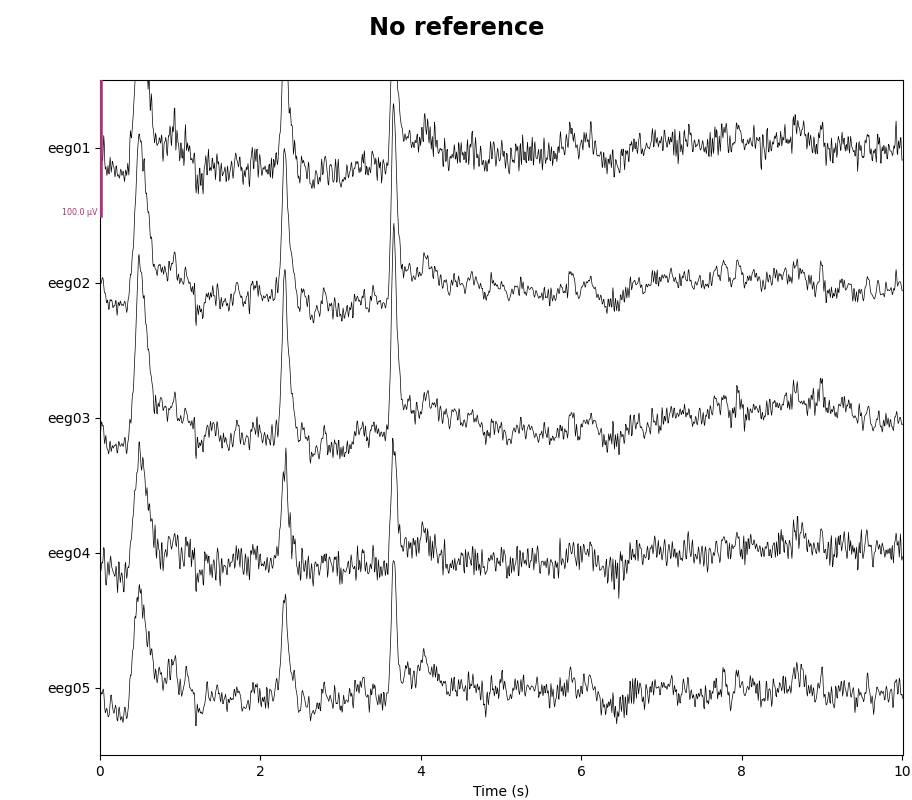
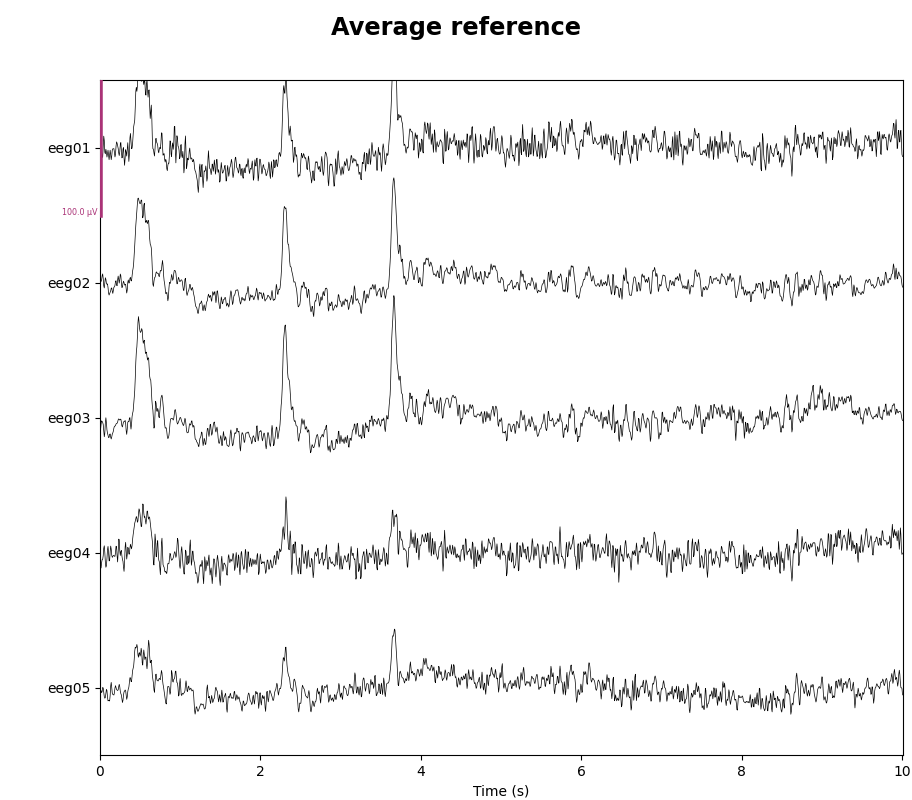
如前所述,该数据已以投影器形式添加了 EEG 共同平均参考。我们可以分别绘制应用和不应用该投影器的原始数据,以查看其效果:
for proj in (False, True):
    with mne.viz.use_browser_backend("matplotlib"):
        fig = raw.plot(
            n_channels=5, proj=proj, scalings=dict(eeg=50e-6), show_scrollbars=False
        )
    fig.subplots_adjust(top=0.9)  # make room for title
    ref = "Average" if proj else "No"
    fig.suptitle(f"{ref} reference", size="xx-large", weight="bold")
Using matplotlib as 2D backend.
Using qt as 2D backend.
Using matplotlib as 2D backend.
Using qt as 2D backend.
参考方案可以用 mne.set_eeg_reference() 函数(默认对数据的副本操作)或 raw.set_eeg_reference() 方法(总是原地修改数据)来更改。教程 设置 EEG 参考 给出了多个示例。
滤波#
MNE-Python 对不同的数据滤波方式提供了广泛支持。关于滤波器特性和 MNE-Python 默认值的总体讨论,请参阅 滤波背景知识。关于如何对数据应用滤波器的实际示例,请参阅 滤波与重采样。这里我们应用一个简单的高通滤波器作为示例:
raw.filter(l_freq=0.1, h_freq=None)
Filtering raw data in 1 contiguous segment
Setting up high-pass filter at 0.1 Hz

FIR filter parameters
---------------------
Designing a one-pass, zero-phase, non-causal highpass filter:
- Windowed time-domain design (firwin) method
- Hamming window with 0.0194 passband ripple and 53 dB stopband attenuation
- Lower passband edge: 0.10
- Lower transition bandwidth: 0.10 Hz (-6 dB cutoff frequency: 0.05 Hz)
- Filter length: 4957 samples (33.013 s)
诱发响应:分段与叠加平均#
从连续数据提取诱发响应的一般流程是:使用 Epochs 构造器,然后对得到的 epoch 进行平均以创建 Evoked 对象。在 MNE-Python 中,事件表示为 NumPy 数组,包含事件潜伏期(以采样点为单位)和整数事件编码。事件编码存储在 events 数组的最后一列:
处理事件 教程更详细地讨论了事件数组。整数事件编码通过一个通常称为 event_id 的 Python 字典映射为更具描述性的文本。该映射由你的实验决定(即它反映你选择用哪些事件编码来表示不同的实验事件或条件)。Sample data 使用以下映射:
event_dict = {
    "auditory/left": 1,
    "auditory/right": 2,
    "visual/left": 3,
    "visual/right": 4,
    "face": 5,
    "buttonpress": 32,
}
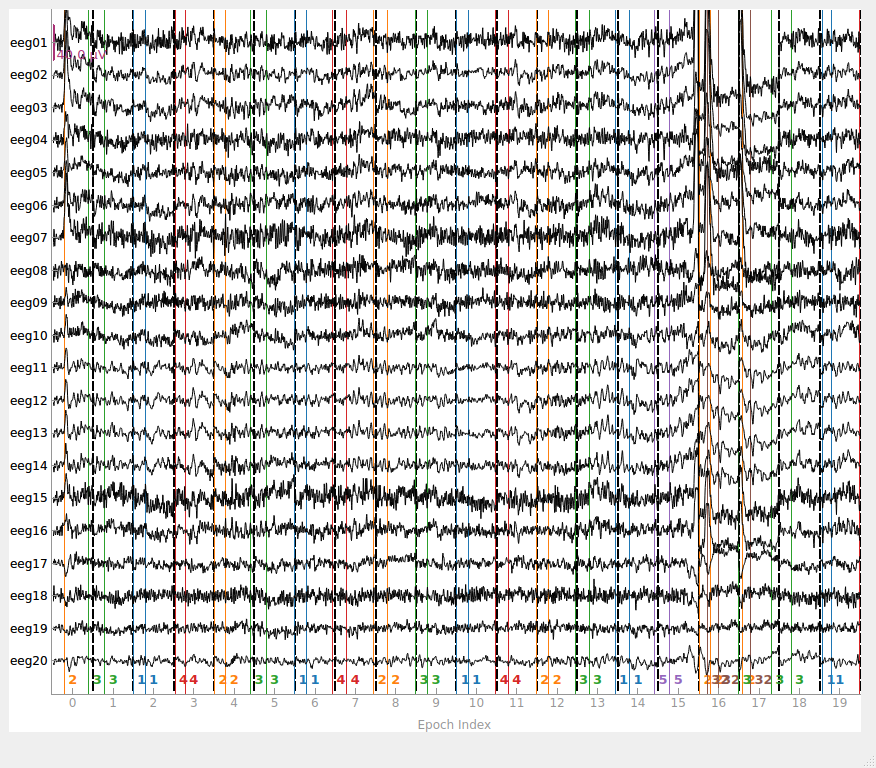
现在我们可以对连续数据进行分段。交互式绘图允许我们点击 epoch 将其标记为“坏”并从分析中剔除(在本文档网站上不是交互式的,但在 Python 控制台中运行 epochs.plot() 时会是交互式的)。
epochs = mne.Epochs(raw, events, event_id=event_dict, tmin=-0.3, tmax=0.7, preload=True)
fig = epochs.plot(events=events)
Not setting metadata
132 matching events found
Setting baseline interval to [-0.2996928197375818, 0.0] s
Applying baseline correction (mode: mean)
Created an SSP operator (subspace dimension = 1)
1 projection items activated
Using data from preloaded Raw for 132 events and 151 original time points ...
1 bad epochs dropped
You seem to have overlapping epochs. Some event lines may be duplicated in the plot.
也可以通过提供峰峰值信号最大阈值来自动剔除 epoch(无论是首次创建时还是之后;该阈值作为 reject 参数传给 Epochs,详见 Rejecting Epochs based on peak-to-peak channel amplitude)。也可以在 epoch 创建后使用 drop_bad() 完成:
reject_criteria = dict(eeg=100e-6, eog=200e-6)  # 100 µV, 200 µV
epochs.drop_bad(reject=reject_criteria)
    Rejecting  epoch based on EEG : ['eeg03']
    Rejecting  epoch based on EEG : ['eeg01', 'eeg02', 'eeg03', 'eeg04', 'eeg06', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg01', 'eeg02', 'eeg03', 'eeg04', 'eeg06', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg01', 'eeg02', 'eeg03', 'eeg04', 'eeg06', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg01', 'eeg02', 'eeg03', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg01', 'eeg02', 'eeg03', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg01']
    Rejecting  epoch based on EEG : ['eeg03', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg03', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg07']
    Rejecting  epoch based on EEG : ['eeg03', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg03', 'eeg07']
    Rejecting  epoch based on EEG : ['eeg07']
    Rejecting  epoch based on EEG : ['eeg07']
    Rejecting  epoch based on EEG : ['eeg03']
    Rejecting  epoch based on EEG : ['eeg25']
    Rejecting  epoch based on EEG : ['eeg25']
17 bad epochs dropped
接下来,我们生成一个条形图,显示哪些通道对 epoch 被剔除的贡献最大。如果某个通道导致大量 epoch 被剔除,可能值得在 Raw 对象中把该通道标记为“坏”,然后重新分段(保留较少通道但获得更多有效 epoch,可能比保留所有通道却丢失大量 epoch 更可取)。更多信息请参阅 处理坏导联。
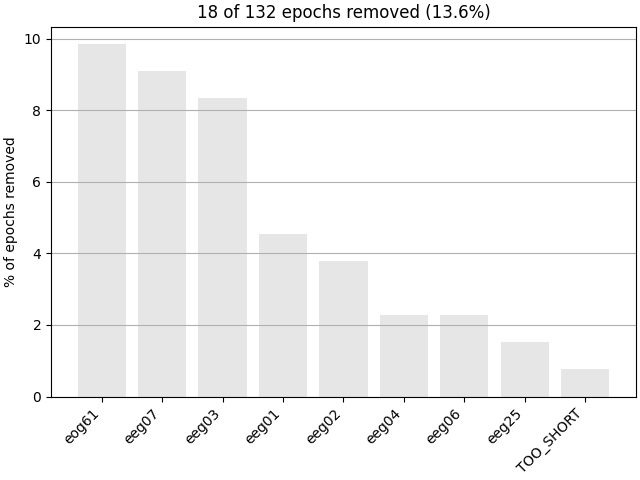
如果创建 epoch 所围绕的事件距离 Raw 对象的开头或结尾太近(例如 epoch 会超出记录末尾),epoch 也会被自动剔除(这就是 plot_drop_log() 图中出现“TOO_SHORT”条目的原因)。
如果 Raw 对象包含以 bad 或 edge 开头的标注,epoch 也可能被自动剔除(拼接两个或多个 Raw 对象时会自动插入“edge”标注)。有关基于标注的 epoch 剔除的更多信息,请参阅 剔除坏数据段与中断。
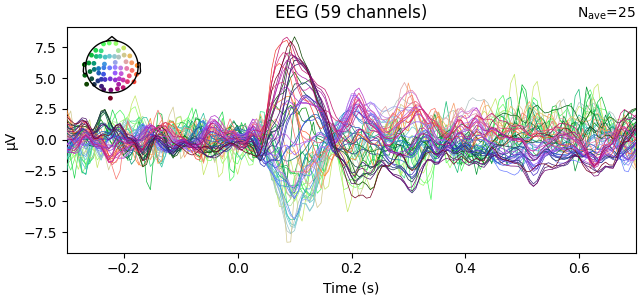
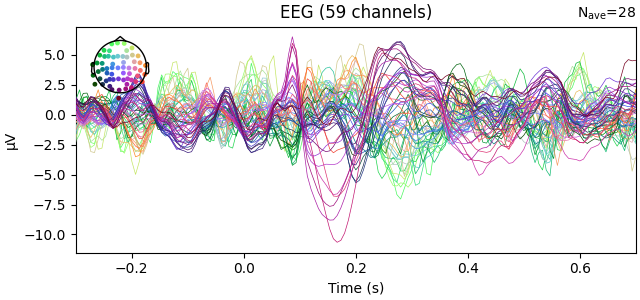
现在我们已经剔除了所有坏 epoch,来看看我们关心的若干条件的诱发响应。这里,average() 方法会创建一个 Evoked 对象,随后我们可以绘制它。注意,我们使用方括号索引(类似于字典)选择要平均的条件。这会返回只包含所需 epoch 的子集,然后我们对其进行平均:
这些 Evoked 对象有自己的交互式绘图方法(同样,在文档网站上不会是交互式的)。点击并拖动一段时间范围,会生成所选时间段头皮电位的拓扑图。这里我们还演示了按位置为通道曲线内置着色:
fig1 = l_aud.plot()
fig2 = l_vis.plot(spatial_colors=True)
头皮拓扑图也可以通过 plot_topomap() 方法以非交互方式获得。这里,我们展示以 -200 ms、100 ms 和 400 ms 为中心的 50 ms 时间窗内平均诱发电位的拓扑图。
l_aud.plot_topomap(times=[-0.2, 0.1, 0.4], average=0.05)
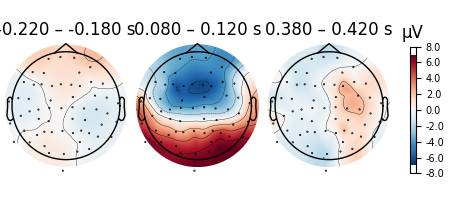
这些图可以进行大量定制,详情请参阅 plot_topomap() 的文档字符串。
还有一个内置方法 plot_joint(),可将信号的蝴蝶图与头皮拓扑图组合起来。与 plot_topomap() 一样,你可以指定头皮拓扑图的时间,也可以像这里所示那样让方法自动选择时间:
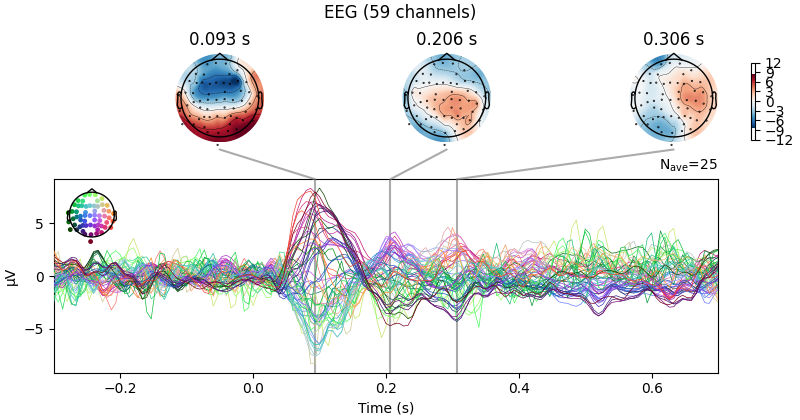
Projections have already been applied. Setting proj attribute to True.
全局场强(GFP)#
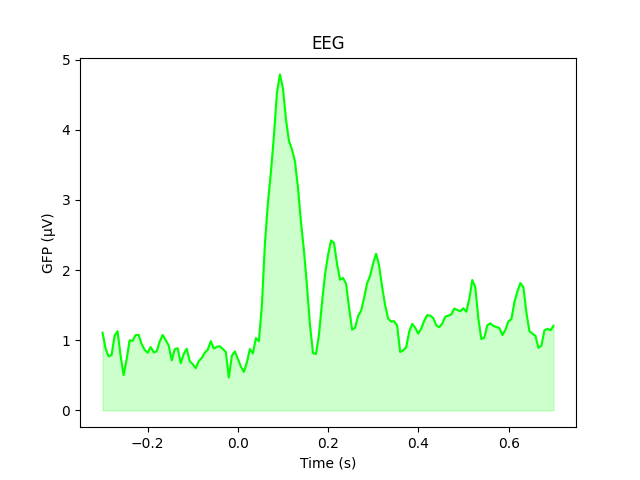
全局场强(Global field power,GFP)[1] [2] [3] 一般用于衡量整个头皮上所有传感器所拾取信号的一致程度:如果所有传感器在某一时间点的值相同,则该时间点的 GFP 为零;如果信号不同,则该时间点的 GFP 非零。GFP 峰值可能反映“有趣”的脑活动,值得进一步研究。从数学上讲,GFP 是所有传感器的总体标准差,并对每个时间点分别计算。
你可以使用 evoked.plot(gfp=True) 绘制 GFP。若 spatial_colors=True,GFP 曲线为黑色,否则为绿色。EEG 参考不影响 GFP:
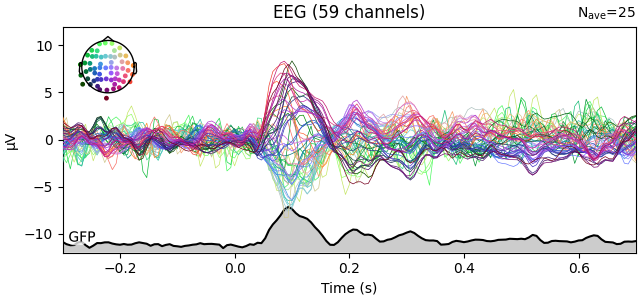
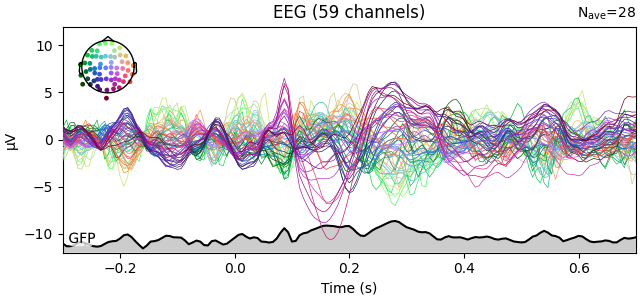
若要单独绘制 GFP,可以传入 gfp='only'(这样更容易读取 GFP 数值,因为坐标尺度已对齐):
l_aud.plot(gfp="only")
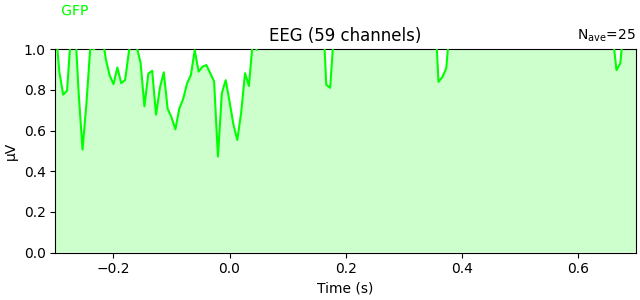
GFP 是跨通道信号的总体标准差。为了手动计算它,我们可以利用 evoked.data 是 NumPy 数组这一点,并用纯 Matplotlib 命令绘图来验证:
gfp = l_aud.data.std(axis=0, ddof=0)

# Reproducing the MNE-Python plot style seen above
fig, ax = plt.subplots()
ax.plot(l_aud.times, gfp * 1e6, color="lime")
ax.fill_between(l_aud.times, gfp * 1e6, color="lime", alpha=0.2)
ax.set(xlabel="Time (s)", ylabel="GFP (µV)", title="EEG")
按感兴趣区跨通道平均#
由于我们的示例数据包含对左侧和右侧听觉与视觉刺激的响应,我们可能想比较左侧与右侧感兴趣区(ROI)。要对给定 ROI 内的通道进行平均,首先需要找到相关的通道索引。回顾上面的二维传感器图,我们可能分别为左、右 ROI 选择以下通道:
left = ["eeg17", "eeg18", "eeg25", "eeg26"]
right = ["eeg23", "eeg24", "eeg34", "eeg35"]

left_ix = mne.pick_channels(l_aud.info["ch_names"], include=left)
right_ix = mne.pick_channels(l_aud.info["ch_names"], include=right)
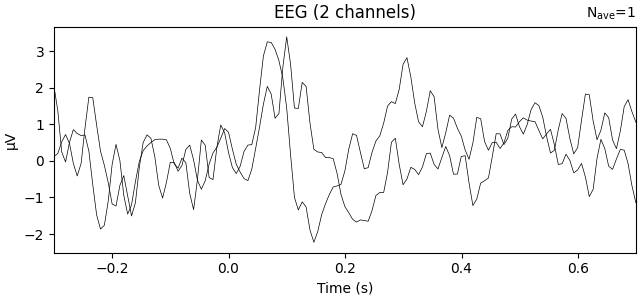
现在可以创建一个包含两个虚拟通道(每个 ROI 一个)的新 Evoked 对象:
roi_dict = dict(left_ROI=left_ix, right_ROI=right_ix)
roi_evoked = mne.channels.combine_channels(l_aud, roi_dict, method="mean")
print(roi_evoked.info["ch_names"])
roi_evoked.plot()
Applying baseline correction (mode: mean)
['left_ROI', 'right_ROI']
比较条件#
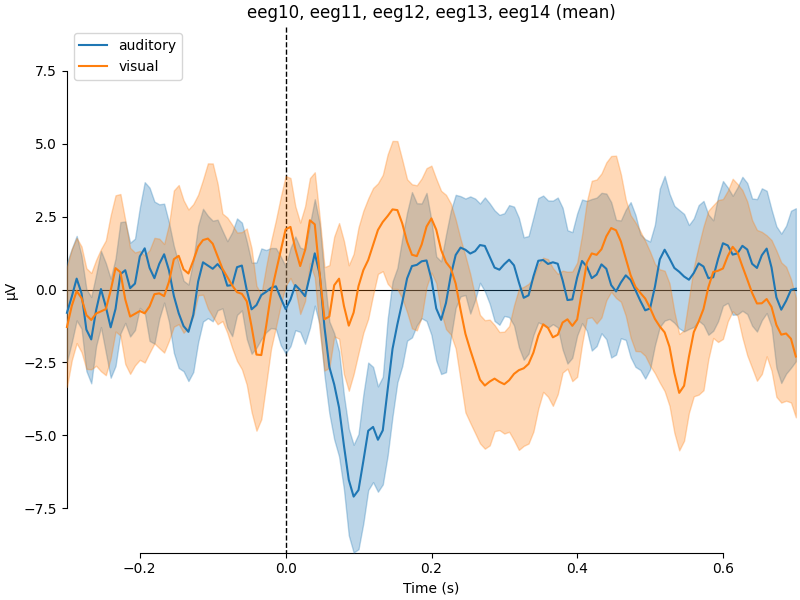
如果我们想对比听觉与视觉刺激,一个有用的函数是 mne.viz.plot_compare_evokeds()。默认情况下,该函数会使用 GFP(对于 MEG 通道则使用 RMS)合并每个诱发对象中的所有通道;这里我们改为指定按平均合并,并通过 picks 将其限制为一部分通道:
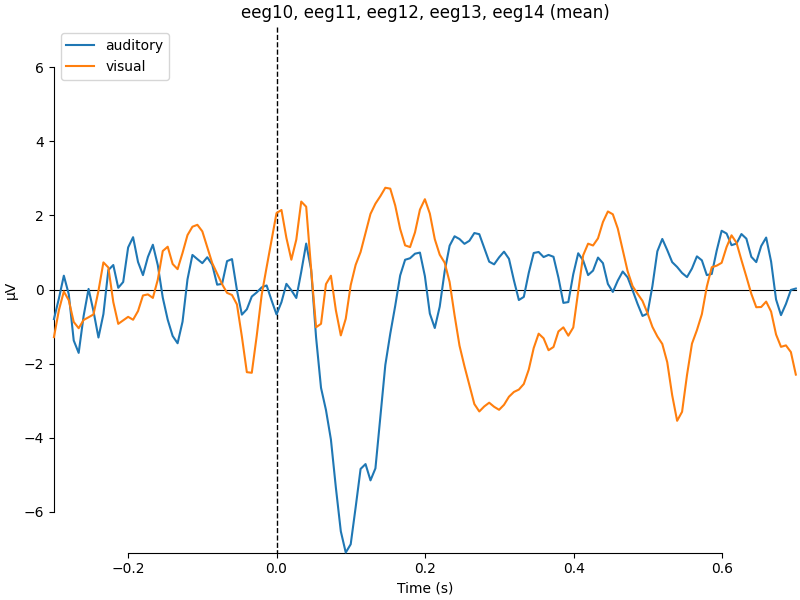
combining channels using "mean"
combining channels using "mean"
我们还可以通过 iter_evoked() 将每个 epoch 视为独立观测来生成置信区间。也可以通过向 plot_compare_evokeds() 函数传入 Evoked 对象列表(每个受试者一个)来获得跨受试者的置信区间。
combining channels using "mean"
combining channels using "mean"
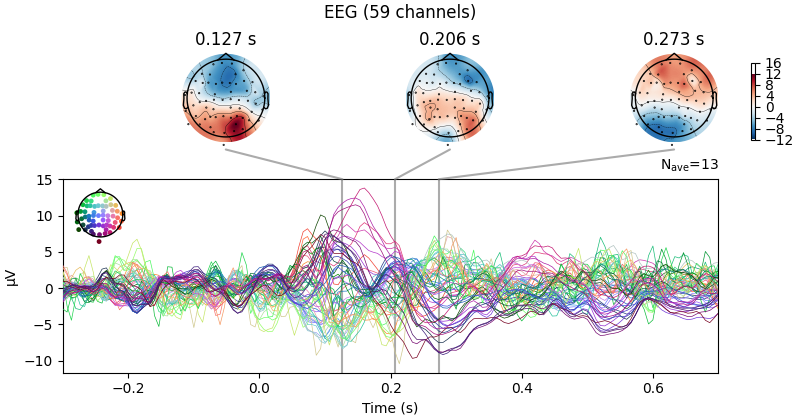
我们还可以使用 mne.combine_evoked() 函数将一个 Evoked 对象从另一个中减去,从而比较条件(该函数也支持不做减法而直接合并 epoch)。
aud_minus_vis = mne.combine_evoked([l_aud, l_vis], weights=[1, -1])
aud_minus_vis.plot_joint()
Projections have already been applied. Setting proj attribute to True.
警告
上面的代码产生的是等权差值。如果各条件的 epoch 数量不同,你可能希望先使用 epochs.equalize_event_counts() 均衡每个条件的事件数量,再进行平均。
总平均#
要计算跨条件(或跨受试者)的总平均,可以向 mne.grand_average() 传入 Evoked 对象列表。结果是另一个 Evoked 对象。
grand_average = mne.grand_average([l_aud, l_vis])
print(grand_average)
Setting channel interpolation method to {'eeg': 'spline'}.
Interpolating bad channels.
    Automatic origin fit: head of radius 91.2 mm
Computing interpolation matrix from 59 sensor positions
Interpolating 1 sensors
Setting channel interpolation method to {'eeg': 'spline'}.
Interpolating bad channels.
    Automatic origin fit: head of radius 91.2 mm
Computing interpolation matrix from 59 sensor positions
Interpolating 1 sensors
Identifying common channels ...
<Evoked | 'Grand average (n = 2)' (average, N=2), -0.29969 – 0.69928 s, baseline -0.299693 – 0 s, 60 ch, ~3.0 MiB>
对于条件组合,还可以在选择要平均的 epoch 时利用条件名称中的 HED 标签。例如,我们有如下条件名称:
list(event_dict)
我们可以通过传入以下内容来选择听觉条件(左右合并):
epochs["auditory"].average()
教程 Epochs 数据结构:不连续数据 和 Evoked 数据结构:诱发/平均数据 提供了关于使用 Epochs 和 Evoked 类的更多细节。
幅度与潜伏期测量#
在 ERP 研究中,提取幅度或潜伏期指标以比较不同条件很常见。可以从 ERP 中提取的指标很多,其中许多在 Luck [4] 的第 9 章中有详细介绍(包括各自的优缺点)(另见 ERPLAB Toolbox [5] 中的 Measurement Tool)。
本教程的这一部分将演示如何提取三种常用指标:
峰值潜伏期
峰值幅度
平均幅度
峰值潜伏期与幅度#
最常用的幅度和潜伏期指标是峰值指标。峰值指标基本上是指定时间窗内信号的最大幅度,以及出现峰值幅度的时间点(或潜伏期)。
峰值指标可以使用 get_peak() 方法获得。关于 get_peak() 有两点需要强调。第一,它会在 Evoked 对象中所有可用的所选类型通道中寻找最强峰值。因此,如果你想把搜索限制在一组通道或单个通道,应首先使用 pick() 或 pick_channels() 方法。第二,get_peak() 方法可以通过 mode 参数查找不同类型的峰值。共有三个选项:
mode='pos':查找电压为正的峰值(忽略负电压)mode='neg':查找电压为负的峰值(忽略正电压)mode='abs':查找绝对电压最大的峰值,无论正负
下面的示例演示如何为左侧视觉条件(即 l_vis 这个 Evoked 对象)找到 ERP 中的第一个正峰(即 P100)。用于搜索峰值的时间窗为 0.08 至 0.12 s。选择该时间窗是因为 P100 通常出现在此时段。注意,所有 'eeg' 通道都会提交给 get_peak() 方法。
# Define a function to print out the channel (ch) containing the
# peak latency (lat; in msec) and amplitude (amp, in µV), with the
# time range (tmin and tmax) that was searched.
# This function will be used throughout the remainder of the tutorial.
def print_peak_measures(ch, tmin, tmax, lat, amp):
    print(f"Channel: {ch}")
    print(f"Time Window: {tmin * 1e3:.3f} - {tmax * 1e3:.3f} ms")
    print(f"Peak Latency: {lat * 1e3:.3f} ms")
    print(f"Peak Amplitude: {amp * 1e6:.3f} µV")


# Get peak amplitude and latency from a good time window that contains the peak
good_tmin, good_tmax = 0.08, 0.12
ch, lat, amp = l_vis.get_peak(
    ch_type="eeg", tmin=good_tmin, tmax=good_tmax, mode="pos", return_amplitude=True
)

# Print output from the good time window that contains the peak
print("** PEAK MEASURES FROM A GOOD TIME WINDOW **")
print_peak_measures(ch, good_tmin, good_tmax, lat, amp)
** PEAK MEASURES FROM A GOOD TIME WINDOW **
Channel: eeg55
Time Window: 80.000 - 120.000 ms
Peak Latency: 86.578 ms
Peak Amplitude: 6.508 µV
输出显示,在搜索的所有 'eeg' 通道中,通道 eeg55 在所选时间窗内具有最大正峰。在实践中,根据研究需要,可能希望提取先验感兴趣区或单个通道的峰值。这可以通过将 pick() 或 pick_channels() 方法与 get_peak() 方法结合来实现。
这里,我们假设我们认为感兴趣效应会出现在 eeg59 上。
# Fist, return a copy of l_vis to select the channel from
l_vis_roi = l_vis.copy().pick("eeg59")

# Get the peak and latency measure from the selected channel
ch_roi, lat_roi, amp_roi = l_vis_roi.get_peak(
    tmin=good_tmin, tmax=good_tmax, mode="pos", return_amplitude=True
)

# Print output
print("** PEAK MEASURES FOR ONE CHANNEL FROM A GOOD TIME WINDOW **")
print_peak_measures(ch_roi, good_tmin, good_tmax, lat_roi, amp_roi)
** PEAK MEASURES FOR ONE CHANNEL FROM A GOOD TIME WINDOW **
Channel: eeg59
Time Window: 80.000 - 120.000 ms
Peak Latency: 86.578 ms
Peak Amplitude: 5.713 µV
虽然通道 eeg55 和 eeg59 的峰值潜伏期相同,但峰值幅度不同。该方法也可用于通过 combine_channels() 函数创建的虚拟通道,以及通过 mne.combine_evoked() 函数创建的差异波(参见上文“比较条件”一节中的 aud_minus_vis)。
峰值指标非常容易受信号中的高频噪声影响(讨论见 [4])。具体而言,高频噪声会正向偏倚峰值幅度指标。当不同条件的 ERP 在高频噪声水平上存在差异时(例如各条件对 ERP 有贡献的试次数不同),这种偏倚会混淆条件间的比较。避免此问题的一种方法是对 ERP 应用非因果低通滤波器。低通滤波器通过平滑信号中的快速(即高频)波动来降低高频噪声的贡献(参见 滤波背景知识)。虽然这可以减少高频噪声引起的峰值幅度正偏倚,但对 ERP 进行低通滤波可能会给解释感兴趣效应的峰值潜伏期指标带来困难 [6] [7]。
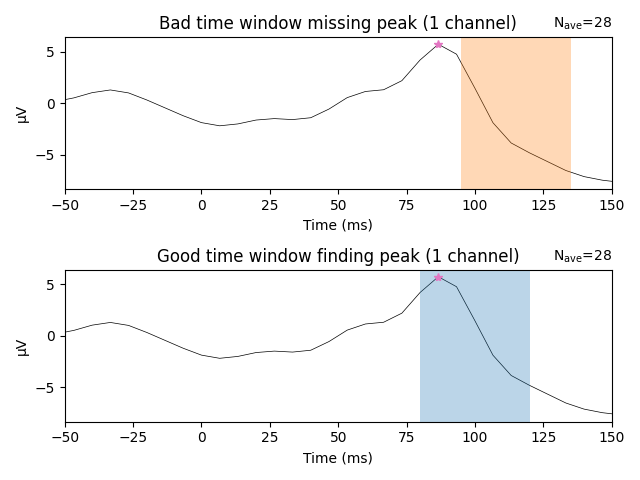
如果使用峰值指标,务必通过目视检查数据,确保所选时间窗确实包含一个峰值。get_peak() 方法检测指定时间范围内的最大或最小电压,并返回该峰的潜伏期和幅度。不能保证该方法返回的是真正的峰;相反,它可能返回我们试图寻找的峰值上升沿或下降沿上的某个值。
下面的示例说明为何目视检查至关重要。在下面,我们使用一个已知的不良时间窗(0.095 至 0.135 s)在通道 eeg59 中搜索峰值。
# Get BAD peak measures
bad_tmin, bad_tmax = 0.095, 0.135
ch_roi, bad_lat_roi, bad_amp_roi = l_vis_roi.get_peak(
    mode="pos", tmin=bad_tmin, tmax=bad_tmax, return_amplitude=True
)

# Print output
print("** PEAK MEASURES FOR ONE CHANNEL FROM A BAD TIME WINDOW **")
print_peak_measures(ch_roi, bad_tmin, bad_tmax, bad_lat_roi, bad_amp_roi)
** PEAK MEASURES FOR ONE CHANNEL FROM A BAD TIME WINDOW **
Channel: eeg59
Time Window: 95.000 - 135.000 ms
Peak Latency: 99.898 ms
Peak Amplitude: 1.487 µV
如果我们只有上述数值,就无法确定它们是否真的识别出了 ERP 中的峰值。事实上,0.095 至 0.135 s 的时间窗并不包含真正的峰,如下面顶部面板所示。不良时间窗(橙色高亮)不包含真正的峰(粉色星号)。相比之下,最初定义的时间窗(0.08 至 0.12 s;蓝色高亮)返回的是真正的峰,而不仅仅是搜索时间窗内的最大值或最小值。目视检查总能帮助你确认返回的数值是真正的峰值。
fig, axs = plt.subplots(nrows=2, ncols=1, layout="tight")
words = (("Bad", "missing"), ("Good", "finding"))
times = (np.array([bad_tmin, bad_tmax]), np.array([good_tmin, good_tmax]))
colors = ("C1", "C0")

for ix, ax in enumerate(axs):
    title = "{} time window {} peak".format(*words[ix])
    l_vis_roi.plot(axes=ax, time_unit="ms", show=False, titles=title)
    ax.plot(lat_roi * 1e3, amp_roi * 1e6, marker="*", color="C6")
    ax.axvspan(*(times[ix] * 1e3), facecolor=colors[ix], alpha=0.3)
    ax.set_xlim(-50, 150)  # Show zoomed in around peak
Need more than one channel to make topography for eeg. Disabling interactivity.
Need more than one channel to make topography for eeg. Disabling interactivity.
平均幅度#
ERP 研究中的另一种常见做法是将某个成分(或效应)定义为指定时间窗内的平均幅度。这种方法的一个优点是(与峰值幅度指标相比)它对高频噪声不太敏感,因为在时间窗上平均相当于一个低通滤波器(讨论见上一节“峰值潜伏期与幅度”)。
使用平均幅度指标时,根据感兴趣效应(例如两个条件之间的差异)选择时间窗,可能会增加结果中出现假阳性的可能性 [8]。还有其他更好的方法来确定用于提取平均幅度指标的时间窗。首先,可以根据先前研究使用先验时间窗。第二种选择是根据独立条件或未用于分析的试次集合(例如“定位器”条件)定义时间窗。第三种方法是使用跨条件总平均来定义时间窗。后一种方法并不循环,因为跨条件均值与条件差异彼此独立。上述问题同样适用于选择用于分析的通道。
下面的示例演示如何从左侧视觉条件(即 l_vis 这个 Evoked 对象)中,针对选定通道和时间窗提取平均幅度。刺激左侧视野会增加对侧(即右侧)半球视觉皮层的神经活动。我们可以通过检查左侧视野刺激时右侧(对侧)和左侧(同侧)通道的 ERP 幅度来验证这一点。用于该分析的通道是 eeg54 和 eeg57(左半球),以及 eeg59 和 eeg55(右半球)。所用时间窗为 0.08(good_tmin)至 0.12 s(good_tmax),因为它对应 P100 通常出现的时间。P100 对左侧和右侧视野刺激敏感。平均幅度从上述四个通道中提取,并存储在 pandas.DataFrame 中。
# Select all of the channels and crop to the time window
channels = ["eeg54", "eeg57", "eeg55", "eeg59"]
hemisphere = ["left", "left", "right", "right"]
l_vis_mean_roi = l_vis.copy().pick(channels).crop(tmin=good_tmin, tmax=good_tmax)

# Extract mean amplitude in µV over time
mean_amp_roi = l_vis_mean_roi.data.mean(axis=1) * 1e6

# Store the data in a data frame
mean_amp_roi_df = pd.DataFrame(
    {
        "ch_name": l_vis_mean_roi.ch_names,
        "hemisphere": ["left", "left", "right", "right"],
        "mean_amp": mean_amp_roi,
    }
)

# Print the data frame
print(mean_amp_roi_df.groupby("hemisphere").mean(numeric_only=True))
            mean_amp
hemisphere
left       -0.279764
right       0.685840
如本例所示,右半球通道的平均幅度高于左半球通道且为正值。需要再次强调,分析中使用的空间和时间窗都应以独立方式确定(例如根据先前研究先验定义、使用“定位器”或另一个独立条件),而不是基于你将用于检验假设的数据。
可以修改该示例,从所有通道提取平均幅度,并将结果输出存储在 pandas.DataFrame 中。这对于用其他编程语言进行统计分析可能很有用。
# Extract mean amplitude for all channels in l_vis (including `eog`)
l_vis_cropped = l_vis.copy().crop(tmin=good_tmin, tmax=good_tmax)
mean_amp_all = l_vis_cropped.data.mean(axis=1) * 1e6
mean_amp_all_df = pd.DataFrame(
    {"ch_name": l_vis_cropped.info["ch_names"], "mean_amp": mean_amp_all}
)
mean_amp_all_df["tmin"] = good_tmin
mean_amp_all_df["tmax"] = good_tmax
mean_amp_all_df["condition"] = "Left/Visual"
with pd.option_context("display.max_columns", None):
    print(mean_amp_all_df.head())
    print(mean_amp_all_df.tail())
  ch_name  mean_amp  tmin  tmax    condition
0   eeg01 -1.689513  0.08  0.12  Left/Visual
1   eeg02 -0.078492  0.08  0.12  Left/Visual
2   eeg03 -0.381191  0.08  0.12  Left/Visual
3   eeg04 -1.609264  0.08  0.12  Left/Visual
4   eeg05 -1.113717  0.08  0.12  Left/Visual
   ch_name  mean_amp  tmin  tmax    condition
55   eeg56  2.064174  0.08  0.12  Left/Visual
56   eeg57 -0.259681  0.08  0.12  Left/Visual
57   eeg58  0.156472  0.08  0.12  Left/Visual
58   eeg59  0.802306  0.08  0.12  Left/Visual
59   eeg60  0.878811  0.08  0.12  Left/Visual
参考文献#
脚本总运行时间:(0 分钟 6.803 秒)