
注意
转到末尾下载完整示例代码。
传感器层面的频率与时频分析#
本教程的目标是向你展示如何探索数据的频谱内容(频率分析与时频分析)。这里我们将基于 Epochs 进行操作。
我们将使用这个数据集:Somatosensory。它包含所谓的 beta 频段事件相关同步(ERS)/ 去同步(ERD)。
# Authors: Alexandre Gramfort <alexandre.gramfort@inria.fr>
#          Stefan Appelhoff <stefan.appelhoff@mailbox.org>
#          Richard Höchenberger <richard.hoechenberger@gmail.com>
#
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import matplotlib.pyplot as plt
import numpy as np

import mne
from mne.datasets import somato
设置参数
data_path = somato.data_path()
subject = "01"
task = "somato"
raw_fname = data_path / f"sub-{subject}" / "meg" / f"sub-{subject}_task-{task}_meg.fif"

# Setup for reading the raw data
raw = mne.io.read_raw_fif(raw_fname)
# crop and resample just to reduce computation time
raw.crop(120, 360).load_data().resample(200)
events = mne.find_events(raw, stim_channel="STI 014")

# picks MEG gradiometers
picks = mne.pick_types(raw.info, meg="grad", eeg=False, eog=True, stim=False)

# Construct Epochs
event_id, tmin, tmax = 1, -1.0, 3.0
baseline = (None, 0)
epochs = mne.Epochs(
    raw,
    events,
    event_id,
    tmin,
    tmax,
    picks=picks,
    baseline=baseline,
    reject=dict(grad=4000e-13, eog=350e-6),
    preload=True,
)
Opening raw data file /home/circleci/mne_data/MNE-somato-data/sub-01/meg/sub-01_task-somato_meg.fif...
    Range : 237600 ... 506999 =    791.189 ...  1688.266 secs
Ready.
Reading 0 ... 72074  =      0.000 ...   240.001 secs...
Finding events on: STI 014
29 events found on stim channel STI 014
Event IDs: [1]
Finding events on: STI 014
29 events found on stim channel STI 014
Event IDs: [1]
Finding events on: STI 014
29 events found on stim channel STI 014
Event IDs: [1]
Not setting metadata
29 matching events found
Setting baseline interval to [-1.0, 0.0] s
Applying baseline correction (mode: mean)
0 projection items activated
Using data from preloaded Raw for 29 events and 801 original time points ...
    Rejecting  epoch based on EOG : ['EOG 061']
1 bad epochs dropped
频率分析#
我们首先探索 epochs 的频率内容。
我们先对所有 epoch 取平均,以便查看所有通道类型。
epochs.compute_psd(fmin=2.0, fmax=40.0).plot(
    average=True, amplitude=False, picks="data", exclude="bads"
)
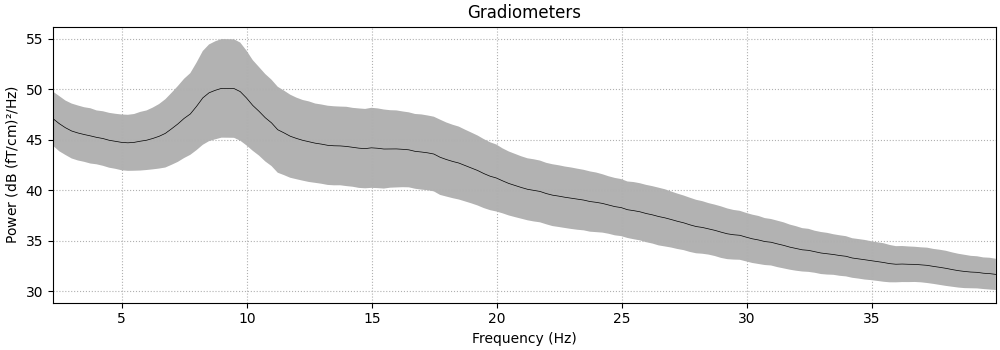
    Using multitaper spectrum estimation with 7 DPSS windows
Plotting power spectral density (dB=True).
Averaging across epochs before plotting...
现在,我们来看 PSD 的空间分布,该分布是对 epochs 和频段取平均后得到的。
epochs.compute_psd().plot_topomap(ch_type="grad", normalize=False, contours=0)
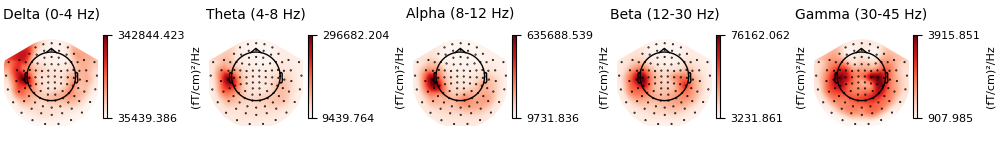
    Using multitaper spectrum estimation with 7 DPSS windows
Averaging across epochs before plotting...
或者,你也可以直接通过 Epochs 的方法创建 PSD。
注意
与可视化方法不同,compute_psd 系列方法不会把数据从 SI 单位缩放到更“方便”的数值。因此,例如通过 compute_psd() 计算梯度计的 PSD 时,得到的功率单位是 (T/m)²/Hz(而不是 plot_psd() 给出的 (fT/cm)²/Hz)。
_, ax = plt.subplots()
spectrum = epochs.compute_psd(fmin=2.0, fmax=40.0, tmax=3.0, n_jobs=None)
# average across epochs first
mean_spectrum = spectrum.average()
psds, freqs = mean_spectrum.get_data(return_freqs=True)
# then convert to dB and take mean & standard deviation across channels
psds = 10 * np.log10(psds)
psds_mean = psds.mean(axis=0)
psds_std = psds.std(axis=0)

ax.plot(freqs, psds_mean, color="k")
ax.fill_between(
    freqs,
    psds_mean - psds_std,
    psds_mean + psds_std,
    color="k",
    alpha=0.5,
    edgecolor="none",
)
ax.set(
    title="Multitaper PSD (gradiometers)",
    xlabel="Frequency (Hz)",
    ylabel="Power Spectral Density (dB)",
)
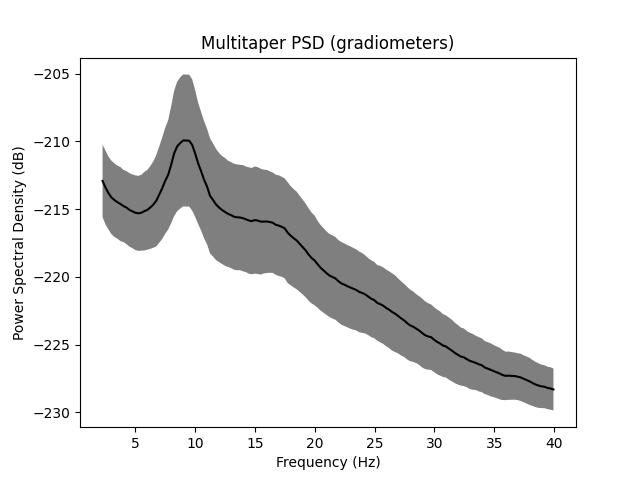
Using multitaper spectrum estimation with 7 DPSS windows
值得注意的是,mne.Epochs.compute_psd() 支持关键字参数 average,用于指定如何基于各个加窗分段估计 PSD。默认值为 average='mean',即简单地对各分段计算算术平均。相反,指定 average='median' 会返回基于各分段中位数的 PSD(已针对相对于均值的偏差进行校正),这是一种更稳健的度量。
# Estimate PSDs based on "mean" and "median" averaging for comparison.
kwargs = dict(fmin=2, fmax=40, n_jobs=None)
psds_welch_mean, freqs_mean = epochs.compute_psd(
    "welch", average="mean", **kwargs
).get_data(return_freqs=True)
psds_welch_median, freqs_median = epochs.compute_psd(
    "welch", average="median", **kwargs
).get_data(return_freqs=True)

# Convert power to dB scale.
psds_welch_mean = 10 * np.log10(psds_welch_mean)
psds_welch_median = 10 * np.log10(psds_welch_median)

# We will only plot the PSD for a single sensor in the first epoch.
ch_name = "MEG 0122"
ch_idx = epochs.info["ch_names"].index(ch_name)
epo_idx = 0

_, ax = plt.subplots()
ax.plot(
    freqs_mean,
    psds_welch_mean[epo_idx, ch_idx, :],
    color="k",
    ls="-",
    label="mean of segments",
)
ax.plot(
    freqs_median,
    psds_welch_median[epo_idx, ch_idx, :],
    color="k",
    ls="--",
    label="median of segments",
)

ax.set(
    title=f"Welch PSD ({ch_name}, Epoch {epo_idx})",
    xlabel="Frequency (Hz)",
    ylabel="Power Spectral Density (dB)",
)
ax.legend(loc="upper right")
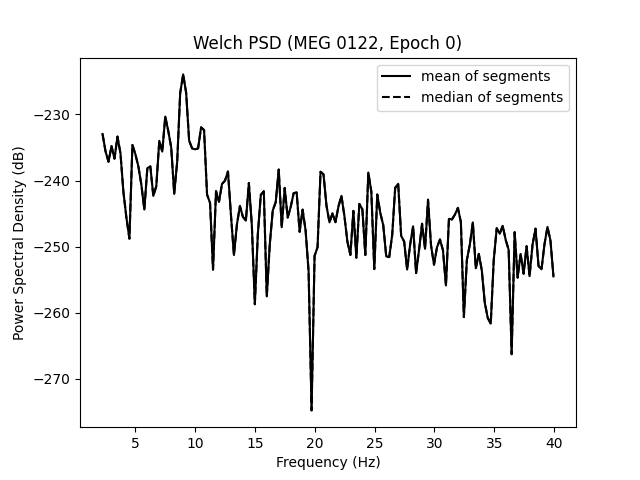
Effective window size : 4.005 (s)
Effective window size : 4.005 (s)
最后,通过向 mne.Epochs.compute_psd() 传入 average=None,我们还可以获取未聚合的分段。返回数组的维度为 (n_epochs, n_sensors, n_freqs, n_segments)。
welch_unagg = epochs.compute_psd("welch", average=None, **kwargs)
print(welch_unagg.shape)
Effective window size : 4.005 (s)
(28, 204, 152, 1)
时频分析:功率与试次间一致性#
现在我们基于 Epochs 计算时频表示(TFR)。我们将关注功率和试次间一致性(ITC)。
为此我们将使用 mne.time_frequency.tfr_morlet() 函数,但你也可以使用 mne.time_frequency.tfr_multitaper() 或 mne.time_frequency.tfr_stockwell()。
注意
decim 参数会按指定的倍数降低时频分解的采样率。这样做通常是为了减少内存占用。更多信息请参阅 mne.time_frequency.tfr_morlet() 的文档。
定义感兴趣的频率(对数间隔)
查看功率#
注意
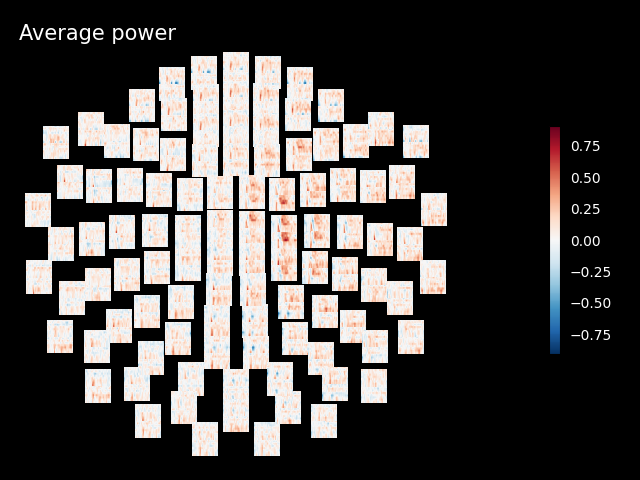
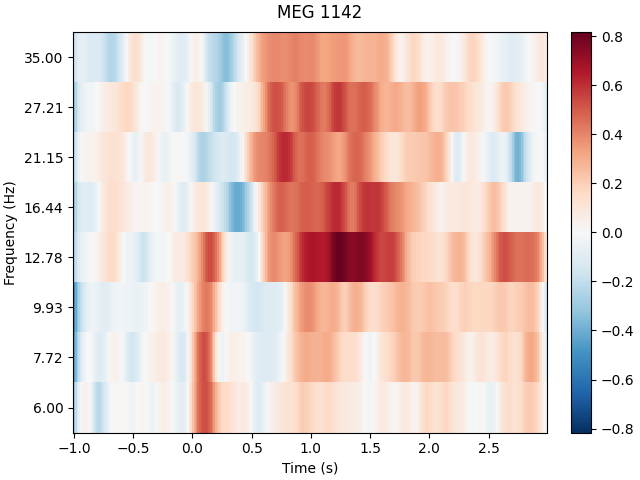
生成的图是交互式的。在地形图中,你可以点击某个图像来可视化单个传感器的数据。你也可以在时频平面上选取一个区域,以获得特定时频区域的地形图。
power.plot_topo(baseline=(-0.5, 0), mode="logratio", title="Average power")
power.plot(picks=[82], baseline=(-0.5, 0), mode="logratio", title=power.ch_names[82])

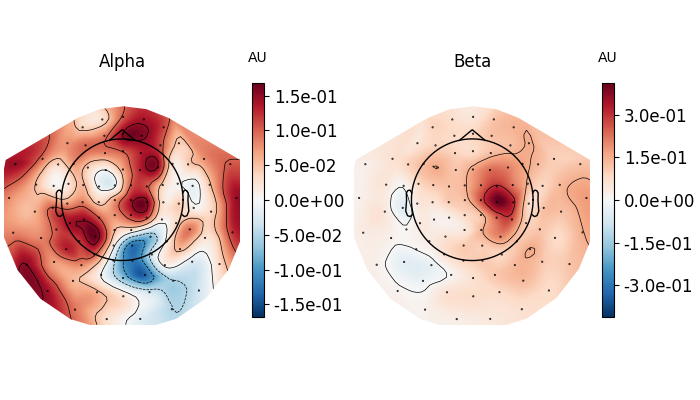
fig, axes = plt.subplots(1, 2, figsize=(7, 4), layout="constrained")
topomap_kw = dict(
    ch_type="grad", tmin=0.5, tmax=1.5, baseline=(-0.5, 0), mode="logratio", show=False
)
plot_dict = dict(Alpha=dict(fmin=8, fmax=12), Beta=dict(fmin=13, fmax=25))
for ax, (title, fmin_fmax) in zip(axes, plot_dict.items()):
    power.plot_topomap(**fmin_fmax, axes=ax, **topomap_kw)
    ax.set_title(title)
Applying baseline correction (mode: logratio)
Applying baseline correction (mode: logratio)
Applying baseline correction (mode: logratio)
Applying baseline correction (mode: logratio)
联合图#
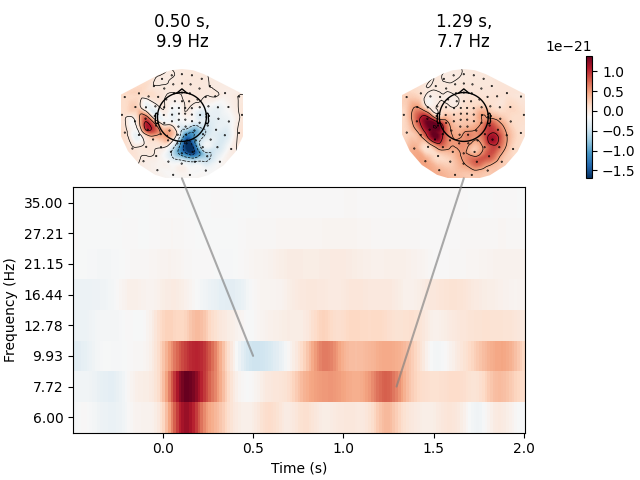
你还可以创建联合图,同时显示跨通道聚合的 TFR 以及特定时间和频率处的地形图,从而快速概览振荡效应在时间和空间上的分布。
power.plot_joint(
    baseline=(-0.5, 0), mode="mean", tmin=-0.5, tmax=2, timefreqs=[(0.5, 10), (1.3, 8)]
)
Applying baseline correction (mode: mean)
Applying baseline correction (mode: mean)
Applying baseline correction (mode: mean)
查看 ITC#
itc.plot_topo(title="Inter-Trial coherence", vmin=0.0, vmax=1.0, cmap="Reds")
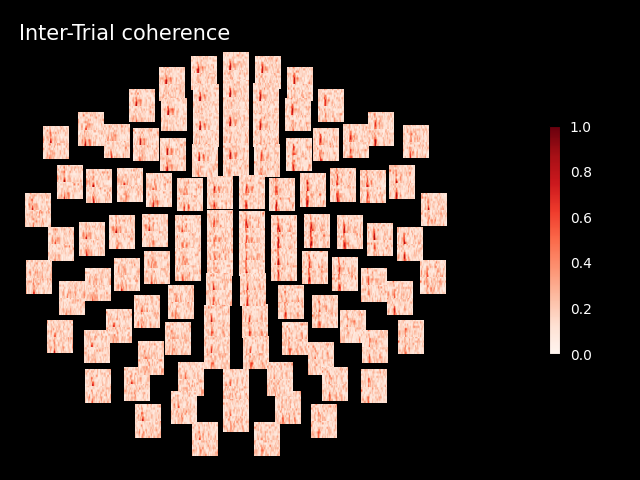
No baseline correction applied
注意
基线校正既可以应用于功率,也可以在绘图时进行。为了演示绘图中的基线校正,下一行代码被注释掉了:
# power.apply_baseline(baseline=(-0.5, 0), mode='logratio')
基线校正的注意事项#
对时频结果进行基线校正,有助于相对于参考时段来表达刺激后的振荡活动。它便于解释由刺激诱发(evoked)或引发(induced)的脑活动,并减小基线功率(例如 1/f 时间结构)的影响。然而,基线校正并不是一种去噪过程,其解释依赖于关于基线(约等于静息态)活动如何与刺激后活动相结合的假设(例如是相加还是相乘)。因此,基线选择应由理论和实验设计驱动。如果基线旨在代表中性参考,它应当不含系统性的预期、准备或顺序效应。还必须考虑时频变换造成的时间泄漏:刺激起始之后的活动可能污染紧邻刺激之前的估计值,因此基线应当足够早地结束。
MNE-Python 提供多种基线模式
"mean"- 减去基线功率的均值。该方法简单,且保持原有的功率单位,因此适合关注相对于基线的加性变化的情形。不过,数值仍依赖于频率和传感器,所以其大小不能在不同频率或不同传感器类型之间直接比较。
"ratio"- 以相对于基线的形式表示功率。它很直观,因为数值表示相对功率(例如 1.2 表示比基线高 20%),但所得分布通常呈正偏态,这会给参数统计检验带来问题(Grandchamp & Delorme 2011)。
"logratio"- 在对数尺度(dB)上表示相对功率。对数变换可减轻偏态,使增加或减少更加对称,同时为比较相对变化提供了方便的尺度。然而,Kinley 等(2006;[ 1 ])指出这种常规方法会引入负偏倚,可能使未发生变化的功率看起来下降,并低估真实的增加。请注意,单试次校正(作用于
EpochsTFR)比试次平均数据的校正(AverageTFR)更容易受到 logratio 偏倚的影响,因为该偏倚会随被校正量的方差而增大。 "meanlogratio"- 提供对数(dB)解释,但通过先对基线取对数再平均(而不是先对基线功率求平均再取对数)来避免其负偏倚。它保留了对数变换降低偏态的优点,并确保基线均值为零。因此,当你需要乘性模型和对数表示时,它比 logratio 更可取(Kinley et al. 2026)。
"percent"- 以相对于基线的百分比变化表示,使相对变化的幅度易于解释。与 ratio 一样,它是不对称的,且通常呈正偏态;当在单试次水平进行归一化时,这可能尤其成问题。
"zscore"- 以基线标准差为单位,表示相对于基线变异性的变化。这有助于比较具有不同基线变异性的频率或传感器,但所得数值依赖于基线方差,因此并不直接代表绝对或成比例的功率变化。
"zlogratio"- 将相对功率的对数变换与按基线变异性归一化相结合。当问题关注的是相对于基线变异性而言相对功率变化有多大时,它很有用;但它与 zscore 一样,在解释上依赖于基线方差。
练习#
像功率那样,将试次间一致性值可视化为地形图。
参考文献#
脚本总运行时间:(0 分钟 8.210 秒)