
说明
转到末尾下载完整示例代码。
频率标记:SSVEP/vSSR 数据集基础分析#
本教程将计算脑电数据的频谱,并量化目标频率处的信噪比(SNR)。这些数据记录了在不同试次中以 12 Hz 和 15 Hz 进行快速周期视觉刺激(FPVS)期间的大脑活动。提取刺激频率处的 SNR 是量化 MEEG 中频率标记响应的简便方法(这类响应又称稳态视觉诱发电位 SSVEP,在视觉领域称为视觉稳态响应 vSSR,在听觉领域则称为听觉稳态响应 ASSR)。
有关该方法的总体介绍,视觉领域请参阅 Norcia et al. (2015),听觉领域请参阅 Picton et al. (2003)。
数据与分析流程:
我们使用一个频率标记视觉刺激的简单示例数据集:N=2 名被试观看以 12.0 Hz 或 15.0 Hz 恒定频率翻转的棋盘格图案,同时记录了 32 通道湿电极 EEG(更多信息参见 SSVEP)。
我们将可视化分段数据的功率谱密度(PSD)与 SNR 频谱,提取刺激频率处的 SNR,绘制响应的地形图,并统计区分不同试次中 12 Hz 与 15 Hz 的响应。由于诱发响应主要产生于大脑的早期视觉区,统计分析将在枕区 ROI 上进行。
# Authors: Dominik Welke <dominik.welke@web.de>
#          Evgenii Kalenkovich <e.kalenkovich@gmail.com>
#
# License: BSD-3-Clause
# Copyright the MNE-Python contributors.
import matplotlib.pyplot as plt
import numpy as np
from scipy.stats import ttest_rel

import mne
数据预处理#
由于 SSVEP/vSSR 的信噪比通常较高,常规预处理步骤被视为可选项。但这并不意味着恰当的清洗不会提升你的信号质量!
原始数据以 FCz 为参考,因此我们将应用共同平均参考(common-average rereferencing)。
我们将应用 0.1 Hz 的高通滤波。
最后,我们将把数据切分为与试次对应的 20 s epoch。
# Load raw data
data_path = mne.datasets.ssvep.data_path()
bids_fname = (
    data_path / "sub-02" / "ses-01" / "eeg" / "sub-02_ses-01_task-ssvep_eeg.vhdr"
)

raw = mne.io.read_raw_brainvision(bids_fname, preload=True, verbose=False)
raw.info["line_freq"] = 50.0

# Set montage
montage = mne.channels.make_standard_montage("easycap-M1")
raw.set_montage(montage, verbose=False)

# Set common average reference
raw.set_eeg_reference("average", projection=False, verbose=False)

# Apply bandpass filter
raw.filter(l_freq=0.1, h_freq=None, fir_design="firwin", verbose=False)

# Construct epochs
raw.annotations.rename({"Stimulus/S255": "12hz", "Stimulus/S155": "15hz"})
tmin, tmax = -1.0, 20.0  # in s
baseline = None
epochs = mne.Epochs(
    raw,
    event_id=["12hz", "15hz"],
    tmin=tmin,
    tmax=tmax,
    baseline=baseline,
    verbose=False,
)
频率分析#
现在我们计算 EEG 数据的频谱。无需任何进一步处理,你就能看到刺激频率及其部分谐波处的峰值。
我们将把“经典”的 PSD 图与 SNR 频谱图进行对比。SNR 计算为给定频率点(bin)的功率与其邻近频率点平均功率之比。与直接使用原始 PSD 相比,这一做法有两个优点:
它对频谱做了归一化,并考虑了 1/f 功率衰减。
非极窄带的功率调制会消失。
计算功率谱密度(PSD)#
频谱将使用快速傅里叶变换(FFT)计算。这在稳态响应文献中似乎是常见做法,其基础是对刺激与假定响应的精确了解,尤其是响应随时间保持稳定的假设。相关讨论可参阅 Bach & Meigen (1999)。
我们将把每个试次的第一秒排除在分析之外:
稳态响应通常需要一段时间才能稳定,开头的瞬态阶段会扭曲信号估计。
预期这一时间段的数据主要由与刺激起始相关的响应所主导,而这并非我们关注的内容。
在 MNE 中,纯 FFT 被视为 Welch 方法的一个特例:只有一个覆盖整个试次的 Welch 窗口,且不使用特定的窗函数(即应用矩形窗 boxcar)。
tmin = 1.0
tmax = 20.0
fmin = 1.0
fmax = 90.0
sfreq = epochs.info["sfreq"]

spectrum = epochs.compute_psd(
    "welch",
    n_fft=int(sfreq * (tmax - tmin)),
    n_overlap=0,
    n_per_seg=None,
    tmin=tmin,
    tmax=tmax,
    fmin=fmin,
    fmax=fmax,
    window="boxcar",
    verbose=False,
)
psds, freqs = spectrum.get_data(return_freqs=True)
计算信噪比(SNR)#
我们这里定义的 SNR 是一种相对功率度量:它是给定频率点(“信号”)的功率与“噪声”基线即周围频率点平均功率之比。该方法最初由 Meigen & Bach (1999) 提出。
因此,我们需要为这一基线设置一些参数:计算时取多少个邻近频率点,以及是否跳过紧邻的频率点(如果刺激频率不够稳定,或频带非常窄,这样做是有意义的)。
下面的函数实现了我们所需的功能。
def snr_spectrum(psd, noise_n_neighbor_freqs=1, noise_skip_neighbor_freqs=1):
    """Compute SNR spectrum from PSD spectrum using convolution.

    Parameters
    ----------
    psd : ndarray, shape ([n_trials, n_channels,] n_frequency_bins)
        Data object containing PSD values. Works with arrays as produced by
        MNE's PSD functions or channel/trial subsets.
    noise_n_neighbor_freqs : int
        Number of neighboring frequencies used to compute noise level.
        increment by one to add one frequency bin ON BOTH SIDES
    noise_skip_neighbor_freqs : int
        set this >=1 if you want to exclude the immediately neighboring
        frequency bins in noise level calculation

    Returns
    -------
    snr : ndarray, shape ([n_trials, n_channels,] n_frequency_bins)
        Array containing SNR for all epochs, channels, frequency bins.
        NaN for frequencies on the edges, that do not have enough neighbors on
        one side to calculate SNR.
    """
    # Construct a kernel that calculates the mean of the neighboring
    # frequencies
    averaging_kernel = np.concatenate(
        (
            np.ones(noise_n_neighbor_freqs),
            np.zeros(2 * noise_skip_neighbor_freqs + 1),
            np.ones(noise_n_neighbor_freqs),
        )
    )
    averaging_kernel /= averaging_kernel.sum()

    # Calculate the mean of the neighboring frequencies by convolving with the
    # averaging kernel.
    mean_noise = np.apply_along_axis(
        lambda psd_: np.convolve(psd_, averaging_kernel, mode="valid"), axis=-1, arr=psd
    )

    # The mean is not defined on the edges so we will pad it with nas. The
    # padding needs to be done for the last dimension only so we set it to
    # (0, 0) for the other ones.
    edge_width = noise_n_neighbor_freqs + noise_skip_neighbor_freqs
    pad_width = [(0, 0)] * (mean_noise.ndim - 1) + [(edge_width, edge_width)]
    mean_noise = np.pad(mean_noise, pad_width=pad_width, constant_values=np.nan)

    return psd / mean_noise
现在我们调用该函数来计算 SNR 频谱。
如上所述,我们需要定义两个参数。
需要多少个噪声频率点?
是否跳过紧邻目标频率点的 n 个频率点?
调整这些参数会显著影响最终的频谱,但主要是在你选择极端取值时。例如,如果跳过非常多邻近频率点,宽带功率调制(如 alpha 峰)应当会重新出现在 SNR 频谱中。反之,如果完全不跳过,当诱发功率分布在两个或多个频率点上时(例如刺激频率并非完全恒定,或频率点非常窄),你可能会遗漏峰值或使其变得模糊。
这里,我们希望将每个频率点的功率与两侧各三个邻近频率点的平均功率进行比较,并跳过紧邻的一个频率点。
绘制 PSD 与 SNR 频谱#
现在我们将绘制每个频率点的总平均 PSD(蓝色)与 SNR(红色)及其 ± 标准差。PSD 以对数尺度绘制。
fig, axes = plt.subplots(2, 1, sharex="all", sharey="none", figsize=(8, 5))
freq_range = range(
    np.where(np.floor(freqs) == 1.0)[0][0], np.where(np.ceil(freqs) == fmax - 1)[0][0]
)

psds_plot = 10 * np.log10(psds)
psds_mean = psds_plot.mean(axis=(0, 1))[freq_range]
psds_std = psds_plot.std(axis=(0, 1))[freq_range]
axes[0].plot(freqs[freq_range], psds_mean, color="b")
axes[0].fill_between(
    freqs[freq_range], psds_mean - psds_std, psds_mean + psds_std, color="b", alpha=0.2
)
axes[0].set(title="PSD spectrum", ylabel="Power Spectral Density [dB]")

# SNR spectrum
snr_mean = snrs.mean(axis=(0, 1))[freq_range]
snr_std = snrs.std(axis=(0, 1))[freq_range]

axes[1].plot(freqs[freq_range], snr_mean, color="r")
axes[1].fill_between(
    freqs[freq_range], snr_mean - snr_std, snr_mean + snr_std, color="r", alpha=0.2
)
axes[1].set(
    title="SNR spectrum",
    xlabel="Frequency [Hz]",
    ylabel="SNR",
    ylim=[-2, 30],
    xlim=[fmin, fmax],
)
fig.show()
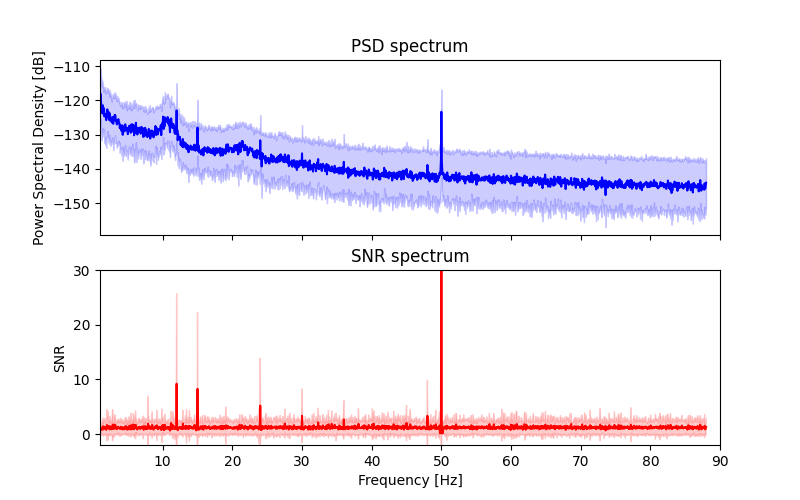
可以看到,刺激频率(12 Hz、15 Hz)及其谐波处的峰值在两幅图中都清晰可见(50 Hz 的线噪声同样如此)。不过,SNR 频谱将它们更突出地显示为 SNR = 1 附近略带噪声但大致恒定的基线上的峰值。你还能看到,SNR 处理去除了任何宽带功率差异(例如 10 Hz 附近 alpha 频段功率的升高),也去除了 PSD 中的 1/f 衰减。
请注意,虽然 SNR 图暗示可能出现小于 0 的值(均值减标准差),但这样的值是没有意义的。每个 SNR 值都是正的 PSD 值之比,而 PSD 的最小可能值为 0(上面板中 Y 轴的负值仅仅是由于以对数尺度绘制 PSD 造成的)。因此 SNR 值必定为正,最小只能趋近于 0。
提取刺激频率处的 SNR 值#
我们的处理得到了一个大型数组,其中包含 PSD 数组中每个试次 × 通道 × 频率点组合的众多 SNR 值。
显然,统计分析需要我们定义该数组的特定子集。首先,我们只关心刺激频率处的 SNR,同时还希望把分析限制在某个空间 ROI 内。最后,要回答你感兴趣的研究问题,很可能需要比较不同试次中的 SNR。
因此,我们需要找到试次、通道等的索引。另一种做法是:在分段(epoching)阶段就利用 MNE 的事件信息完成试次子集选择,并对不同的 epoch 结构分别处理。
目前,我们只看 12 Hz 刺激的试次。
# define stimulation frequency
stim_freq = 12.0
获取刺激频率(12 Hz)对应的索引#
理想情况下,应有一个频率点恰好以刺激频率为中心。但取决于你所用的频谱分解方法,情况并非总是如此。我们将找到最接近的频率点——它应当包含我们的频率标记响应。
# find index of frequency bin closest to stimulation frequency
i_bin_12hz = np.argmin(abs(freqs - stim_freq))
# could be updated to support multiple frequencies

# for later, we will already find the 15 Hz bin and the 1st and 2nd harmonic
# for both.
i_bin_24hz = np.argmin(abs(freqs - 24))
i_bin_36hz = np.argmin(abs(freqs - 36))
i_bin_15hz = np.argmin(abs(freqs - 15))
i_bin_30hz = np.argmin(abs(freqs - 30))
i_bin_45hz = np.argmin(abs(freqs - 45))
获取不同试次类型的索引#
i_trial_12hz = np.where(epochs.annotations.description == "12hz")[0]
i_trial_15hz = np.where(epochs.annotations.description == "15hz")[0]
获取构成 ROI 的 EEG 通道索引#
# Define different ROIs
roi_vis = [
    "POz",
    "Oz",
    "O1",
    "O2",
    "PO3",
    "PO4",
    "PO7",
    "PO8",
    "PO9",
    "PO10",
    "O9",
    "O10",
]  # visual roi

# Find corresponding indices using mne.pick_types()
picks_roi_vis = mne.pick_types(
    epochs.info, eeg=True, stim=False, exclude="bads", selection=roi_vis
)
应用子集选择并检查结果#
现在只需应用我们的选择并得到结果。因此,我们通常报告该子集上的总平均 SNR。
本教程不检验神经响应是否存在。在 SNR 通常较低的 ASSR 文献中,这一点常被验证,适合使用 F 检验或 Hotelling T²。
snrs_target = snrs[i_trial_12hz, :, i_bin_12hz][:, picks_roi_vis]
print("sub 2, 12 Hz trials, SNR at 12 Hz")
print(f"average SNR (occipital ROI): {snrs_target.mean()}")
sub 2, 12 Hz trials, SNR at 12 Hz
average SNR (occipital ROI): 41.693655417186164
vSSR 的地形分布#
不过等等……正如引言所述,我们事先已决定使用枕区通道子集(即视觉感兴趣区,ROI)上的平均 SNR,因为我们预期这些通道的 SNR 高于其他通道。
让我们检验一下这个决定是否明智!
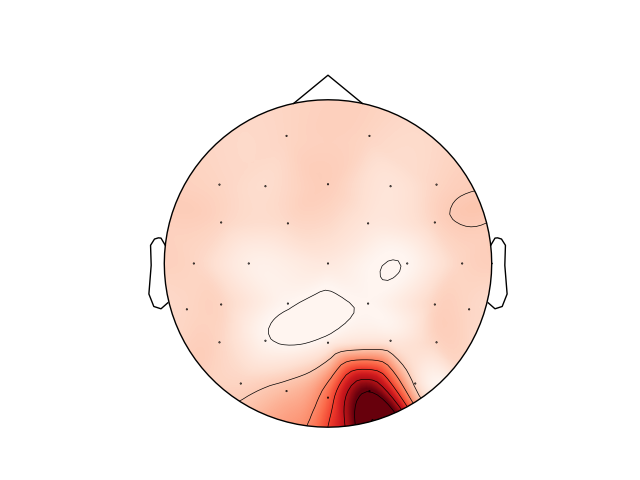
这里我们将以地形图(topoplot)形式绘制每个通道位置的平均 SNR,然后做简单的配对 T 检验,检验两组通道上的平均 SNR 是否显著不同。
# get average SNR at 12 Hz for ALL channels
snrs_12hz = snrs[i_trial_12hz, :, i_bin_12hz]
snrs_12hz_chaverage = snrs_12hz.mean(axis=0)

# plot SNR topography
fig, ax = plt.subplots(1)
mne.viz.plot_topomap(snrs_12hz_chaverage, epochs.info, vlim=(1, None), axes=ax)

print("sub 2, 12 Hz trials, SNR at 12 Hz")
print(f"average SNR (all channels): {snrs_12hz_chaverage.mean()}")
print(f"average SNR (occipital ROI): {snrs_target.mean()}")

tstat_roi_vs_scalp = ttest_rel(snrs_target.mean(axis=1), snrs_12hz.mean(axis=1))
print(
    "12 Hz SNR in occipital ROI is significantly larger than 12 Hz SNR over all "
    f"channels: t = {tstat_roi_vs_scalp[0]:.3f}, p = {tstat_roi_vs_scalp[1]}"
)
sub 2, 12 Hz trials, SNR at 12 Hz
average SNR (all channels): 16.985902190338
average SNR (occipital ROI): 41.693655417186164
12 Hz SNR in occipital ROI is significantly larger than 12 Hz SNR over all channels: t = 6.950, p = 6.681036517815665e-05
我们可以看到:1)该被试确实在枕区表现出高 SNR 的通道簇;2)所有通道的平均 SNR 小于上面计算的视觉 ROI 平均值。差异具有统计学显著性。很好!
这样的地形图是探索和分析数据的好工具——例如,你可以尝试改变参考会如何影响 SNR 值的空间分布。
然而,我们展示这张图也是想指出频率标记(或任何其他脑成像)数据的一个潜在问题:通道数量很多,你总会在某处找到一些统计显著的效应。很容易——甚至可能在无意中——陷入双重使用数据(double-dipping)或 p 值操纵(p-hacking)。因此,如果你想使用 ROI 或单个通道,最好事先选定——在采集或查看数据之前——并预注册这一决定,这样别人才会相信你。如果你是因为某个通道或 ROI 在分析(例如探索性分析)中显示出效应而选择它来报告,这也无可厚非,但要透明地说明,并对多重比较进行校正。
12 Hz 与 15 Hz vSSR 的统计区分#
结束这段关于开放科学的小插曲后,让我们继续做原本想做的分析:
我们将展示能够轻松检测并区分不同刺激频率试次中的大脑响应。
在上面的频谱与 SNR 频谱图中,我们把所有试次混在了一起。现在我们将分别提取两类试次在 12 Hz 和 15 Hz 处的 SNR,并用简单的 t 检验比较这些值。我们还会提取两个刺激频率的第 1 和第 2 谐波的 SNR。这些值也常被报告,并能揭示有趣的交互作用。
snrs_roi = snrs[:, picks_roi_vis, :].mean(axis=1)

freq_plot = [12, 15, 24, 30, 36, 45]
color_plot = ["darkblue", "darkgreen", "mediumblue", "green", "blue", "seagreen"]
xpos_plot = [-5.0 / 12, -3.0 / 12, -1.0 / 12, 1.0 / 12, 3.0 / 12, 5.0 / 12]
fig, ax = plt.subplots()
labels = ["12 Hz trials", "15 Hz trials"]
x = np.arange(len(labels))  # the label locations
width = 0.6  # the width of the bars
res = dict()

# loop to plot SNRs at stimulation frequencies and harmonics
for i, f in enumerate(freq_plot):
    # extract snrs
    stim_12hz_tmp = snrs_roi[i_trial_12hz, np.argmin(abs(freqs - f))]
    stim_15hz_tmp = snrs_roi[i_trial_15hz, np.argmin(abs(freqs - f))]
    SNR_tmp = [stim_12hz_tmp.mean(), stim_15hz_tmp.mean()]
    # plot (with std)
    ax.bar(
        x + width * xpos_plot[i],
        SNR_tmp,
        width / len(freq_plot),
        yerr=np.std(SNR_tmp),
        label=f"{f} Hz SNR",
        color=color_plot[i],
    )
    # store results for statistical comparison
    res[f"stim_12hz_snrs_{f}hz"] = stim_12hz_tmp
    res[f"stim_15hz_snrs_{f}hz"] = stim_15hz_tmp

# Add some text for labels, title and custom x-axis tick labels, etc.
ax.set_ylabel("SNR")
ax.set_title("Average SNR at target frequencies")
ax.set_xticks(x)
ax.set_xticklabels(labels)
ax.legend([f"{f} Hz" for f in freq_plot], title="SNR at:")
ax.set_ylim([0, 70])
ax.axhline(1, ls="--", c="r")
fig.show()
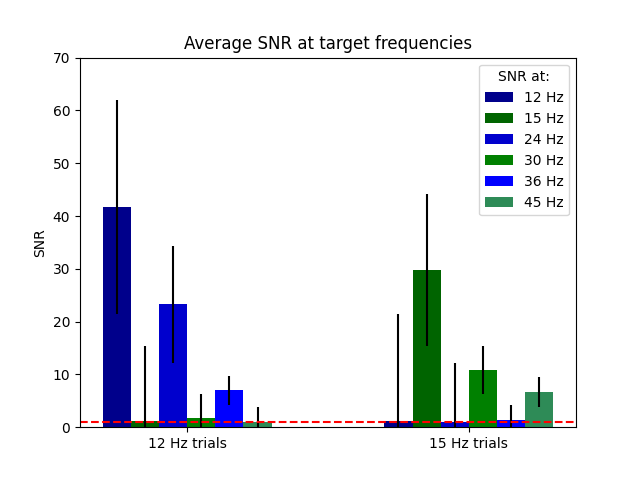
如你所见,不同试次之间存在显著差异。让我们用一系列双尾配对 T 检验来验证。
# Compare 12 Hz and 15 Hz SNR in trials after averaging over channels

tstat_12hz_trial_stim = ttest_rel(
    res["stim_12hz_snrs_12hz"], res["stim_12hz_snrs_15hz"]
)
print(
    "12 Hz Trials: 12 Hz SNR is significantly higher than 15 Hz SNR: t = "
    f"{tstat_12hz_trial_stim[0]:.3f}, p = {tstat_12hz_trial_stim[1]}"
)

tstat_12hz_trial_1st_harmonic = ttest_rel(
    res["stim_12hz_snrs_24hz"], res["stim_12hz_snrs_30hz"]
)
print(
    "12 Hz Trials: 24 Hz SNR is significantly higher than 30 Hz SNR: t = "
    f"{tstat_12hz_trial_1st_harmonic[0]:.3f}, p = {tstat_12hz_trial_1st_harmonic[1]}"
)

tstat_12hz_trial_2nd_harmonic = ttest_rel(
    res["stim_12hz_snrs_36hz"], res["stim_12hz_snrs_45hz"]
)
print(
    "12 Hz Trials: 36 Hz SNR is significantly higher than 45 Hz SNR: t = "
    f"{tstat_12hz_trial_2nd_harmonic[0]:.3f}, p = {tstat_12hz_trial_2nd_harmonic[1]}"
)

print()
tstat_15hz_trial_stim = ttest_rel(
    res["stim_15hz_snrs_12hz"], res["stim_15hz_snrs_15hz"]
)
print(
    "15 Hz trials: 12 Hz SNR is significantly lower than 15 Hz SNR: t = "
    f"{tstat_15hz_trial_stim[0]:.3f}, p = {tstat_15hz_trial_stim[1]}"
)

tstat_15hz_trial_1st_harmonic = ttest_rel(
    res["stim_15hz_snrs_24hz"], res["stim_15hz_snrs_30hz"]
)
print(
    "15 Hz trials: 24 Hz SNR is significantly lower than 30 Hz SNR: t = "
    f"{tstat_15hz_trial_1st_harmonic[0]:.3f}, p = {tstat_15hz_trial_1st_harmonic[1]}"
)

tstat_15hz_trial_2nd_harmonic = ttest_rel(
    res["stim_15hz_snrs_36hz"], res["stim_15hz_snrs_45hz"]
)
print(
    "15 Hz trials: 36 Hz SNR is significantly lower than 45 Hz SNR: t = "
    f"{tstat_15hz_trial_2nd_harmonic[0]:.3f}, p = {tstat_15hz_trial_2nd_harmonic[1]}"
)
12 Hz Trials: 12 Hz SNR is significantly higher than 15 Hz SNR: t = 7.510, p = 3.654319181452064e-05
12 Hz Trials: 24 Hz SNR is significantly higher than 30 Hz SNR: t = 8.489, p = 1.3738935966392394e-05
12 Hz Trials: 36 Hz SNR is significantly higher than 45 Hz SNR: t = 14.899, p = 1.196213562645675e-07

15 Hz trials: 12 Hz SNR is significantly lower than 15 Hz SNR: t = -5.692, p = 0.0002973675004622586
15 Hz trials: 24 Hz SNR is significantly lower than 30 Hz SNR: t = -7.916, p = 2.408626981022486e-05
15 Hz trials: 36 Hz SNR is significantly lower than 45 Hz SNR: t = -3.519, p = 0.0065249657339987695
小结#
就到这里,希望你喜欢我们对这个示例数据集的简短之旅。
如你所见,频率标记是一种非常强大的工具,可以获得极高的信噪比和效应量,甚至能在单个被试、仅持续几秒的单个试次中检测到大脑响应。
附加练习#
对于格外有兴致的读者,我们来看看还能用这些数据展示些什么。
使用 MNE 中实现的 PSD 函数,可以很容易地改变频谱估计实际使用的数据量。
这里我们借此展示频率标记数据的一些特性,这些特性你可能已经直觉上预期到了,也可能没有:
试次时长对 SNR 的影响#
首先,我们通过只取 20 s 试次的前 x 秒(2、4、6、8、…、20 s)来模拟更短的试次,并使用覆盖整个 epoch 的 FFT 窗口计算 SNR:
stim_bandwidth = 0.5

# shorten data and welch window
window_lengths = [i for i in range(2, 21, 2)]
window_snrs = [[]] * len(window_lengths)
for i_win, win in enumerate(window_lengths):
    # compute spectrogram
    this_spectrum = epochs["12hz"].compute_psd(
        "welch",
        n_fft=int(sfreq * win),
        n_overlap=0,
        n_per_seg=None,
        tmin=0,
        tmax=win,
        window="boxcar",
        fmin=fmin,
        fmax=fmax,
        verbose=False,
    )
    windowed_psd, windowed_freqs = this_spectrum.get_data(return_freqs=True)
    # define a bandwidth of 1 Hz around stimfreq for SNR computation
    bin_width = windowed_freqs[1] - windowed_freqs[0]
    skip_neighbor_freqs = (
        round((stim_bandwidth / 2) / bin_width - bin_width / 2.0 - 0.5)
        if (bin_width < stim_bandwidth)
        else 0
    )
    n_neighbor_freqs = int(
        (
            sum((windowed_freqs <= 13) & (windowed_freqs >= 11))
            - 1
            - 2 * skip_neighbor_freqs
        )
        / 2
    )
    # compute snr
    windowed_snrs = snr_spectrum(
        windowed_psd,
        noise_n_neighbor_freqs=n_neighbor_freqs if (n_neighbor_freqs > 0) else 1,
        noise_skip_neighbor_freqs=skip_neighbor_freqs,
    )
    window_snrs[i_win] = windowed_snrs[
        :, picks_roi_vis, np.argmin(abs(windowed_freqs - 12.0))
    ].mean(axis=1)

fig, ax = plt.subplots(1)
ax.boxplot(window_snrs, tick_labels=window_lengths, orientation="vertical")
ax.set(
    title="Effect of trial duration on 12 Hz SNR",
    ylabel="Average SNR",
    xlabel="Trial duration [s]",
)
ax.axhline(1, ls="--", c="r")
fig.show()
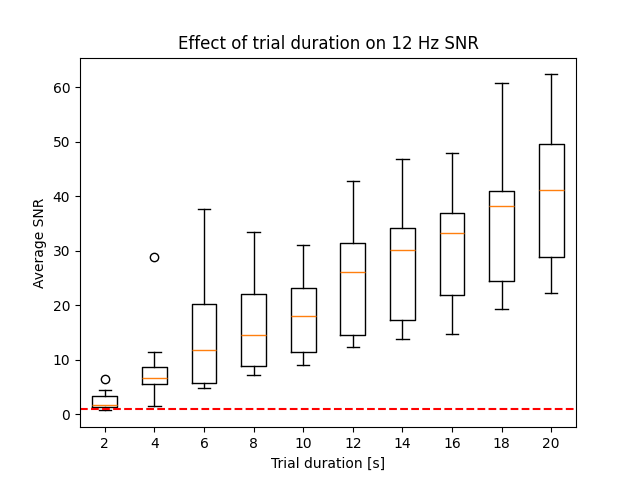
可以看到,信号估计/我们的 SNR 指标随试次时长增加而增大。
这很容易理解:记录越长,信号就越多(在我们的例子中,每多一秒刺激就增加 12 个信号周期),而噪声(但愿如此)是随机的,且不与刺激频率锁相。换句话说:数据越多,信号项增长得比噪声项更快。
我们还能看到,FFT 窗口小于 2–3 s 的极短试次效果不佳——此时我们或者触及了噪声下限,或者试次起始的瞬态响应占据了试次的太大比例。
同样,本教程不对神经响应是否存在进行统计检验,但 F 检验或 Hotelling T² 适合用于此目的。
时间分辨 SNR#
……最后,我们还可以巧妙利用 MNE 的 PSD 实现来进行滑动窗口分析,从而得到时间分辨的 SNR 指标。这将揭示被试是否眨眼或挠了挠头……
在下图中,十个试次各用一种颜色表示。
# 3s sliding window
window_length = 4
window_starts = [i for i in range(20 - window_length)]
window_snrs = [[]] * len(window_starts)

for i_win, win in enumerate(window_starts):
    # compute spectrogram
    this_spectrum = epochs["12hz"].compute_psd(
        "welch",
        n_fft=int(sfreq * window_length) - 1,
        n_overlap=0,
        n_per_seg=None,
        window="boxcar",
        tmin=win,
        tmax=win + window_length,
        fmin=fmin,
        fmax=fmax,
        verbose=False,
    )
    windowed_psd, windowed_freqs = this_spectrum.get_data(return_freqs=True)
    # define a bandwidth of 1 Hz around stimfreq for SNR computation
    bin_width = windowed_freqs[1] - windowed_freqs[0]
    skip_neighbor_freqs = (
        round((stim_bandwidth / 2) / bin_width - bin_width / 2.0 - 0.5)
        if (bin_width < stim_bandwidth)
        else 0
    )
    n_neighbor_freqs = int(
        (
            sum((windowed_freqs <= 13) & (windowed_freqs >= 11))
            - 1
            - 2 * skip_neighbor_freqs
        )
        / 2
    )
    # compute snr
    windowed_snrs = snr_spectrum(
        windowed_psd,
        noise_n_neighbor_freqs=n_neighbor_freqs if (n_neighbor_freqs > 0) else 1,
        noise_skip_neighbor_freqs=skip_neighbor_freqs,
    )
    window_snrs[i_win] = windowed_snrs[
        :, picks_roi_vis, np.argmin(abs(windowed_freqs - 12.0))
    ].mean(axis=1)

fig, ax = plt.subplots(1)
colors = plt.colormaps["Greys"](np.linspace(0, 1, 10))
for i in range(10):
    ax.plot(window_starts, np.array(window_snrs)[:, i], color=colors[i])
ax.set(
    title=f"Time resolved 12 Hz SNR - {window_length}s sliding window",
    ylabel="Average SNR",
    xlabel="t0 of analysis window [s]",
)
ax.axhline(1, ls="--", c="r")
ax.legend(["individual trials in greyscale"])
fig.show()
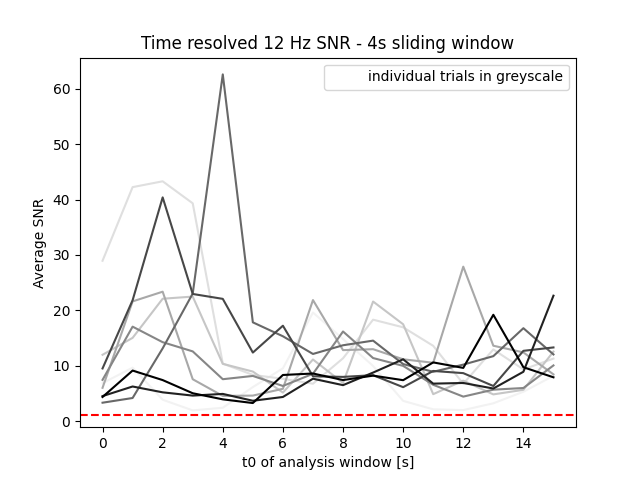
好吧……看来这有点过于乐观了 ;)
不过说真的:这个想法不错,但我们已经触及这个单被试示例数据集的极限。不过,在某些数据、应用或研究问题中,这样的分析可能是有意义的。
脚本总运行时间:(0 分钟 3.497 秒)