
算法与其他实现细节#
本页介绍 MNE-Python 实现中的一些技术细节。
内部表示(单位)#
无论厂商的数据格式使用何种单位,MNE-Python 在导入数据时都会将测量值统一转换为相同的标准单位。因此,数据在内存中的表示始终为:
伏特(
eeg、eog、seeg、emg、ecg、bio、ecog、dbs)特斯拉(磁强计)
特斯拉/米(梯度计)
安培·米(偶极子拟合、最小范数估计等)
摩尔/升(“摩尔浓度”;fNIRS 数据:氧合血红蛋白(
hbo)、脱氧血红蛋白(hbr))任意单位(各种派生的无量纲量)
但请注意,MNE-Python 的大多数绘图函数在绘图时会对数据进行缩放,以便在合理范围内给出美观的坐标轴标注;例如,绘制 MEG 和 EEG 数据时,mne.io.Raw.plot_psd() 会将特斯拉转换为飞特斯拉(fT),将伏特转换为微伏(µV)。
当从 MNE-Python 对象中提取数据并在 MNE-Python 之外进行处理时(例如使用 get_data() 或 to_data_frame() 等方法将数据转换为 NumPy 数组或 Pandas DataFrame,以便用其他 Python 模块分析或绘图),尤其需要牢记内部数据表示所使用的单位。
浮点精度#
MNE-Python 的所有计算都在内存中以双精度 64 位浮点格式完成。这意味着数据一旦读入内存就会被转换为 float64 格式。这样做的原因是,使用 64 位格式时滤波和预处理等操作更为精确。不过,出于向后兼容的考虑,MNE-Python 默认以 32 位格式写入 .fif 文件。这能减小数据保存到磁盘时的文件体积,但要注意,把中间结果保存到磁盘后再重新加载可能会造成精度损失。如果希望确保 64 位精度,有两种办法:
在内存中连续执行各项操作,避免保存中间结果。
保存中间结果,但通过
mne.io.Raw.save()的fmt参数(或mne.Epochs.save()等)更改保存时使用的 dtype。不过请注意,这可能使.fif文件在 MNE-Python 之外的软件包中无法读取。
支持的通道类型#
MNE-Python 中的通道类型以缩写或简称表示。本页列出所有支持的通道类型、其缩写名称,以及表示该类型数据所用的测量单位。若某通道类型包含两个或多个子类型,子类型缩写以括号给出。有关测量单位的更多信息,请参见“内部表示(单位)”一节。
| 通道类型 | 说明 | 测量单位 |
|---|---|---|
eeg |
头皮脑电图(EEG) | 伏特 |
meg (mag) |
脑磁图(磁强计) | 特斯拉 |
meg (grad) |
脑磁图(梯度计) | 特斯拉/米 |
ecg |
心电图(ECG) | 伏特 |
seeg |
立体定向 EEG 通道 | 伏特 |
dbs |
脑深部电刺激(DBS) | 伏特 |
ecog |
皮层脑电图(ECoG) | 伏特 |
fnirs (hbo) |
功能性近红外光谱(氧合血红蛋白) | 摩尔/升 |
fnirs (hbr) |
功能性近红外光谱(脱氧血红蛋白) | 摩尔/升 |
emg |
肌电图(EMG) | 伏特 |
eog |
眼电图(EOG) | 伏特 |
bio |
其他生物信号通道(例如皮肤电导) | 任意单位 |
stim |
刺激(又称触发)通道 | 任意单位 |
resp |
呼吸监测通道 | 伏特 |
chpi |
连续头位指示(HPI)线圈通道 | 特斯拉 |
exci |
磁通激励通道 | |
ias |
内部主动屏蔽数据(仅限 Triux 系统?) | |
syst |
系统状态通道信息(仅限 Triux 系统) | |
temperature |
温度 | 摄氏度 |
gsr |
皮肤电反应 | 西门子(S) |
ref_meg |
参考磁强计 | 特斯拉 |
dipole |
偶极子幅值 | 安培 |
gof |
拟合优度(GOF) | 拟合优度 |
cw-nirs (amp) |
连续波功能性近红外光谱(CW-fNIRS)(连续波幅值) | 伏特 |
fd-nirs (ac amp) |
频域近红外光谱(FD-NIRS 交流幅值) | 伏特 |
fd-nirs (phase) |
频域近红外光谱(FD-NIRS 相位) | 弧度 |
fnirs (od) |
功能性近红外光谱(光密度) | 伏特 |
csd |
电流源密度 | 伏特/平方米 |
eyegaze |
眼动追踪(注视位置) | 任意单位 |
pupil |
眼动追踪(瞳孔大小) | 任意单位 |
支持的数据格式#
MNE-Python 加载传感器数据时,数据存储在 mne.io.Raw 类型的 Python 对象中。针对众多设备厂商的原始数据文件格式,MNE-Python 提供了专门的加载函数。所有原始数据输入/输出函数都位于 mne.io 中,并以 read_raw_* 开头;关于读取特定文件类型的更多信息,请参阅各读取函数的文档。
如下表所示,MNE-Python 还支持一些由其他神经影像分析软件包定义的格式(EEGLAB、FieldTrip)。与设备专用加载函数一样,这些函数同样返回 Raw 类的对象;此外还提供用于读取已分段或已平均数据的其他函数(见下表)。
| 数据类型 | 文件格式 | 扩展名 | MNE-Python 函数 |
|---|---|---|---|
MEG |
.bin |
mne.io.read_raw_artemis123() |
|
MEG |
<dir> | mne.io.read_raw_bti() |
|
MEG |
<dir> | mne.io.read_raw_ctf() |
|
| MEG 与 EEG | .fif |
mne.io.read_raw_fif() |
|
MEG |
.bin |
mne.io.read_raw_fil() |
|
MEG |
.sqd |
mne.io.read_raw_kit()、mne.read_epochs_kit() |
|
| MEG 与 EEG | .mat |
mne.io.read_raw_fieldtrip()、mne.read_epochs_fieldtrip()、mne.read_evoked_fieldtrip() |
|
EEG |
.vhdr |
mne.io.read_raw_brainvision() |
|
EEG |
Biosemi 数据格式 | .bdf |
mne.io.read_raw_bdf() |
EEG |
.cnt |
mne.io.read_raw_cnt() |
|
EEG |
欧洲数据格式(EDF) | .edf |
mne.io.read_raw_edf() |
EEG |
.set |
mne.io.read_raw_eeglab()、mne.read_epochs_eeglab() |
|
EEG |
EGI 简单二进制格式 | .egi |
mne.io.read_raw_egi() |
EEG |
EGI MFF 格式 | .mff |
mne.io.read_raw_egi() |
EEG |
.nxe |
mne.io.read_raw_eximia() |
|
EEG |
通用数据格式(GDF) | .gdf |
mne.io.read_raw_gdf() |
EEG |
.data |
mne.io.read_raw_nicolet() |
|
EEG |
.lay |
mne.io.read_raw_persyst() |
|
NIRS |
目录 | mne.io.read_raw_nirx() |
|
NIRS |
目录 | mne.io.read_raw_boxy() |
|
EYETRACK |
SR eyelink ASCII 文件 | .asc |
mne.io.read_raw_eyelink() |
iEEG |
MEF3 |
.mefd |
mne.io.read_raw_mef() |
更多细节请参见“读取不同记录系统的数据”部分中的教程。
支持的三维数字化位置格式#
MNE-Python 可以加载由数字化系统获得的三维点位置。此类文件可用于获得 montage,随后可通过 set_montage() 将其添加到 Raw 对象。关于读取特定文件类型的更多信息,请参阅各读取函数的文档。
| 厂商 | 扩展名 | MNE-Python 函数 |
|---|---|---|
Neuromag |
.fif |
mne.channels.read_dig_fif() |
Polhemus ISOTRAK |
.hsp, .elp, .eeg |
mne.channels.read_dig_polhemus_isotrak() |
EGI |
.xml |
mne.channels.read_dig_egi() |
MNE-C |
.hpts |
mne.channels.read_dig_hpts() |
Brain Products |
.bvct |
mne.channels.read_dig_captrak() |
Compumedics |
.dat, .cdt |
mne.channels.read_dig_curry() |
| Compumedics(旧版) | .dat |
mne.channels.read_dig_dat() |
要加载 Polhemus FastSCAN 文件,可以使用 montage。
也可以使用 mne.channels.make_dig_montage() 从数组创建 montage。
内存高效的 I/O#
预加载连续(原始)数据#
MNE-Python 可以利用原始数据读取函数提供的 preload 选项按需读取数据。例如:
from mne import io
from mne.datasets import sample
data_path = sample.data_path()
raw_fname = data_path / 'MEG' / 'sample' / 'sample_audvis_filt-0-40_raw.fif'
raw = io.read_raw_fif(raw_fname, preload=False)
注意
当 preload=False 时,滤波、重采样以及丢弃或选择通道均无法工作。
预加载分段(Epochs)数据#
类似地,Epochs 也可以从磁盘按需读取。例如:
import mne
events = mne.find_events(raw)
event_id, tmin, tmax = 1, -0.2, 0.5
picks = mne.pick_types(raw.info, meg=True, eeg=True, stim=False, eog=True)
epochs = mne.Epochs(raw, events, event_id, tmin, tmax, picks=picks,
                    baseline=(None, 0), reject=dict(eeg=80e-6, eog=150e-6),
                    preload=False)
当 preload=False 时,Epochs 数据会从磁盘按需加载。请注意,即使 raw 对象是以 preload=True 加载的,Epochs 的 preload=False 依然有效。mne.read_epochs() 也支持预加载。
警告
这有一个需要注意的地方:当 preload=False 时,基于峰峰值阈值的数据剔除是在从磁盘加载数据时执行的,而不是在创建 Epochs 对象时执行。
要在 preload=False 时显式剔除伪迹,请使用函数 mne.Epochs.drop_bad()。
显式加载数据#
如果最初选择了 preload=False,要加载数据请使用函数 mne.io.Raw.load_data() 和 mne.Epochs.load_data()。
以 NumPy 数组方式访问数据#
如果你只想把原始数据作为 NumPy 数组以便在其他框架中使用,可以使用切片语法:
first_channel_data, times = raw[0, :]
channels_3_and_4, times = raw[3:5, :]
通过插值修复坏导#
简而言之,使用球面样条插值 [1] 进行数据修复包括以下步骤:
将好电极和坏电极投影到单位球面上
计算一个将 \(N\) 个好通道映射到 \(M\) 个坏通道的映射矩阵
使用该映射矩阵计算坏通道中的插值数据
球面样条假设球面上任意一点 \(\boldsymbol{r_i}\) 处的电位 \(V(\boldsymbol{r_i})\) 可以表示为:
其中 \(C = (c_{1}, ..., c_{N})^{T}\) 是必须估计的常数。\(m\) 阶函数 \(g_{m}(\cdot)\) 由下式给出:
其中 \(P_{n}(x)\) 是 \(n\) 阶勒让德多项式。
为了估计常数 \(C\),我们必须同时求解以下两个方程:
其中 \(G_{ss} \in R^{N \times N}\) 是一个矩阵,其元素为 \(G_{ss}[i, j] = g_{m}(cos(\boldsymbol{r_i}, \boldsymbol{r_j}))\),而 \(X \in R^{N \times 1}\) 是在好通道上测得的电位 \(V(\boldsymbol{r_i})\)。\(T_{s} = (1, 1, ..., 1)^\top\) 是维度为 \(N\) 的列向量。式 (2) 是式 (1) 的矩阵形式,式 (3) 相当于对数据施加平均参考。由式 (2) 和 (3) 可得:
\(C_{i}\) 与矩阵 \({\begin{bmatrix} {T_s}^{T} && 0 \\ T_s && G_{ss} \end{bmatrix}}^{-1}\) 相同,但删去了第一列,因此得到一个维度为 \((N + 1) \times N\) 的矩阵。
现在,为了估计坏通道处的电位 \(\hat{X} \in R^{M \times 1}\),我们需要计算:
其中 \(G_{ds} \in R^{M \times N}\) 计算坏通道与好通道之间的 \(g_{m}(\boldsymbol{r_i}, \boldsymbol{r_j})\)。\(T_{d} = (1, 1, ..., 1)^\top\) 是维度为 \(M\) 的列向量。将式 (4) 代入 (5),可得
要对坏通道进行插值,只需执行:
>>> evoked.interpolate_bads(reset_bads=False)
这样坏通道就会被修复。
Maxwell 滤波#
MNE-Python 中 Maxwell 滤波的实现见“信号空间分离(SSS)与 Maxwell 滤波”教程。
信号空间投影(SSP)#
信号空间投影(Signal-Space Projection,SSP)是在软件中抑制外部干扰的一种方法。本节介绍该方法的一些相关细节。关于如何使用 SSP 剔除伪迹的实际示例,请参见“使用 SSP 修复伪迹”。
基本概念#
与许多其他噪声消除方法不同,SSP 不需要额外的参考传感器来记录干扰场。相反,SSP 依赖于这样一个事实:大脑中源所产生的磁场分布与外部噪声源所产生的磁场分布,在空间分布上具有足够的差异。此外,该方法隐含地假设,显著的外部噪声模式所张成的线性空间具有较低的维数。
不失一般性,我们总可以将任意 \(n\) 通道测量 \(b(t)\) 分解为信号分量和噪声分量:
此外,如果我们知道 \(b_n(t)\) 可以由少数几个场模式 \(b_1 \dotso b_m\) 很好地刻画,就可以将干扰表示为
其中 \(U\) 的各列构成 \(b_1 \dotso b_m\) 的一组标准正交基,\(c_n(t)\) 是 \(m\) 维列向量,误差项 \(e(t)\) 很小,且随时间不呈现任何一致的空间分布,即 \(C_e = E \{e e^\top\} = I\)。下文我们将称 \(U\) 的列空间为噪声子空间。SSP 的基本思想是:我们实际上可以找到一个小的基集合 \(b_1 \dotso b_m\),使得上述条件得到满足。现在我们可以构造正交补算子
并将其作用于式 (6) 中的 \(b(t)\),得到
因为 \(P_{\perp}b_n(t) = P_{\perp}(Uc_n(t) + e(t)) \approx 0\) 且 \(P_{\perp}b_{s}(t) \approx b_{s}(t)\)。投影算子 \(P_{\perp}\) 称为信号空间投影算子,通常能显著抑制噪声,将外部干扰压低 10 倍或更多。SSP 的有效性取决于两个因素:
基集合 \(b_1 \dotso b_m\) 应能够完整地刻画干扰场模式;以及
由 \(b_1 \dotso b_m\) 张成的噪声子空间与信号向量 \(b_s(t)\) 之间的夹角应尽可能接近 \(\pi / 2\)。
如果第一个要求未得到满足,由于 \(P_{\perp}b_n(t) \neq 0\),部分噪声会泄漏出来。如果任何脑信号向量 \(b_s(t)\) 接近噪声子空间,那么施加 \(P_{\perp}\) 时不仅噪声会被衰减,信号也会被衰减,因此信噪比的提升可能很小。
由于信号空间投影会修改源自大脑的信号向量,因此在逆运算过程中必须将投影应用于正向解。
关于 SSP 的更多信息,请参阅 Tesche et al. [2]、Uusitalo and Ilmoniemi [3] 中列出的参考文献。
噪声子空间的估计#
如上所述,应用 SSP 需要估计构成噪声子空间的信号向量 \(b_1 \dotso b_m\)。最常见的方法(也在 mne.compute_proj_raw() 中实现)是计算空房间数据的协方差矩阵,对其进行特征值分解,并使用最大特征值对应的特征向量作为噪声子空间的基。在 Vectorview 系统中,通常还分别为磁强计和梯度计使用各自的一组向量。
EEG 平均电极参考#
EEG 平均参考是所有传感器信号的均值。在 EEG 分析中,通常会从所有传感器信号 \(b^{1}(t), ..., b^{n}(t)\) 中减去平均参考,即:
其中噪声项 \(b_{n}^{j}(t)\) 由下式给出
因此,投影向量 \(P_{\perp}\) 为 \(P_{\perp}=\frac{1}{n}[1, 1, ..., 1]\)
警告
应用 SSP 时,有时也会去掉感兴趣的信号。因此,始终建议检查应用 SSP 后感兴趣效应被削弱了多少。SSP 可能同时去除伪迹和感兴趣的信号。
边界元模型(BEM)#
使用分水岭算法#
分水岭算法 [Segonne et al., 2004] 是 FreeSurfer 软件的一部分,程序名为 mri_watershed。在 MNE 环境中,可通过脚本 mne watershed_bem 方便地使用它。
mne watershed_bem 运行完成后,被试的 bem/watershed 目录中会出现以下文件:
_brain_surface _inner_skull_surface _outer_skull_surface _outer_skin_surface
所有这些表面均为 FreeSurfer 格式。此外还会有一个名为 bem/watershed/ws.mgz 的文件,其中包含脑部 MRI 体积。另外,mne watershed_bem 脚本会将头皮表面转换为 fif 格式,并将结果保存到 bem/。
使用 FLASH 图像#
该方法依赖于能否获得在两个翻转角(5 度和 30 度)下用多回波 FLASH 序列采集的 MRI 数据。这些数据可以与 FreeSurfer 皮层重建所使用的 MPRAGE 数据分开采集,但强烈建议与 MPRAGE 同时采集,或至少使用同一台扫描仪采集。为便于配准,图像的 FOV、矩阵、层厚、层间距和层面方向应与 MPRAGE 数据相同。关于合适的脉冲序列信息,请参见 Fischl et al. [4]。
使用该方法创建 BEM 网格包括以下步骤:
创建一个合成的 5 度翻转角 FLASH 体积,将其与 MPRAGE 数据配准,然后运行分割和网格生成程序。这一步通过运行脚本
mne flash_bem完成。使用
tkmedit检查网格,参见“检查网格”。
注意
各个表面可以采用不同的方法创建。例如,可能会出现分水岭算法生成的皮肤表面质量优于基于 FLASH 图像的分割方法的情况。若如此,可以将 outer_skin.surf 设置为指向相应的分水岭输出文件,而其他表面则可从 FLASH 分割数据中选取。
将 MRI 数据组织到目录中#
由于构成多回波 FLASH 数据的所有图像都包含在单个序列中,因此在开始 BEM 表面重建之前,必须按回波对图像进行组织。必要时可以使用 dcm2niix 或 MNE-C 工具 mne_organize_dicom 完成,然后使用 mne.bem.convert_flash_mris()。
创建表面剖分(三角网格)#
BEM 表面分割与三角剖分由脚本 mne flash_bem 自动完成。该脚本假定该被试的 FreeSurfer 重建已经完成。
在运行 mne flash_bem 之前,请执行以下操作:
从包含 5 度和 30 度翻转角 FLASH 序列的目录分别创建指向
flash05和flash30的符号链接:ln -s <FLASH 5 series dir> flash05ln -s <FLASH 30 series dir> flash30
某些分区格式(例如 FAT32)不支持符号链接。这种情况下,请将文件复制到相应的序列:
cp <FLASH 5 series dir> flash05cp <FLASH 30 series dir> flash30
设置
SUBJECTS_DIR和SUBJECT环境变量,或者向mne flash_bem传入--subjects-dir和--subject选项
注意
如果以 --noflash30 选项运行 mne flash_bem,则不需要 flash30 目录,即仅使用 5 度翻转角的 FLASH 数据。
mne flash_bem 可能需要较长时间才能完成。它使用 $SUBJECTS_DIR/$SUBJECT 下的 FreeSurfer 目录结构。该脚本封装了以下处理步骤:
它为
mri/flash中每个 FLASH 目录下的八个回波各创建一个 mgz 文件。文件命名为mef。_ .mgz 如果指定了
unwarp=True选项,则运行grad_unwarp并生成mef文件。这些文件随后将用于后续步骤。_ u.mgz 它使用
mri_ms_fitparms在mri/flash/parameter_maps中创建参数图。它使用
mri_synthesize在mri/flash/parameter_maps/flash5.mgz中创建合成的 5 度翻转角体积。它使用
fsl_rigid_register,将mri/flash/parameter_maps/flash5.mgz配准到mri下的 T1 体积,从而生成配准后的 5 度翻转角体积mri/flash/parameter_maps/flash5_reg.mgz。它使用
mri_convert将flash5_reg体积转换为mri/flash5下的 COR 格式。如有必要,T1 体积和脑体积也会转换为 COR 格式。它运行
mri_make_bem_surfaces以创建 BEM 表面三角剖分。它创建目录
bem/flash,将 tri 格式的三角剖分移动到该目录,并在同一目录中创建相应的 FreeSurfer 表面文件。由
mne flash_bem创建的 COR 格式体积会被删除。
如果向 mne flash_bem 指定了 --noflash30 选项,则上述步骤 3 和 4 将由对 5 度翻转角数据中不同回波时间取平均来替代。
检查网格#
建议在使用 BEM 网格之前检查其有效性。可以通过以下方式完成:
mne flash_bem的--view选项直接调用
mne.viz.plot_bem()使用 FreeSurfer 工具
tkmedit或freeview
正向解#
MEG/EEG 与 MRI 坐标系#
MNE 软件(以及 FreeSurfer)所使用的坐标系及其相互关系如“MEG/EEG 与 MRI 坐标系”所示。除传感器坐标系外,所有坐标系都是笛卡尔坐标系,并采用“RAS”(右-前-上)取向,即 \(x\) 轴指向右侧,\(y\) 轴指向前方,\(z\) 轴指向上方。
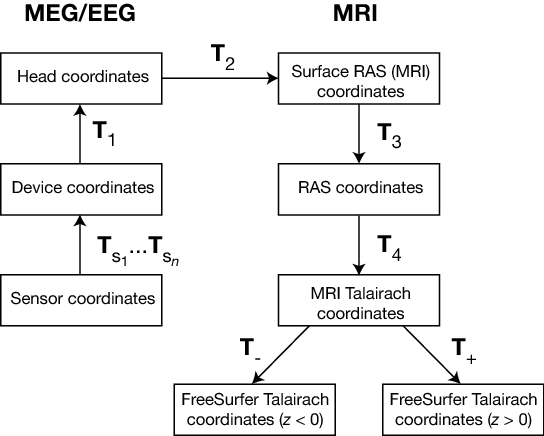
与 MEG/EEG 数据相关的坐标系有:
头部坐标系
这是一个借助基准标志点(鼻根点和两个耳点)定义的坐标系。在 fif 文件中,EEG 电极位置以该坐标系给出。此外,在 MEG、MEG/EEG 或 EEG 采集开始时获得的头部数字化数据也以头部坐标表示。详情请参见“MEG/EEG 与 MRI 坐标系”。
设备坐标系
这是与 MEG 设备绑定的坐标系。在 MEG 测量过程中,通过向 3 至 5 个头位置指示(HPI)线圈馈入电流,并根据这些线圈产生的磁场确定它们相对于 MEG 传感器阵列的位置,从而确定设备坐标与头部坐标之间的关系。
传感器坐标系
每个 MEG 传感器都有一个局部坐标系,用于定义该传感器的取向和位置。借助该坐标系,可以方便地表示计算磁场所需的数值积分数据,如“线圈几何信息”中所述。fif 文件中的通道信息数据包含用于指定每个传感器坐标与 MEG 设备坐标之间坐标变换的信息。
与 MRI 数据相关的坐标系有:
Surface RAS 坐标系
FreeSurfer 表面数据以该坐标系表示。该坐标系的原点位于规范化后的 FreeSurfer MRI 体积(通常为 256 x 256 x 256 各向同性 1-mm3 体素)的中心,各轴沿该体积的轴取向。在 fif 文件中,BEM 表面以及源空间中源的位置通常以该坐标系表示。在本手册中,Surface RAS 坐标通常称为 MRI 坐标,除非需要专门讨论不同的 MRI 相关坐标系。
RAS 坐标系
该坐标系的轴与 Surface RAS 坐标相同,但原点位置不同,由原始 MRI 数据定义,即原点位于依赖于扫描仪的位置。在使用 MNE 软件进行分析时,几乎不需要显式引用该坐标系。然而,由于下文讨论的 Talairach 坐标是相对于 RAS 坐标而非 Surface RAS 坐标定义的,因此 RAS 坐标系隐含地参与了 Surface RAS 坐标与两个 Talairach 坐标系之间的变换。
MNI Talairach 坐标系
该坐标系的定义可参见 https://imaging.mrc-cbu.cam.ac.uk/imaging/MniTalairach。该变换在 FreeSurfer 重建过程中确定。这些坐标位于 MNI305 空间中。
FreeSurfer Talairach 坐标系
MNI Talairach 坐标的问题在于,线性 MNI Talairach 变换无法使脑完全匹配 Talairach 脑。这很可能是因为 Talairach 图谱脑的形状相当特殊,因此难以用仿射变换将标准脑匹配到图谱脑。其结果是,MNI 脑比 Talairach 脑略大(尤其是更高、更深、更长)。离脑中部越远、越靠近外侧,差异就越大。FreeSurfer Talairach 坐标通过增加一个附加变换来缓解这一问题,该变换分别针对负的和正的 MNI Talairach \(z\) 坐标定义。这两个变换在“MEG/EEG 与 MRI 坐标系”中记为 \(T_-\) 和 \(T_+\),其固定方式如 https://imaging.mrc-cbu.cam.ac.uk/imaging/MniTalairach(Approach 2)所述。
不同坐标系之间通过“MEG/EEG 与 MRI 坐标系”中所示的坐标变换相联系。箭头和坐标变换符号(\(T_x\))表示 FreeSurfer 文件中实际存在的变换。一般而言,
其中 \(x_k\)、\(y_k\) 和 \(z_k\) 是两个坐标系中的位置坐标,\(T_{12}\) 是从坐标系“1”到“2”的坐标变换,\(x_0\)、\(y_0\) 和 \(z_0\) 是坐标系“1”的原点在坐标系“2”中的位置,\(R_{jk}\) 是关联两个坐标系的旋转矩阵的元素。这些坐标变换存在于 FreeSurfer 和 MNE 生成的不同文件中。固定变换 \(T_-\) 和 \(T_+\) 为:
以及
注意
本节不讨论 MRI 体素索引与不同 MRI 坐标之间的变换。但需要注意,在 FreeSurfer、MNE 以及 Neuromag 软件中,整数体素坐标对应体素中心的位置。关于 FreeSurfer MRI 系统的详细信息可参见 https://surfer.nmr.mgh.harvard.edu/fswiki/CoordinateSystems。符号 \(T_x\) 在“MEG/EEG 与 MRI 坐标系”中定义。
| 变换 | FreeSurfer |
MNE |
\(T_1\) |
不存在 | 测量数据文件;正向解文件(*fwd.fif);逆算子文件(*inv.fif) |
\(T_{s_1}\dots T_{s_n}\) |
不存在 | 包含 \(T_1\) 的文件中的通道信息。 |
\(T_2\) |
不存在 | MRI 描述文件;来自 mne coreg 的单独 -trans.fif 文件;正向解文件;逆算子文件 |
\(T_3\) |
mri/*mgz 文件 |
nibabel.freesurfer.mghformat.MGHImage |
\(T_4\) |
mri/transforms/talairach.xfm |
内部读取 |
\(T_-\) |
软件中硬编码 | 软件中硬编码。 |
\(T_+\) |
软件中硬编码 | 软件中硬编码。 |
头部与设备坐标系#
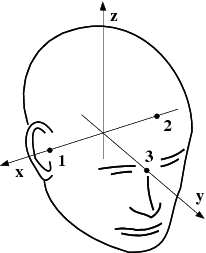
MNE 软件采用的 MEG/EEG 头部坐标系是右手笛卡尔坐标系。\(x\) 轴方向从左到右,\(y\) 轴指向前方,因此 \(z\) 轴指向上方。
头部坐标系的 \(x\) 轴穿过采集数据之前数字化的两个耳周点或耳前点,正方向向右。\(y\) 轴穿过鼻根点,并与 \(x\) 轴垂直。\(z\) 轴按右手定则指向上方,并垂直于 \(xy\) 平面。
MEG 设备坐标系的原点取决于设备。其原点大致位于最贴合 MEG 头盔枕部区域的球体中心,\(x\) 轴从左到右,\(y\) 轴指向前方。\(z\) 轴同样垂直于 \(xy\) 平面,正方向向上。
注意
上述定义与 Neuromag MEG/EEG(头部)坐标系的定义相同。然而,在 4-D Neuroimaging 和 CTF MEG 系统中,头部坐标框架的定义有所不同。坐标系原点位于左右耳点的中点。\(x\) 轴穿过鼻根点和原点,正方向向前。\(y\) 轴与 \(x\) 轴垂直,位于由三个基准标志点确定的平面内,正方向从右到左。\(z\) 轴垂直于标志点所在平面,指向上方。请注意,在这种约定中,耳点不一定位于 \(y\) 坐标轴上。文件转换工具会处理这些特殊之处,并将所有坐标信息转换为 MNE 软件的头部坐标框架。
创建基于表面的源空间#
包含偶极子位置和取向的 fif 格式源空间文件通过 mne.setup_source_space() 创建。
创建体源空间或离散源空间#
除了限于某个表面的源空间外,MNE 软件还在一定程度上支持由表面界定的三维源空间,以及由离散的、任意位置的源点构成的源空间。实用工具 mne.setup_volume_source_space() 可帮助生成此类源空间。
创建 BEM 网格#
参见“边界元模型(BEM)”。
拓扑检查#
在创建 BEM 模型期间会执行以下拓扑检查:
通过计算三角剖分内部某一点处所有三角形所张的总立体角,来确认每个表面的完整性。结果应非常接近 \(4 \pi\)。如果结果反而是 \(-4 \pi\),则可能三角形顶点的顺序不正确,此时应指定
--swap选项。通过检查各表面是否按预期相互嵌套,来验证表面顺序是否正确。具体做法是检查表面 \(S_k\) 的三角形在另一个本应位于其内部的表面 \(S_p\) 的所有顶点处所张的立体角之和是否等于 \(4 \pi\)。当然,只有当模型包含多个表面时才进行此检查。由于表面关系具有传递性,只需检查外颅骨表面位于皮肤表面内部,以及内颅骨表面位于外颅骨表面内部即可。
会检查每个三角剖分体积的范围。如果范围小于 50mm,则报告错误。这可能表明顶点坐标是以米而非毫米指定的。
计算 BEM 几何数据#
实用工具 mne.make_bem_solution() 计算 BEM 的几何信息。
线圈几何信息#
本节说明 MEG 探测线圈几何信息的表示方式,以及 MNE 软件中对不同探测线圈所采用的近似。表征探测器需要两类信息:
每个探测器的位置和取向(局部坐标系)。
一个唯一标识符,它与线圈的几何描述一一对应。
注意
MNE 自带若干线圈几何配置,可在 mne/data 中找到。不同线圈几何之间的比较请参见“Plotting sensor layouts of MEG systems”,关于描述 Neuromag 线圈几何的文件的详细信息请参见“已实现的线圈几何”。
传感器坐标系#
传感器坐标系完全由其原点的位置以及指向 x、y、z 轴方向的三个正交单位向量的方向余弦来刻画。实际上,这些单位向量包含冗余信息,因为取向可以用三个角度唯一确定。测量 fif 文件以 MEG 设备坐标列出这些数据。只要使用了头位置指示器,就可以通过应用数据文件中提供的设备到头部的坐标变换矩阵,轻松完成到 MEG 头部坐标框架的转换。此外,MNE 软件的正向计算还会对头部坐标数据施加另一个坐标变换,以将线圈位置和取向转换到 MRI 坐标系。
如果 \(r_0\) 是局部传感器坐标系原点的行向量,\(e_x\)、\(e_y\) 和 \(e_z\) 是三个正交单位向量的行向量(均以设备坐标给出),则传感器坐标中某点 \(r_C\) 的位置通过下式变换为设备坐标(\(r_D\)):
其中
磁场计算#
MNE 软件中的正向计算会针对源空间每个位置处的三个正交偶极子,计算每个 MEG 传感器检测到的信号。这需要指定导体模型、偶极子的位置和取向,以及每个 MEG 传感器的位置、取向和线圈几何。
每个 SQUID 传感器的输出是穿过构成探测线圈的各回路的磁通量的加权和。由于穿过线圈回路的磁通量是垂直于线圈平面的磁场分量的积分,第 k 个 MEG 通道的输出 \(b_k\) 可以近似为:
其中 \(r_{kp}\) 是覆盖传感器拾取线圈回路的一组 \(N_k\) 个积分点,\(B(r_{kp})\) 是在 \(r_{kp}\) 处计算的由电流源产生的磁场,\(n_{kp}\) 是这些点处的线圈法向,\(w_{kp}\) 是与积分点相关的权重。该公式本质上表示对传感器 \(k\) 拾取回路上磁场的数值积分。
上述数值积分有三个精度级别。简单精度意味着对线圈最简单的描述,MNE 的正向计算不使用该精度。普通(或推荐)精度通常对平面梯度计使用两个积分点(拾取线圈的每一半各一个),对磁强计使用四个均匀分布的积分点;这是 MNE 使用的默认精度。如果指定了 --accurate 选项,正向计算通常对平面梯度计使用共八个积分点,对磁强计使用十六个积分点。关于积分点的详细信息将在下一节给出。
已实现的线圈几何#
本节介绍 MNE 中当前实现的线圈几何。线圈类型分为两大类:
轴向梯度计和平面梯度计,以及
平面磁强计。
对于轴向传感器,局部坐标系的 z 轴平行于所检测的场分量,即垂直于线圈平面。对于圆形线圈,在垂直于 z 轴的平面上 x 轴和 y 轴的取向无关紧要。在 Vectorview (TM) 系统所用的方形线圈中,x 轴选取为平行于磁强计线圈的一条边。对于平面传感器,z 轴同样垂直于线圈平面,x 轴穿过两个线圈回路的中心点,因此当法向场分量沿 x 轴增大时,探测器输出正信号。
“普通线圈描述”列出了普通线圈几何描述的参数,“精确线圈描述”列出了精确描述。关于简单精度,请查阅线圈定义文件,参见“线圈定义文件”。这些表格的各列包含以下数据:
标识线圈 id 的编号。该编号用于 FIF 文件中的线圈描述。
线圈的描述。
使用的积分点数量
积分点在传感器坐标中的位置。
赋予积分点处场值的权重。有些地方列出的是公式而非数值,以说明计算原理。例如,在平面梯度计的普通线圈描述中,权重是梯度计基线的倒数,以表明输出单位为 T/m。
注意
线圈几何信息存储在文件 mne/data/coil_def.dat 中,该文件由 MNE-C 实用工具 mne_list_coil_def 自动创建。
Id |
说明 | n |
r/mm |
w |
|---|---|---|---|---|
2 |
Neuromag-122 平面梯度计 | 2 |
(+/-8.1, 0, 0) mm |
+/-1 ⁄ 16.2mm |
2000 |
点磁强计 | 1 |
(0, 0, 0)mm |
1 |
3012 |
Vectorview 1 型平面梯度计 | 2 |
(+/-8.4, 0, 0.3) mm |
+/-1 ⁄ 16.8mm |
3013 |
Vectorview 2 型平面梯度计 | 2 |
(+/-8.4, 0, 0.3) mm |
+/-1 ⁄ 16.8mm |
3022 |
Vectorview 1 型磁强计 | 4 |
(+/-6.45, +/-6.45, 0.3)mm |
1/4 |
3023 |
Vectorview 2 型磁强计 | 4 |
(+/-6.45, +/-6.45, 0.3)mm |
1/4 |
3024 |
Vectorview 3 型磁强计 | 4 |
(+/-5.25, +/-5.25, 0.3)mm |
1/4 |
2000 |
理想点磁强计 | 1 |
(0.0, 0.0, 0.0)mm |
1 |
4001 |
Magnes WH 磁强计 | 4 |
(+/-5.75, +/-5.75, 0.0)mm |
1/4 |
4002 |
Magnes WH 3600 轴向梯度计 | 8 |
(+/-4.5, +/-4.5, 0.0)mm (+/-4.5, +/-4.5, 50.0)mm |
1/4 -1/4 |
4003 |
Magnes 参考磁强计 | 4 |
(+/-7.5, +/-7.5, 0.0)mm |
1/4 |
4004 |
测量对角梯度的 Magnes 参考梯度计 | 8 |
(+/-20, +/-20, 0.0)mm (+/-20, +/-20, 135)mm |
1/4 -1/4 |
4005 |
测量非对角梯度的 Magnes 参考梯度计 | 8 |
(87.5, +/-20, 0.0)mm (47.5, +/-20, 0.0)mm (-87.5, +/-20, 0.0)mm (-47.5, +/-20, 0.0)mm |
1/4 -1/4 1/4 -1/4 |
5001 |
CTF 275 轴向梯度计 | 8 |
(+/-4.5, +/-4.5, 0.0)mm (+/-4.5, +/-4.5, 50.0)mm |
1/4 -1/4 |
5002 |
CTF 参考磁强计 | 4 |
(+/-4, +/-4, 0.0)mm |
1/4 |
5003 |
测量对角梯度的 CTF 参考梯度计 | 8 |
(+/-8.6, +/-8.6, 0.0)mm (+/-8.6, +/-8.6, 78.6)mm |
1/4 -1/4 |
注意
如果正负号出现在多个坐标中,则必须包含所有可能的组合。
Id |
说明 | n |
r/mm |
w |
|---|---|---|---|---|
2 |
Neuromag-122 平面梯度计 | 8 |
+/-(8.1, 0, 0) mm |
+/-1 ⁄ 16.2mm |
2000 |
点磁强计 | 1 |
(0, 0, 0) mm |
1 |
3012 |
Vectorview 1 型平面梯度计 | 2 |
(+/-8.4, 0, 0.3) mm |
+/-1 ⁄ 16.8mm |
3013 |
Vectorview 2 型平面梯度计 | 2 |
(+/-8.4, 0, 0.3) mm |
+/-1 ⁄ 16.8mm |
3022 |
Vectorview 1 型磁强计 | 4 |
(+/-6.45, +/-6.45, 0.3)mm |
1/4 |
3023 |
Vectorview 2 型磁强计 | 4 |
(+/-6.45, +/-6.45, 0.3)mm |
1/4 |
3024 |
Vectorview 3 型磁强计 | 4 |
(+/-5.25, +/-5.25, 0.3)mm |
1/4 |
4001 |
Magnes WH 磁强计 | 4 |
(+/-5.75, +/-5.75, 0.0)mm |
1/4 |
4002 |
Magnes WH 3600 轴向梯度计 | 4 |
(+/-4.5, +/-4.5, 0.0)mm (+/-4.5, +/-4.5, 0.0)mm |
1/4 -1/4 |
4004 |
测量对角梯度的 Magnes 参考梯度计 | 8 |
(+/-20, +/-20, 0.0)mm (+/-20, +/-20, 135)mm |
1/4 -1/4 |
4005 |
测量非对角梯度的 Magnes 参考梯度计 | 8 |
(87.5, +/-20, 0.0)mm (47.5, +/-20, 0.0)mm (-87.5, +/-20, 0.0)mm (-47.5, +/-20, 0.0)mm |
1/4 -1/4 1/4 -1/4 |
5001 |
CTF 275 轴向梯度计 | 8 |
(+/-4.5, +/-4.5, 0.0)mm (+/-4.5, +/-4.5, 50.0)mm |
1/4 -1/4 |
5002 |
CTF 参考磁强计 | 4 |
(+/-4, +/-4, 0.0)mm |
1/4 |
5003 |
测量对角梯度的 CTF 275 参考梯度计 | 8 |
(+/-8.6, +/-8.6, 0.0)mm (+/-8.6, +/-8.6, 78.6)mm |
1/4 -1/4 |
5004 |
测量非对角梯度的 CTF 275 参考梯度计 | 8 |
(47.8, +/-8.5, 0.0)mm (30.8, +/-8.5, 0.0)mm (-47.8, +/-8.5, 0.0)mm (-30.8, +/-8.5, 0.0)mm |
1/4 -1/4 1/4 -1/4 |
6001 |
MIT KIT 系统轴向梯度计 | 8 |
(+/-3.875, +/-3.875, 0.0)mm (+/-3.875, +/-3.875, 0.0)mm |
1/4 -1/4 |
线圈定义文件#
线圈几何信息存储在文本文件 $MNE_ROOT/share/mne/coil_def.dat 中。在该文件里,以井号(#)开头的行都是注释。一个线圈定义以描述行开始,该描述行包含以下字段:
<class>:表示该线圈类别的数字。<id>:线圈 ID 值。该值列于表“常规线圈描述”和“精确线圈描述”的第一列。<accuracy>:线圈表示精度。可能的取值及其含义列于“线圈表示精度”中。<np>:该表示中的积分点数目。<size/m>:线圈的尺寸。对于圆形线圈,这是线圈的直径;对于方形线圈,这是方形的边长。此信息主要用于方便绘制线圈几何形状,不应用来推断正演计算所需的线圈近似。<baseline/m>:此类线圈的基线。对于磁强计线圈,该值为零。此信息主要用于方便绘制线圈几何形状,不应用来推断正演计算所需的线圈近似。<description>:此类线圈的简短描述。如果描述包含多个单词,则用引号括起。
| 取值 | 含义 |
|---|---|
1 |
可用的最简单表示 |
2 |
标准或常规表示(参见“常规线圈描述”) |
3 |
可用的最精确表示(参见“精确线圈描述”) |
每个线圈描述行之后跟随一行或多行积分点行,每行由七个数字组成:
<weight>:给出该积分点的权重(表“常规线圈描述”和“精确线圈描述”中的最后一列)。<x/m><y/m><z/m>:指示积分点的位置(表“常规线圈描述”和“精确线圈描述”中的第四列)。<nx><ny><nz>:指示所要选取的场分量的单位向量的各分量。请注意,为每个积分点单独列出单位向量,使得可以实现曲面线圈,以及各梯度计线圈环彼此倾斜的线圈。
计算正向解#
目的#
关于在 MNE-Python 中使用 mne.make_forward_solution() 计算正演解的示例,可参见 Compute forward solution 和 计算正向解。
软件梯度补偿的实现#
在 MNE-Python 中,噪声抵消的处理由 mne.io.Raw.apply_gradient_compensation() 完成。示例请参见 Brainstorm CTF 体模数据集教程。
CTF 和 4D Neuroimaging 数据可能已经使用参考传感器阵列的数据进行了噪声抵消。尽管这些传感器距离脑源相当远,mne.make_forward_solution() 在计算中仍会将它们考虑在内。如果数据文件启用了软件梯度补偿,则除主 MEG 传感器阵列之外,它还会计算参考传感器处的场,并计算经过补偿的正演解。
EEG 球模型定义文件#
在 MNE-Python 中,可以通过 mne.make_sphere_model() 指定不同的球模型。默认模型具有以下结构:
| 层 | 相对外半径 | \(\sigma\) (S/m) |
|---|---|---|
| 头部 | 1.0 |
0.33 |
| 颅骨 | 0.97 |
0.04 |
| 脑脊液 | 0.92 |
1.0 |
| 脑 | 0.90 |
0.33 |
尽管球结构本身并不是 BEM 模型,但它描述了头部几何形状,因此可以作为 bem 参数传入 MNE-Python 的函数,例如 mne.fit_dipole()、mne.viz.plot_alignment() 或 mne.make_forward_solution()。
球模型中的 EEG 正向解#
使用球模型时,采用 Mosher [5]、Zhang [6] 和 Berg [7] 描述的近似方法可以显著加速 EEG 解的计算。mne.make_forward_solution() 用均匀球中的三个偶极子来近似该解,这些偶极子的位置和幅值通过最小化以下代价函数确定:
其中 \(r_1,\dotsc,r_m\) 和 \(\mu_1,\dotsc,\mu_m\) 是近似偶极子的位置和幅值,\(V_{true}\) 和 \(V_{approx}\) 分别是真实公式和近似公式给出的电位分布。可以证明,利用电位在球谐函数中的展开,该积分可表示为闭式形式。该公式针对最表层的偶极子计算,即恰好位于内颅骨表面内侧的那些偶极子。
正向解的平均#
对一次实验的多个 run 做总平均的一种方法是先跨 run 对数据求平均,并相应地平均正演解。为此,mne.average_forward_solutions() 计算多个正演解的加权平均。该函数会同时对 MEG 和 EEG 正演解求平均。通常 EEG 正演解在各 run 之间是相同的,因为电极位置不会改变。
最小范数电流估计#
本节描述最小范数估计计算的数学细节。从贝叶斯角度看,在以下假设下,所得到的电流分布是最大后验(MAP)估计:
电流的可行位置被限制在皮层上。也可以选择将电流方向固定为垂直于皮层表面。
电流的幅值服从高斯先验分布,其源协方差矩阵已知。
测量数据包含加性噪声,该噪声服从协方差矩阵已知的高斯分布。噪声在时间上不相关。
逆算子的计算通过 mne.minimum_norm.make_inverse_operator() 和 mne.minimum_norm.apply_inverse() 完成。这些函数的用法在教程 使用 MNE、dSPM、sLORETA 和 eLORETA 进行源定位 中介绍。
线性逆算子#
源估计过程中的测量数据由 MEG 和 EEG 数据组成,共记录在 N 个通道上。任务是估计位于皮层上的共 \(Q\) 个源的强度。若源位置数目为 \(P\),则对于固定方向的源 \(Q = P\);若源方向不受约束,则 \(Q = 3P\)。由上述概率模型的正则化最大似然导出的正则化线性逆算子由 \(Q \times N\) 矩阵给出
其中 \(G\) 是将源强度与测得的 MEG/EEG 数据联系起来的增益矩阵,\(C\) 是数据噪声协方差矩阵,\(R'\) 是源协方差矩阵。这些矩阵的维度分别为 \(N \times Q\)、\(N \times N\) 和 \(Q \times Q\)。将 \(Q \times 1\) 的数据向量乘以 \(Q\),即可得到 \(Q \times 1\) 的源强度向量。
时刻 t 的电流幅值期望值则由 \(\hat{j}(t) = Mx(t)\) 给出,其中 \(x(t)\) 是包含时刻 t 测得的 MEG 和 EEG 数据值的向量。
为便于计算,线性逆算子不会被显式计算。数学细节请参见 解的计算,详细示例请参见 Calculating the inverse operator。
正则化#
在实践中,电流的先验方差是未知的。我们可以通过写成 \(R' = R/ \lambda^2 = R \lambda^{-2}\) 来表达这一点,由此得到逆算子
其中未知的电流幅值现在以正则化参数 \(\lambda^2\) 来解释。较大的 \(\lambda^2\) 值对应空间上更平滑、更弱的电流幅值,而较小的 \(\lambda^2\) 值则导致相反的结果。
我们也可以通过关于估计电流 \(\hat{j}\)(给定任意时刻 \(t\) 的测量向量 \(x\))最小化代价函数 \(S\) 来得到正则化线性逆算子,即
其中第一项是白化后的测量数据(参见 白化与缩放)与模型预测数据之差,第二项是电流估计的加权范数。可以看出,随着 \(\lambda^2\) 增大,源项的权重更大,从而可以容忍测量数据与预测数据之间更大的差异。
白化与缩放#
MNE 软件采用数据白化,因此“白化”后的逆算子具有以下形式
其中
是空间白化后的增益矩阵。将 (14) 中的 \(G\) 代入 (12),即可得到白化逆算子方程 (13):
期望的电流值为
已知 (13),并取
作为时刻 t 的白化测量向量。空间白化算子 \(C^{-^1/_2}\) 借助特征值分解 \(C = U_C \Lambda_C^2 U_C^\top\) 得到,即 \(C^{-^1/_2} = \Lambda_C^{-1} U_C^\top\)。在 MNE 软件中,噪声协方差矩阵以适用于原始数据的形式存储。为反映平均导致的噪声降低,该矩阵 \(C_0\) 会按平均次数 \(L\) 缩放,即 \(C = C_0 / L\)。
注意
当包含 EEG 数据时,在计算线性逆算子 \(M\) 时需要对增益矩阵 \(G\) 做平均参考。这一点在创建空间白化算子 \(C^{-^1/_2}\) 时已被纳入,该算子包含作用于数据的各种投影算子。EEG 数据的平均参考(使用投影算子)对于源建模是必需的,并会在计算逆算子时进行检查。
如上所示,逆解的正则化等价于改变贝叶斯先验分布中电流幅值的方差。
源协方差矩阵 \(R\) 的一个便利选择是使其满足 \(\text{trace}(\tilde{G} R \tilde{G}^\top) / \text{trace}(I) = 1\)。采用这一选择,我们可以近似 \(\lambda^2 \sim 1/\rm{SNR}^2\),其中 SNR 是白化数据的(幅值)信噪比。
注意
上面给出的信噪比与 \(\lambda^2\) 关系的定义对白化后的正演解很适用。在未白化的情况下,用迹比 \(\text{trace}(GRG^\top) / \text{trace}(C)\) 进行缩放没有意义,因为所求和的对角元素通常具有不同的量纲。例如,MEG 数据以 T 或 T/m 表示,而 EEG 的单位是伏特。
关于噪声协方差计算和白化的示例,请参见 计算协方差矩阵。
噪声协方差矩阵的正则化#
由于通常只能获得有限的数据来估计噪声协方差矩阵 \(C\),其估计值的最小特征值往往不准确,并且小于真实特征值。根据该问题的严重程度,以下量可能受到影响:
幸运的是,由于对估计进行了正则化,后两者最不容易受到影响。然而,在某些情况下,尤其是噪声协方差矩阵估计中的 EEG 部分可能存在问题,即它可能具有非常小的特征值,因此建议对噪声协方差矩阵进行正则化。
一直以来,MNE 软件通过将噪声协方差矩阵估计 \(C\) 替换为以下形式来实现正则化:
其中索引 \(k\) 遍历不同的通道组(MEG 平面梯度计、MEG 轴向梯度计和磁强计,以及 EEG),\(\varepsilon_k\) 是相应的正则化因子,\(\bar{\sigma_k}\) 是各通道组的平均方差,\(I^{(k)}\) 是对角矩阵,在对应于各通道组所含通道的位置上取值为 1。
关于计算和正则化通道协方差矩阵的详细信息,请参见 How should I regularize the covariance matrix?。
解的计算#
计算 MNE 最直接的方法是直接使用原始或白化逆算子的表达式。然而,为便于计算,我们更倾向于采用另一条途径,即使用以下矩阵的奇异值分解(SVD)
其中上标 \(^1/_2\) 表示 \(R\) 的平方根。对于对角矩阵,只需取 \(R\) 的平方根;而在更一般的情况下,可以使用 Cholesky 分解 \(R = R_C R_C^\top\),从而 \(R^{^1/_2} = R_C\)。
将 (17) 中的 SVD 与逆算子方程 (12) 结合,容易证明
其中对角矩阵 \(\Gamma\) 的元素为
可以看出,期望电流的表达式就是
其中 \(\bar{v_k} = R^{^1/_2} v_k\),\(v_k\) 是 \(V\) 的第 \(k\) 列。由此可见,电流估计是“加权”特征导联 \(v_k\) 的加权和。
容易看出 \(w(t) \propto \sqrt{L}\)。为了在 \(L\) 变化时保持关系 \((\tilde{G} R \tilde{G}^\top) / \text{trace}(I) = 1\),必须有 \(R \propto 1/L\)。采用这种方法,\(\lambda_k\) 与 \(L\) 无关;并且在 \(\lambda\) 固定时,可以直接看出 \(j(t)\) 与 \(L\) 无关。
最小范数估计在 mne.minimum_norm.make_inverse_operator() 中就是按此过程计算的,其用法在 Calculating the inverse operator 中说明。
噪声归一化#
噪声归一化有三个作用:
它将期望电流值转换为无量纲的统计检验变量。因此,所得随时间和位置变化的数值常被称为动态统计参数图(dSPM)。
它减小了估计的位置偏倚。特别是,消除了 MNE 偏好表层电流的倾向。
点扩散函数的宽度对源在皮层上位置的依赖变小。点扩散定义为位于皮层上某一点的电流源(电流偶极子)所产生的信号经 MNE 得到的结果。
在实践中,噪声归一化通过除以每个体素估计方差的平方根来实现。在计算这些噪声归一化因子时,方便的做法是将方程 (15) 中“加权特征导联”的定义以矩阵形式复用为
dSPM#
Dale 等人 [8] 提出的噪声归一化线性估计要求将期望电流幅值除以其方差。在实践中,这需要利用 SVD 方程 (13) 和 (22) 计算以下矩阵的对角元素:
由于这里只关心对角元素,我们可以按如下方式求出每个源的方差
在 解的计算 末尾所述条件下,与固定方向源相关的 t 统计量值因此与 \(\sqrt{L}\) 成正比,而用于自由方向源的 F 统计量则相应地与 \(L\) 成正比。
注意
MNE 软件通常计算 F 统计量的平方根,以便在膨胀皮层表面上显示。这些值也与 \(\sqrt{L}\) 成正比。
sLORETA#
sLORETA [9] 将电流方差估计为分辨率矩阵的对角元素,该矩阵是逆算子与正演算子的乘积。换言之,即(利用 (18)、(14) 和 (17))以下矩阵的对角元素
由于 \(R\) 是对角矩阵且我们只关心对角元素,我们可以按如下方式求出方差估计
eLORETA#
dSPM 和 sLORETA 求解的是作用于标准最小范数估计 \(\hat{j}(t)\) 的噪声归一化权重 \(\sigma^2_k\),而 eLORETA [10] 则求解能使定位偏倚为零的源协方差矩阵 \(R\)。对于固定方向解,所得矩阵 \(R\) 为对角矩阵;对于自由方向解,它将是具有 \(3 \times 3\) 块的分块对角矩阵。
在 [10] 中,式 2.13 指出可以用以下方程组求解权重,\(\forall i \in {1, ..., P}\)(注意,这里我们用本节的记号来表示该文中的方程):
可以用迭代算法求出满足这些方程的权重 \(r_i\) 的取值,具体如下:
将权重初始化为单位权重。
计算 \(N= \left( GRG^\top + \lambda^2C \right)^{-1}\)。
保持 \(N\) 不变,计算新权重 \(r_i = \left[ G_i^\top N G_i \right]^{-^1/_2}\)。
使用新权重返回步骤 (2),直至收敛。
特别地,对于步骤 (2),我们可以使用 (14) 中的替换,即:
然后,将 \(\tilde{N}\) 定义为 \(N\) 的白化版本,即 \(\tilde{G}R\tilde{G}^\top\) 的正则化伪逆,我们就可以按如下方式计算 \(N\):
在步骤 (3) 中,我们在左右两侧分别乘以 \(G\) 的子集,但作替换 (14) 后可以看到,我们等价地计算:
因此,为方便起见,我们永远不需要计算 \(N\) 本身,而可以改为计算其白化版本 \(\tilde{N}\)。
预测数据#
在无噪声条件下,SNR 为无穷大,从而 \(\lambda^2 = 0\),最小范数估计能完美解释测量数据。然而在实际情况中,\(\lambda^2 > 0\),测量数据与 MNE 预测的数据之间存在失配。比较预测数据(这里记为 \(x(t)\))与测量数据,可以为判断所用正则化是否正确提供有价值的线索。
在 SVD 方法中,我们容易得到
其中对角矩阵 \(\Pi\) 的元素为 \(\pi_k = \lambda_k \gamma_k\)。因此,预测数据被表示为 \(C^{^1/_2} U\) 中“重新着色后的特征场”的加权和。
皮层斑块统计#
如果在创建源空间时使用了 add_dists=True 选项,源空间文件将包含皮层表面每个顶点的皮层斑块统计量(CPS)。CPS 提供关于距该顶点最近的源空间点的信息,以及该顶点到该源空间点的距离。以某个源空间点为最近点的那些顶点,定义了与该源空间点相关联的皮层斑块。一旦有了这些数据,就很容易为每个源位置 \(d\) 计算以下皮层斑块统计量:
斑块内各顶点法向量的平均值 \(\bar{n_d}\),
斑块的面积 \(A_d\),以及
斑块内各顶点法向量相对其平均值的平均偏差 \(\sigma_d\),以度为单位。
mne.convert_forward_solution() 和 mne.minimum_norm.make_inverse_operator() 中的 use_cps 参数控制是否使用皮层斑块统计量(CPS)来定义法向方向(参见 Cortical surface reconstruction with FreeSurfer)。
方向约束#
一般认为,MEG 和 EEG 信号的主要来源是皮层锥体神经元的突触后电流。由于与这些微观事件相关的净初级电流方向垂直于皮层表面,因此在源估计中使用皮层法向方向作为约束是合理的。除了允许完全自由的源方向外,MNE 软件还基于表面法向数据实现了三种方向约束:
通过在
mne.minimum_norm.make_inverse_operator()中指定fixed=True,可以将源方向严格固定为表面法向方向。如果有皮层斑块统计量,则使用每个斑块的平均法向 \(\bar{n_d}\) 来定义源方向;否则使用源空间位置处的顶点法向。在调用
mne.minimum_norm.make_inverse_operator()时指定fixed=False和loose=1.0,即可采用与位置无关的固定松弛方向约束(fLOC)(参见 Loose dipole orientations)。这种方法使用基于源位置处局部表面朝向的源坐标系。默认情况下,与给定源位置相关联的增益矩阵 G 的三列,是指向正演计算所用坐标系(通常是 MEG 头部坐标系)\(x\)、\(y\) 和 \(z\) 轴方向的单位偶极子的场。对于 LOC,方向会被改变,使前两个源分量位于与源位置处表面法向垂直的平面内,第三个分量与其对齐。此后,与皮层表面相切的源分量的方差会按--loose选项定义的因子减小。在调用
mne.minimum_norm.make_inverse_operator()时指定fixed=False和loose参数,即可采用可变的松弛方向约束(vLOC)(参见 Limiting orientations, but not fixing them)。这与 fLOC 类似,区别在于loose参数给定的值会乘以上文定义的 \(\sigma_d\)。
深度加权#
最小范数估计存在偏向表层电流的偏倚。通过调整源协方差矩阵 \(R\) 使其偏向更深的源位置,可以减轻这一倾向。在 MNE analyze 采用的深度加权方案中,对应于第 \(p\) 个源位置的 \(R\) 元素会乘以一个因子
其中 \(g_{1p}\)、\(g_{2p}\) 和 \(g_{3p}\) 是 \(G\) 中对应于源位置 \(p\) 的三列,\(\gamma\) 是深度加权的阶数,通过 mne.minimum_norm.make_inverse_operator() 中的 depth 选项指定。
有效平均次数#
通常,待分析的 epoch 是各条件上的线性组合,而不是所计算的原始平均之一。如上所述,所计算的噪声协方差矩阵原本对应于原始数据。因此,必须对其进行正确缩放,以对应于待分析条件中实际或有效的 epoch 数目。一般来说,我们有
其中 \(L_{eff}\) 是有效平均次数。为了计算任意条件线性组合的 \(L_{eff}\)
我们利用如下事实:噪声协方差矩阵
由此得到
上述情况的一个重要特例是加权平均,其中
因此
人们常常计算加权和而不是加权平均,最简单的情形是两个类别的差或和。对于差,\(w_1 = 1\)、\(w_2 = -1\),因此
or
有趣的是,对于和也是如此,此时 \(w_1 = w_2 = 1\)。推广而言,对于和与差的任意组合,其中 \(w_i = 1\) 或 \(w_i = -1\),\(i = 1 \dotso n\),我们有
源估计的变形与平均#
为什么需要变形?#
现代神经影像技术,如源重建或 fMRI 分析,利用先进的数学模型和硬件将脑活动模式映射到受试者特定的解剖脑空间。这使得研究时空脑活动成为可能。时空脑数据的表示通常被映射到解剖脑结构上,以关联功能图与解剖图。这样,活动模式便叠加在推测产生该活动的解剖位置上。解剖 MR 图像常常直接用作“画布”,或被转换为膨胀的表面表示,以用于可视化。
为了计算组水平统计,必须将各受试者的数据表示形变到共同框架,使解剖和功能上相似的结构在所有受试者中都同样地表示在同一空间位置上。由于脑存在个体差异,morphing 便发挥作用,告诉我们受试者 A 产生的数据在受试者 B 的脑上会如何表示(反之亦然)。
变形映射#
MNE 软件借助 morphing 映射完成形变。形变借助配准后的球面(lh.sphere.reg 和 rh.sphere.reg)进行,这些文件必须在 FreeSurfer 中生成。morphing 映射是从受试者 A 的皮层表面数值(\(x^{(A)}\))到另一受试者 B 的相应数值(\(x^{(B)}\))的线性映射
其中 \(M^{(AB)}\) 是每行至多含三个非零元素的稀疏矩阵。这些元素按如下方式确定。首先,利用对齐后的球面,对每个顶点 \(x_j^{(B)}\),在受试者 A 的球面上找到包含位置 \(x_j^{(B)}\) 的三角形 \(T_j^{(A)}\)。接着,找出该三角形各顶点的编号,并设置 \(M^{(AB)}\) 第 j 行上相应的元素,使 \(x_j^{(B)}\) 成为反映其在三角形 \(T_j^{(A)}\) 内位置的三角形顶点值之间的线性插值。
由上述定义可知,一般而言
i.e.,
即使
即该映射几乎是双射。
关于平滑#
电流估计通常只在抽取后的网格上定义,该网格是皮层表面三角剖分中顶点的一个稀疏子集。因此,任何稀疏的数值集合都会被分配到相邻顶点上,以使可视化结果易于理解。这一过程传统上称为平滑(smoothing),但按照图像处理程序中的类似操作,更合适的名称可能是涂抹(smudging)或模糊(blurring)。
用 MNE 软件的术语来说,顶点数据的平滑是一个迭代过程:它在每一步迭代中应用一个稀疏模糊矩阵,从原始稀疏图像 \(x^{(0)}\) 生成模糊图像 \(x^{(N)}\):
矩阵 \(S^{(p)}\) 的每一行 \(j\) 上有 \(N_j^{(p - 1)}\) 个非零元素,其值等于 \(1/N_j^{(p - 1)}\)。这里 \(N_j^{(p - 1)}\) 是顶点 \(j\) 在迭代步骤 \(p - 1\) 时具有非零值的直接相邻顶点数。因此,矩阵 \(S^{(p)}\) 将非零邻居的平均值赋为顶点 \(j\) 的新值。该过程的一个重要特点是,它在模糊表面图像的同时倾向于保持幅值。
一旦 \(x^{(0)}\) 中非零顶点的索引以及三角剖分的拓扑结构固定下来,矩阵 \(S^{(p)}\) 也就固定,且与数据无关。因此,原则上可以构造一个复合模糊矩阵
然而,结果表明用迭代方式进行模糊在计算上更有效。上面关于 \(S^{(N)}\) 的公式也表明,涂抹(平滑)操作是线性的。
解码中的广义特征分解#
本节介绍广义特征分解(GED)的数学表述及其应用,它常用于空间滤波和源分离算法,例如 mne.decoding.CSP、mne.decoding.SPoC、mne.decoding.SSD 和 mne.decoding.XdawnTransformer。
GED 的核心原理是找出一组通道权重(空间滤波器),使两种数据特征之间的信号功率比最大化。这些特征由研究者定义,并由两个协方差矩阵表示:“信号”矩阵 \(S\) 和“参考”矩阵 \(R\)。例如,\(S\) 可以是任务时间区间数据的协方差,而 \(R\) 可以是基线时间区间的协方差。更多细节参见 [11]。
GED 的代数表述#
先给出一些定义:设 \(n \in \mathbb{N}^+\) 为通道数。设 \(\text{Symm}_n(\mathbb{R}) \subset M_n(\mathbb{R})\) 为实对称矩阵构成的向量空间。设 \(S^n_+, S^n_{++} \subset \text{Symm}_n(\mathbb{R})\) 分别为实半正定矩阵和正定矩阵的集合。设 \(S, R \in S^n_+\) 为由电生理数据 \(X_S \in M_{n \times t_S}(\mathbb{R})\) 和 \(X_R \in M_{n \times t_R}(\mathbb{R})\) 估计得到的协方差矩阵。
当 \(R\) 满秩(从而 \(R \in S^n_{++}\))时,可以对 \(S\) 和 \(R\) 进行 GED(或通过合同变换的联合对角化):
其中 \(W \in M_n(\mathbb{R})\) 是 \((S, R)\) 的特征向量构成的可逆矩阵,\(D\) 是特征值 \(\lambda_i\) 构成的对角矩阵。
每个特征向量 \(\mathbf{w} \in W\) 都是一个空间滤波器,它求解如下形式的优化问题:
也就是说,对时间序列 \(X \in M_{n \times t}(\mathbb{R})\) 使用空间滤波器 \(W\):
得到估计“源”的“激活”时间序列 \(A\),使得其方差之比 \(\frac{\text{Var}(\mathbf{w}^T X_S)}{\text{Var}(\mathbf{w}^T X_R)} = \frac{\mathbf{w}^T S \mathbf{w}}{\mathbf{w}^T R \mathbf{w}}\) 在按 \(\lambda_i\) 排序的空间滤波器 \(\mathbf{w}_i\) 上依次最大化。
主子空间中的 GED#
遗憾的是,取决于数据 \(X_R\),\(R\) 可能不满秩(例如由于平均参考、去除 PCA/ICA 成分等)。在这种情况下,可以在某个参考协方差 \(C_{ref}\) 的主子空间 \(Q = \operatorname{Im}(C_{ref}) \subset \mathbb{R}^n\) 中对 \(S\) 和 \(R\) 进行 GED(例如在共空间模式(CSP)算法中,\(C_{ref}=\frac{1}{2}(S+R)\),并对 S 和 R’=S+R 进行 GED)。
更形式化地说:设 \(r \leq n\) 为 \(C \in S^n_+\) 的秩。设 \(Q=\operatorname{Im}(C_{ref})\) 为 \(C_{ref}\) 的主子空间。设 \(P \in M_{n \times r}(\mathbb{R})\) 为由 \(Q\) 的标准正交基构成的等距映射。设 \(f:S^n_+ \to S^r_+\),\(A \mapsto P^t A P\) 为“限制”映射,它将二次型 \(q_A:\mathbb{R}^n \to \mathbb{R}\) 限制为 \(q_{A|_Q}:\mathbb{R}^n \to \mathbb{R}\)(在实际意义上,\(q_A\) 将空间滤波器映射为空间滤波后数据 \(X_A\) 的方差)。
于是,在 \(C_{ref}\) 的主子空间 \(Q\) 中对 \(S\) 和 \(R\) 进行 GED 的过程如下:
将 \(S\) 和 \(R\) 变换为 \(S_Q = f(S) = P^t S P\) 和 \(R_Q = f(R) = P^t R P\),使 \(S_Q\) 和 \(R_Q\) 成为限制后的 \(q_{S|_Q}\) 和 \(q_{R|_Q}\) 的矩阵表示。
对 \(S_Q\) 和 \(R_Q\) 进行 GED:\(S_Q W_Q = R_Q W_Q D\)。
通过 \(W = P W_Q \in \mathbb{R}^{n \times r}\) 将 \((S_Q, R_Q)\) 的特征向量 \(W_Q\) 变换回 \(\mathbb{R}^n\),从而得到 \(r\) 个空间滤波器。
注意,原优化问题的解得以保持:
除了限制之外,还可以基于白化后的 \(C_{ref}\) 对 \(q_S\) 和 \(q_R\) 进行重新缩放。此时,白化映射 \(f_{wh}:S^n_+ \to S^r_+\),\(A \mapsto P_{wh}^t A P_{wh}\) 将 \(A\) 变换为按 \(\Lambda^{-1/2}\) 重新缩放的 \(q_{A|Q}\) 的矩阵表示,其中 \(\Lambda\) 是 \(C_{ref}\) 的特征值构成的对角矩阵,因此 \(P_{wh} = P \Lambda^{-1/2}\)。
在 MNE-Python 中,限制映射的矩阵 \(P\) 可以用以下方式获得
_, ref_evecs, mask = mne.cov._smart_eigh(C_ref, ..., proj_subspace=True, ...)
restr_mat = ref_evecs[mask]
而 \(P_{wh}\) 则使用:
restr_mat = compute_whitener(C_ref, ..., pca=True, ...)